版本:v2.7
场景二:批量同步异构数据库数据(例:SQL Server到MySQL)
场景二:批量同步异构数据库场景(SQL Server到MySQL为例)
一、核心流程
二、核心操作步骤
- 创建或选择数据源 & 目的地,填写数据任务名称
- 若已存在想要选择的数据源 & 目的地,则直接选择,可选择一个数据源和多个数据目的地。
- 若还未创建数据源 & 目的地,可参照配置数据源 & 配置数据目的地 配置方法。
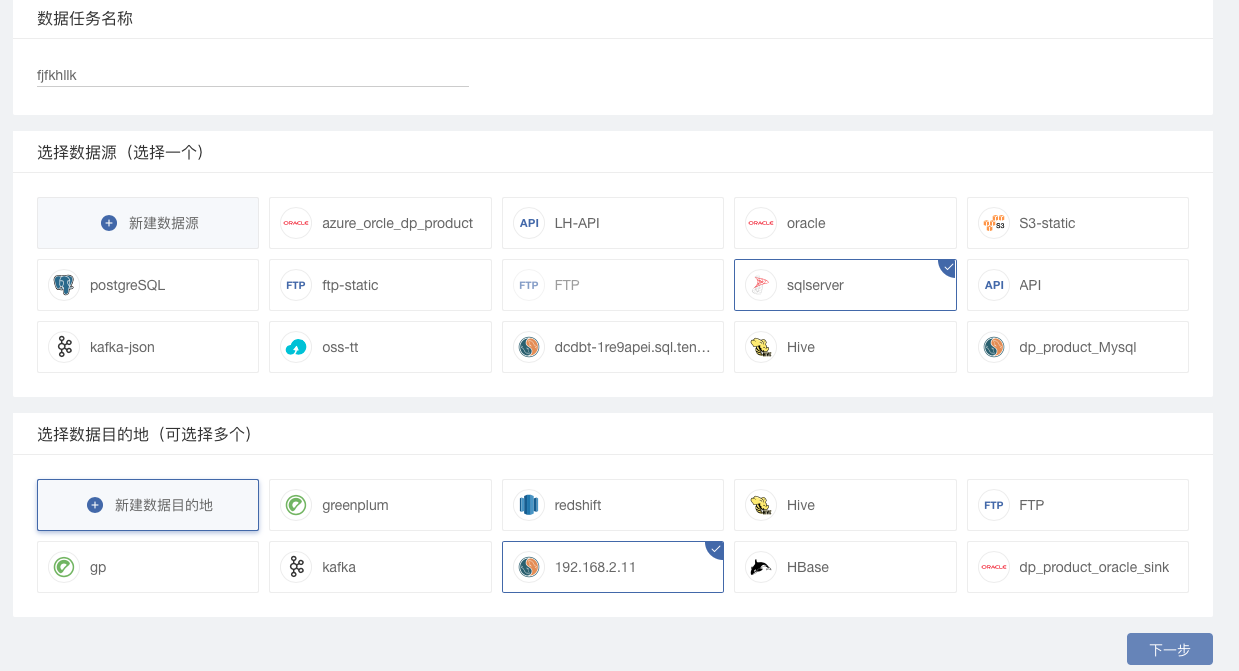
- 点击下一步,进入任务设置
任务设置主要包括了以下几个部分:
- 重要数据任务,可在任务设置页面设置重要任务星标
- 参与人:拥有该任务的浏览和编辑权限,可以查看数据任务的所有通知
- 数据源设置:包括选择数据源的读取方式,读取并发数量,读取速率限制,高级设置等,可根据数据的特性和用户的需求场景对数据读取进行相应设置
- 数据目的地设置:包括写入并发数量,处理速率限制,表和字段名称,高级设置等,可对数据写入进行设置
- 其他设置:包括错误队列设置和邮件通知设置
「数据源设置」
数据源资源组设置,设置当前任务读取端使用资源组,通过合理分配任务与资源组,可使重要任务计算资源得到保障。
读取方式:选择批量读取,在该选项下,需要选择读取频率。
- 定时读取:按照给定的时间间隔进行数据读取,需要设置定时时长。有两种方式,常规模式下可输入一个时间长度,如60秒;也可切换为 Cron 表达式。
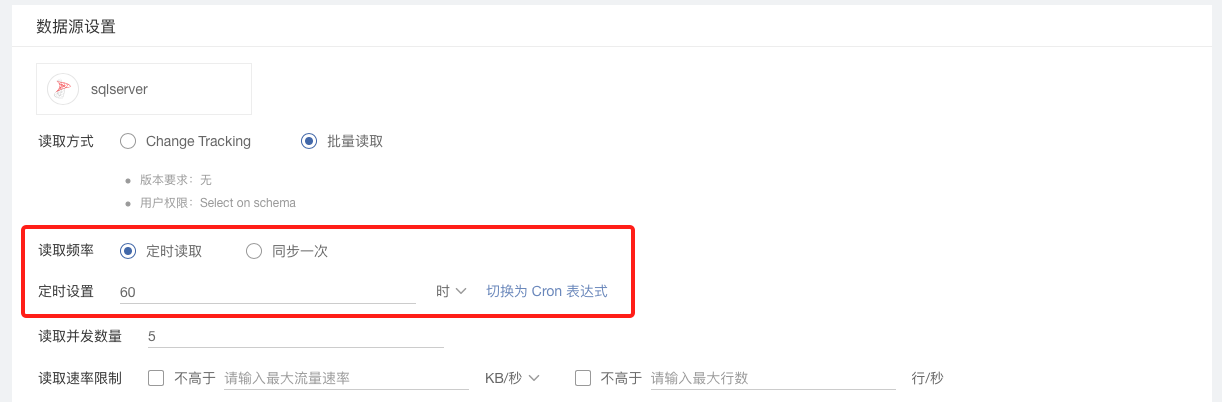
- 同步一次:无需设置时长,在任务开始后数据只同步一次。
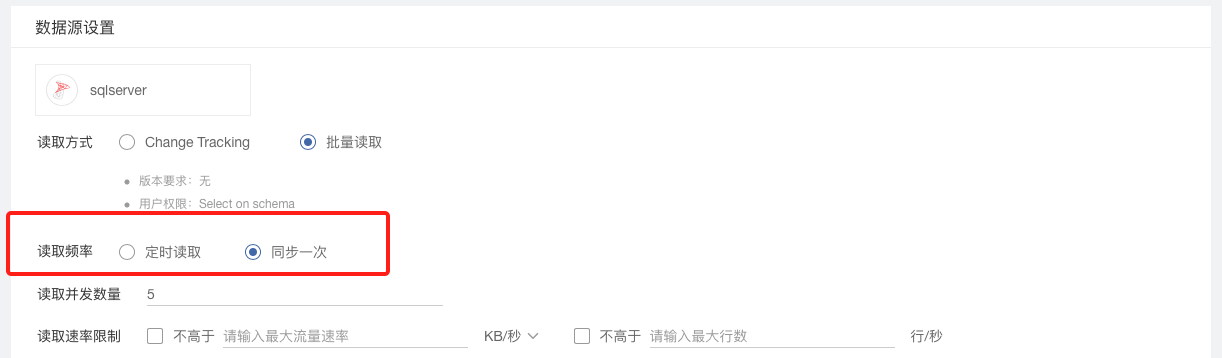
- 定时读取:按照给定的时间间隔进行数据读取,需要设置定时时长。有两种方式,常规模式下可输入一个时间长度,如60秒;也可切换为 Cron 表达式。
读取并发数量
- 读取并发数量是指该任务从数据源中并行读取表的数量,默认为5。
- 具体读取并发数量要根据数据源可接受请求量决定。
- 详细策略:并发数量代表着并行读取表的数量,当表读取完毕时系统会释放掉该线程,其他的表可继续抢占该线程进程数据的读取。任务暂停后又重启所有的表会重新抢占线程,系统会按照断点续传的方式继续同步新增数据。
读取速率限制
- 当用户设置读取速率限制,系统平均读取速率将不会超过该数值。
- 可按流量或行数作为限制条件。
- 用户能够不选、单选或多选,若同时勾选,两种限制将同时应用。
- 勾选后即可激活对应的速率限制,请输入正整数;
数据源高级设置包含:
- 传输队列最大缓存值
- 任务开始读取数据后,单个任务默认缓存10GB数据(读写数据量差),用户可自定义。
- 读写数据量差达到10GB(最大缓存值时),根据先进先出的原则,旧数据将会被回收。
- 当任务数据读写速率失衡,读写数据量差大于10GB(最大缓存值)时,将会出现部分数据被回收,未能成功写入数据目的地的情况。
- 传输队列回收时间
- 任务开始读取数据后,单个任务默认缓存3天数据,用户可自定义。
- 缓存数据达到回收时间,旧数据将会被回收。
- 当任务数据读写速率失衡,超过回收时间的数据尚未被写入到目的地,将会出现部分数据被回收,未能成功写入数据目的地的情况。
- 数据任务动态限速
- 开启后该数据任务读写数据量差达到「最大缓存值」,任务将会暂停数据读取工作。当实际缓存数据量小于「最大缓存值」时会重新开始读取数据。
- 可根据用户情况自定义「检查频率」
- 读取端事务一致性
- 传输队列最大缓存值
「数据目的地设置」
- 数据目的地资源组设置,设置当前任务读取端使用资源组,通过合理分配任务与资源组,可使重要任务计算资源得到保障。
- 写入并发数量
- 基本逻辑与「读取并发数量」一致。写入并发数量是指该任务从数据源中并行写入表的数量,默认为5。
- 具体写入并发数量要根据数据源可接受请求量决定。
- 写入速率限制
- 当用户设置写入速率限制,系统平均写入速率将不会超过该数值。
- 可按流量或行数作为限制条件。
- 用户能够不选、单选或多选,若同时勾选,两种限制将同时应用。
- 勾选后即可激活对应的速率限制,请输入正整数;
- 表和字段名称大小写
- 支持用户设置目的地表名称和字段名称大小写
- 选择【自定义】,任务执行后,系统会根据用户自定义的表和字段名称写入到目的地。
- 选择【全部大写】,任务执行后,系统会将用户设置的所有表和字段名称转换为大写(只包含英文)后写入到目的地。
- 选择【全部小写】,任务执行后,系统会将用户设置的所有表和字段名称转换为小写(只包含英文)后写入到目的地。
- 【每次定时执行批量同步前,允许清除目标表数据】选项
- 在选择了【定时读取】后,会在数据目的地设置中出现该选项
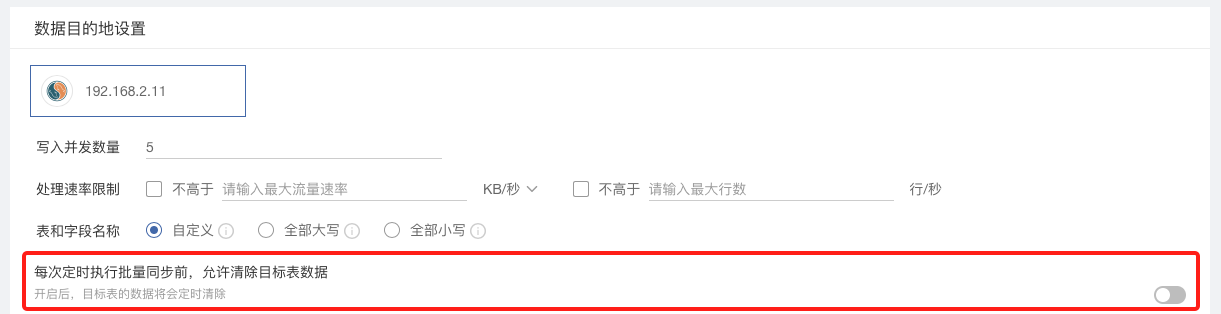
- 开启该选项后,每次执行定时任务时,在批量写入数据前,会先清除目标表的数据,关闭后则不清洗,直接写入。
- 在选择了【定时读取】后,会在数据目的地设置中出现该选项
- 目的地高级设置包含:
- 子任务设置
- batch条数、大小和时间代表一次性批量写入表的数据,三者满足一个条件即可生效。当达到用户设置的条数、大小或者时间时,系统会进行一批次地写入。对于设置数值的大小也应根据实际内存容量进行调整,因为当设置的值特别大时,会对内存空间造成一定的影响,如果没有开启动态限速,则读取数据会越来越多对于内存空间也占据越来越大,如果目的地无法及时消费的话,有可能造成数据丢失。
- 支持用户设置batch大小来进行批量任务的写入,开启后对全任务中的子任务生效(单表、单文件或数据),写入设置—高级设置相关项空缺时默认采用该全局设置
- 数据源变化设置
用户可在此处设置在数据任务同步过程中,数据源的表、字段变化的处理方式。- 数据源删除正在同步的表
已存在表被重命名,系统会认为表被删除,重命名的表识别为新表。- 选项一:继续同步其他表
- 选项二:暂停数据任务
- 同步的表字段被删除
重命名字段名称,系统会认为原始字段被删,发现新增字段。- 选项一:继续同步,目的地该字段传空值
- 选项二:继续同步,目的地该字段被删除
- 选项三:暂停数据任务
- 同步的表发现新增字段
- 选项一:继续同步新增字段
- 选项二:忽略新增字段
- 数据源删除正在同步的表
- 写入数据事务一致性
- 用户「关闭」该选项,DataPipeline 在写入数据过程中定期标记已写入数据的进度。因系统采用定时标记,当系统出现异常重启时,可能系统无法准确定位到具体的数据位置导致目的地有重复数据产生。
- 用户「开启」该选项,DataPipeline 在每次成功执行写入操作后会记录已写入数据的进度。以此来保证系统出现异常或者rebalance的情况时,根据系统明确的标记信息来保证目的地数据的一致性。
- 【批量读取后,先写入到临时表,再转存到实际表】选项
- 选择【批量读取】模式下,会在数据目的地设置 - 高级设置中出现该选项
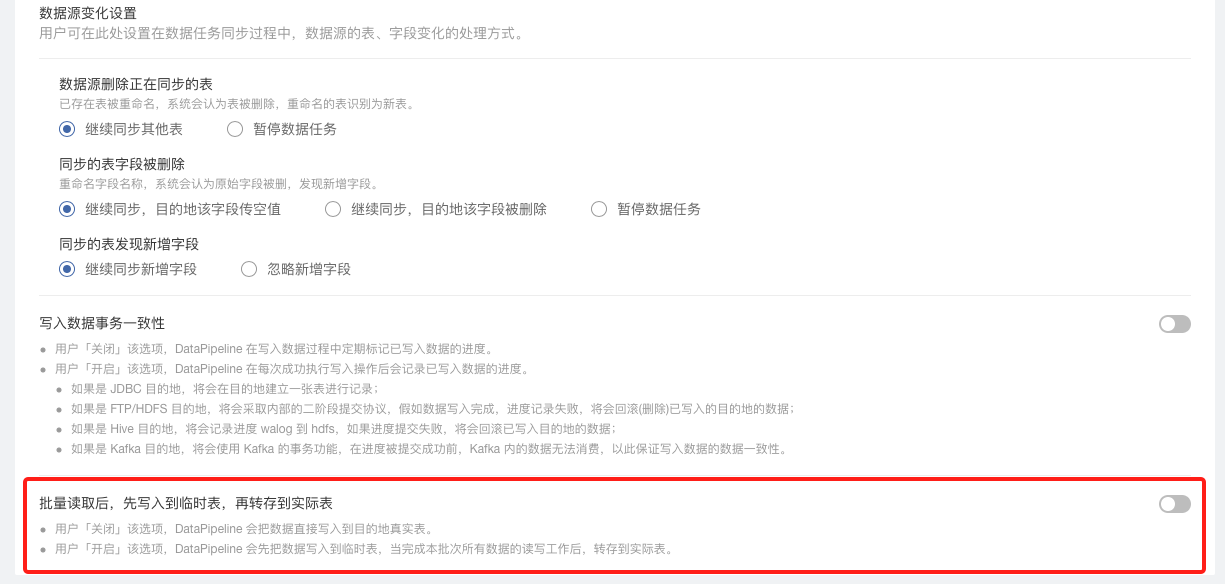
- 开启该选项后,在写入数据前,会先存到一个临时表,等待该批次数据全部读写完成,再写入实际表,以确保目的地数据正确。关闭该选项,则直接写入实际表。
- 选择【批量读取】模式下,会在数据目的地设置 - 高级设置中出现该选项
- 子任务设置
其他的任务设置选项可参见任务设置。
点击下一步,选择要同步的表
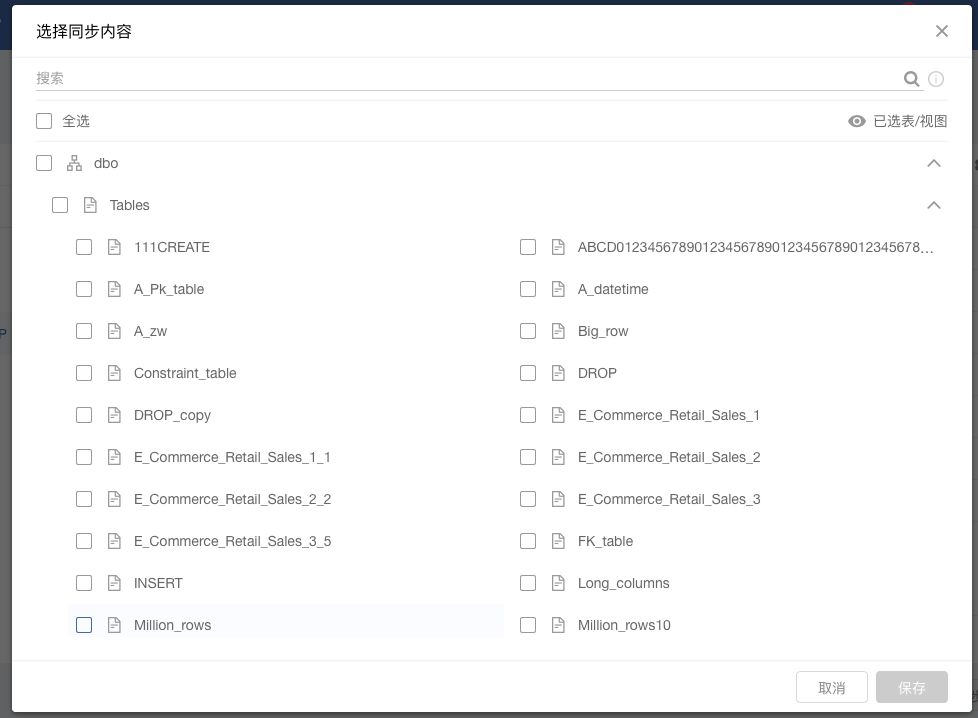
勾选需要的同步的表,点击保存读取设置
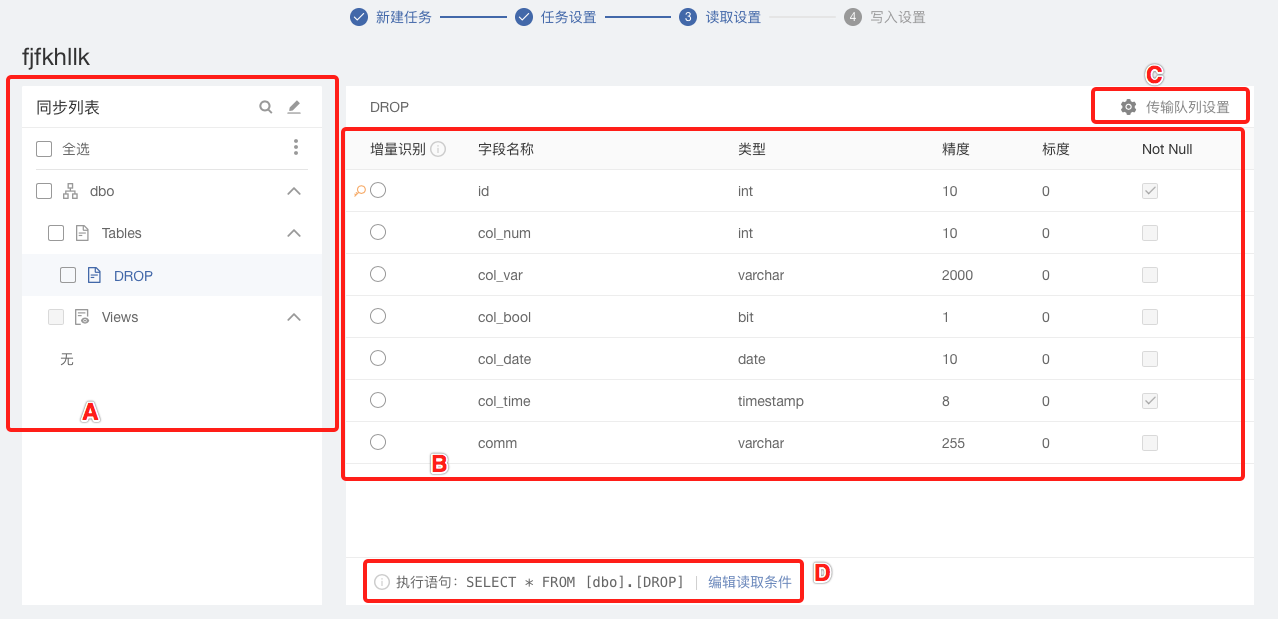
读取设置主要包括几个部分:
A.同步列表:用户选择的要同步的表
B.表结构:选中某个表后,会展示该表的字段名称、类型、精度、标度、Not Null等信息
C.传输队列设置:可对每个表单独进行设置,优先级高于任务设置中的传输队列设置
D.读取条件:可编辑where语句对数据进行筛选,符合条件的数据才会被读写
本实例的要注意的部分:
- 增量识别
- 选择【定时读取】后,会出现该选项。
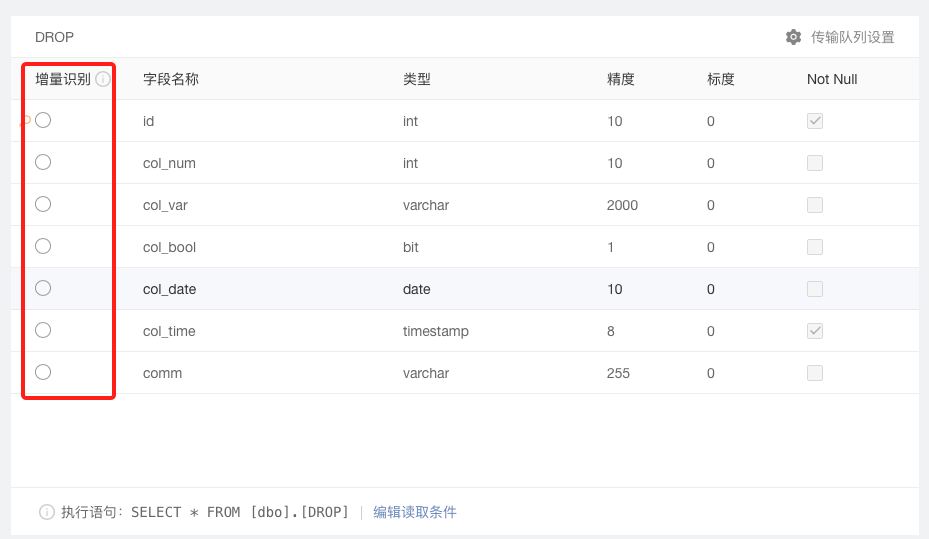
- 增量识别字段用于同步增量数据。
- 每次轮询以大于等于上一次轮询结果的最后一行此字段值作为查询条件,查询结果判断为增量数据。
- 选择的字段必须为可排序,例如数字或时间类型,推荐的字段类型一般为随数据更新而自增的字段,如:更新序列号(例:SequenceID)、更新时间戳(例:UpdatedAt)
- 若所选字段不符合以上推荐条件,可能会造成数据源更新数据无法被识别为增量数据或导致任务报错。
- 选择【同步一次】则不出现该选项
- 选择【定时读取】后,会出现该选项。
- 传输队列设置
与任务设置中的内容相同,任务设置中的传输对列和单表中的传输队列同时设置时,系统会优先采用单表级别的传输队列设置信息。 - 设置读取条件
- 增量识别 & 读取条件
- 默认是读取整个表的数据,若用户未选择增量识别字段也未自定义读取条件,则系统每次都会读取整个表的数据,系统会按照主键字段去重,若表没有主键则每次同步目的地会有重复数据。
- 用户可以选用增量识别字段或者自定义读取条件来读取增量数据,两个只能选择其一,当用户设置了增量识别字段又去设置了自定义读取条件时,系统默认会把增量识别字段标识去掉,按照自定义读取条件来读取增量。
- 每张表都显示增量识别字段,用户可以选择任意字段作为增量识别字段。
- 选择一个字段作为增量识别字段后,下放显示出具体的执行语句。
- 例如用户选择「_id」作为增量识别字段,执行语句显示为:SELECT * FROM table1 WHERE _id >= last_max(_id)
- 用户自定义执行语句
- 点击「编辑读取条件」,立即弹窗显示编辑窗口。
- 若用户已勾选增量识别字段则要求清空增量识别字段标识以及where语句,只保留where语句前半部分不允许更改的内容。
- 用户可以参照左侧的样例来输入自定义的读取条件。
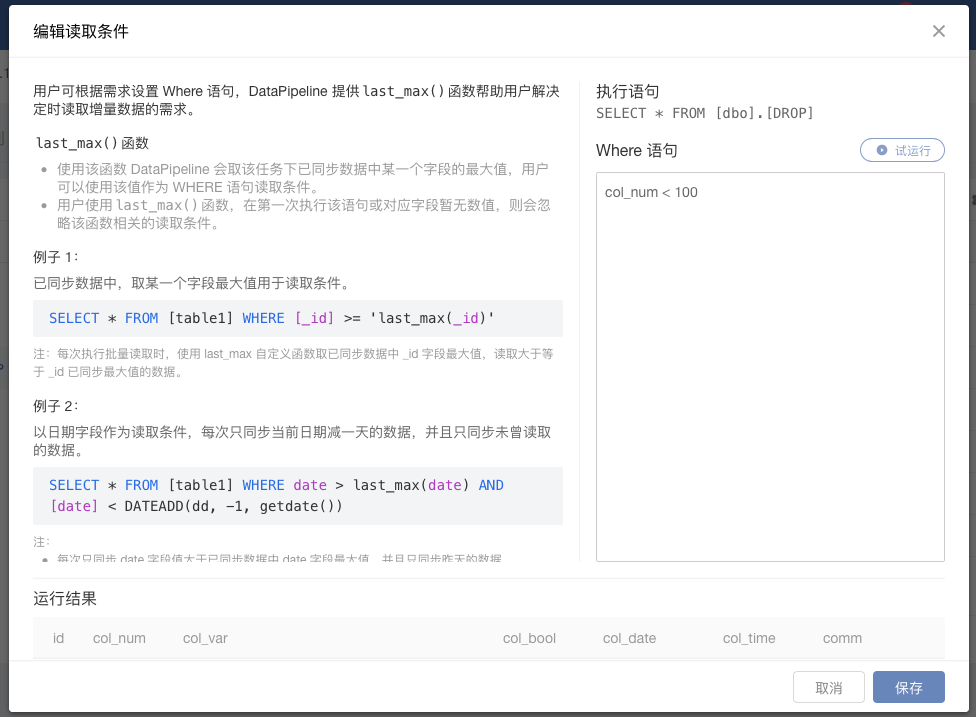
- 提供「试运行」按钮。
- 点击后执行当前sql语句,系统会返回增加 limit 10的结果供用户参考。
- 增量识别 & 读取条件
其他读取设置可参见读取设置
- 点击下一步,进入写入设置页面
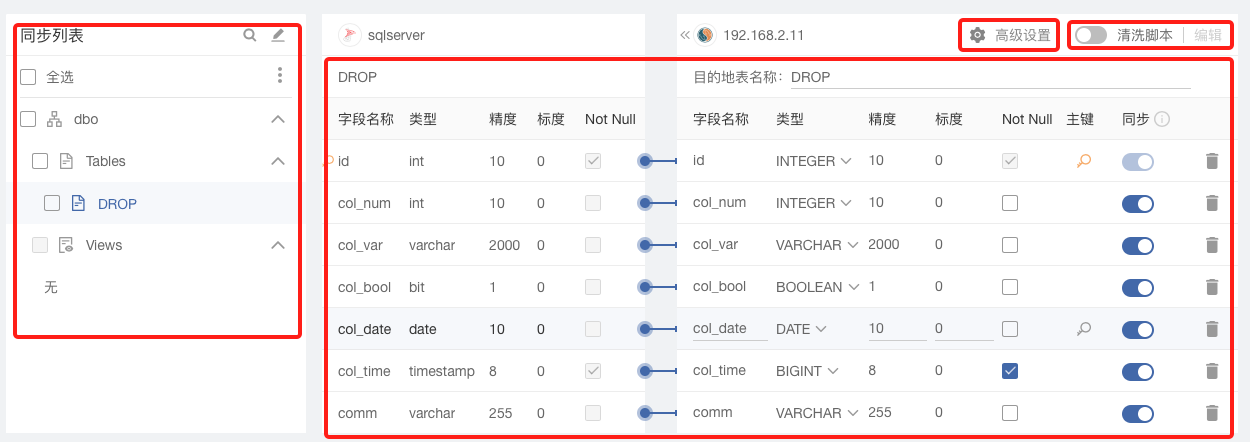
该页面主要包括:
- 同步列表:用户选择的要同步的表,可点击进行切换,对每个表的写入规则进行设置
- 映射列表:从数据源到目的地的映射详情,可对目的地表名、字段名、类型、精度、标度、Not Null、主键、是否同步字段等进行修改,可以添加和删除字段
- 高级设置:可以进行子任务Batch 设置,是单表级别的设置,优先级高于任务设置中的子任务设置
- 清洗脚本:可以开启后进行编辑,自定义对数据完成一些替换或清洗操作
本实例要注意的部分:
- 修改字段:
- 主键
- 目的表可设置多个主键,但不允许没有主键。
- 主键字段主要是用于目的地数据的去重。允许设置多个主键字段去重。不允许为空值。
- 支持删除目的地字段
- 删除字段后,用户激活数据任务,系统在创建目的地表时,不会创建该字段。
- 激活前允许用户去恢复字段,点击【恢复字段】,重新显示该字段
- 数据源新增字段与用户在激活任务前删除的字段同名,要求在该表底部新增一个同名字段,不覆盖当前的已被操作删除的字段。
- 支持新增目的地字段
- 点击【添加字段】,要求在目的地表最后一行新增一个字段,激活任务后该字段会被同步到目的地表中。
- 新增字段的数据来源要求用户在【高级清洗】逻辑中添加。比如:
- 增加字段【InsertTime】,该逻辑可在高级清洗逻辑中实现。
- 合并字段A+字段B值,该逻辑可在高级清洗逻辑中实现。
- Not Null
指该字段值不能为空,当用户勾选了not null,源端的字段为空时,系统会报错提示。 - 同步按钮
开启后同步该字段,关闭后目的地表有该字段,但不传任何值。
- 主键
- 清洗脚本
详细编辑方法及实例见设置清洗脚本
其他具体配置详情可参见写入设置
- 点击保存,进入立即激活页面
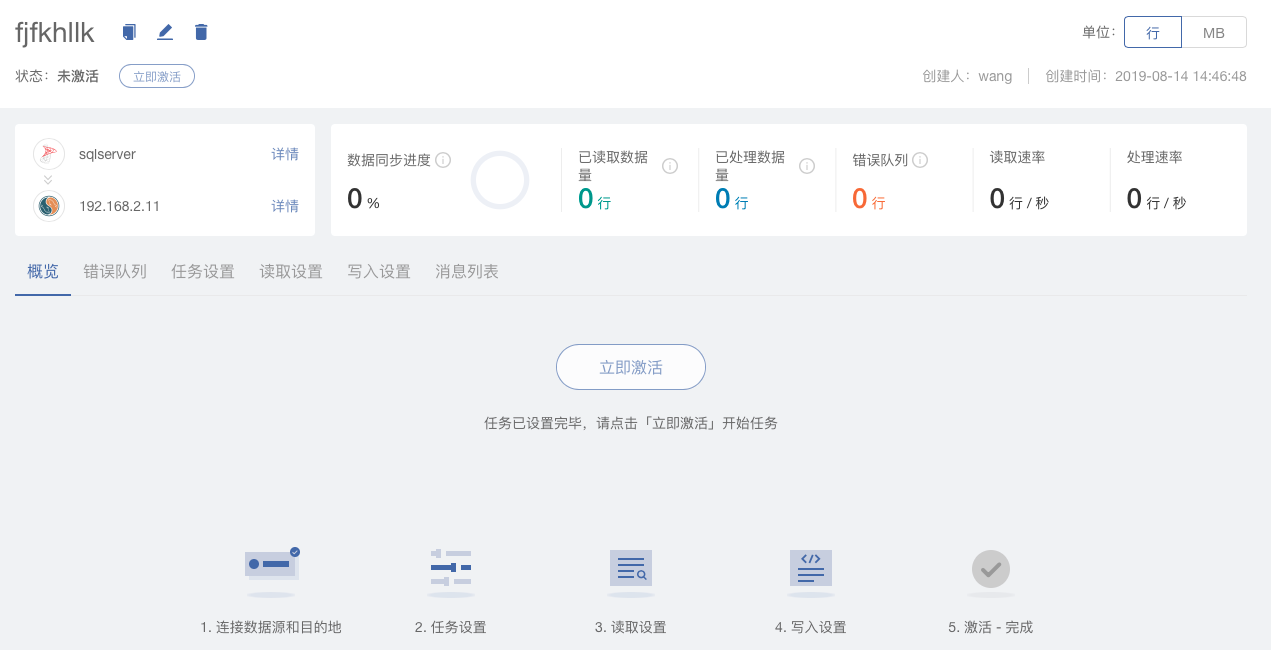
点击立即激活,则可开始数据同步任务。 - 管理数据同步任务
激活后,数据同步开始,可看到任务的同步情况。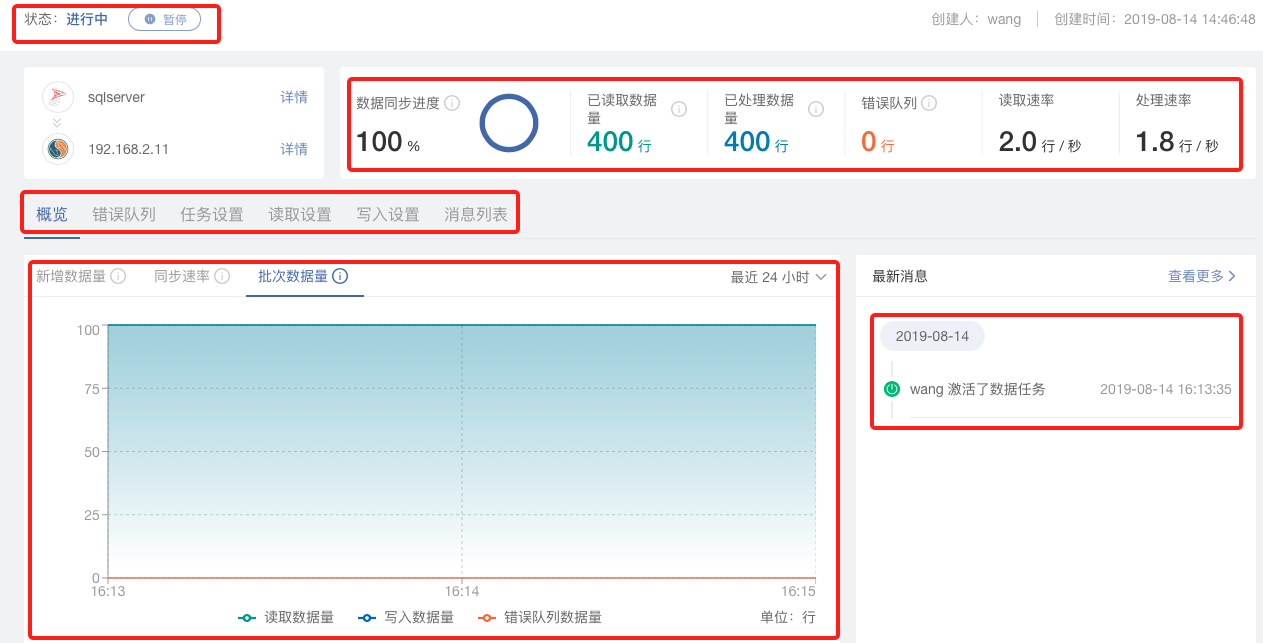
- 状态:数据任务的当前状态,可暂停
- 数据同步指标:包括同步进度、已读取数据量、已处理数据量、错误队列数量、读取速率、处理速率等指标
- 各Tab:包括概览、错误队列、任务设置、读取设置、写入设置、消息列表等tab,当前在概览tab下,可点击进行切换,查看各部分设置,暂停任务可修改部分设置
- 折线图:包括新增数据量、同步速率、批次数据量三个折线图,可以直观的看到三个指标的情况。当前在批次数据量的折线图下,由于任务设置为定时读取,时长为60s,可从横坐标看到,已经进行了16:13、16:14、16:15三个批次的读写任务
- 最新消息:任务的各消息通知,若出现异常等问题均可看到
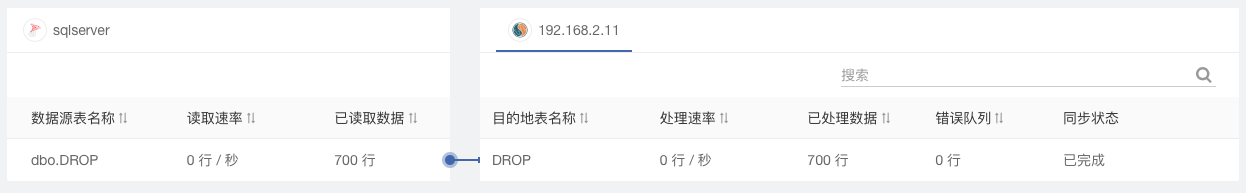
- 数据源/目的地同步情况:页面下方可看到该部分,展示了具体的某个数据源表到目的地表的同步情况。在选择多个表或者多个目的地时,可清晰的看到每一个表和目的地的同步情况。
其他详情可参见管理数据同步