版本:v2.7
数据同步的任务设置
任务设置
1.什么是「任务设置」?
在创建数据任务第二步中,用户已经对任务进行个性化的配置。在这个页面,用户可以在任务激活前后对一些通用配置进行灵活修改,实时调配任务的资源,设定通知等相关内容。
2.主要设置内容介绍
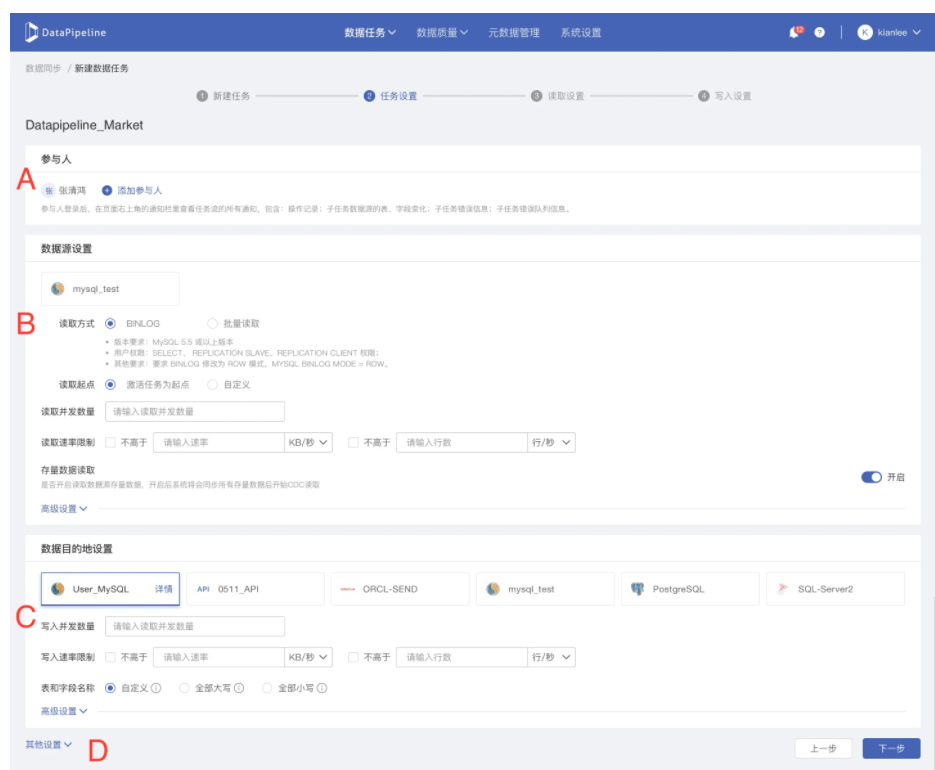
A. 「参与人」设置
- 「参与人」拥有该任务的浏览和编辑权限,并且会在通知中心收到该数据任务的所有通知,包含:
- 操作记录;
- 数据任务错误信息;
- 错误队列信息。
- 默认只显示该数据任务创建人,并且不允许删除。
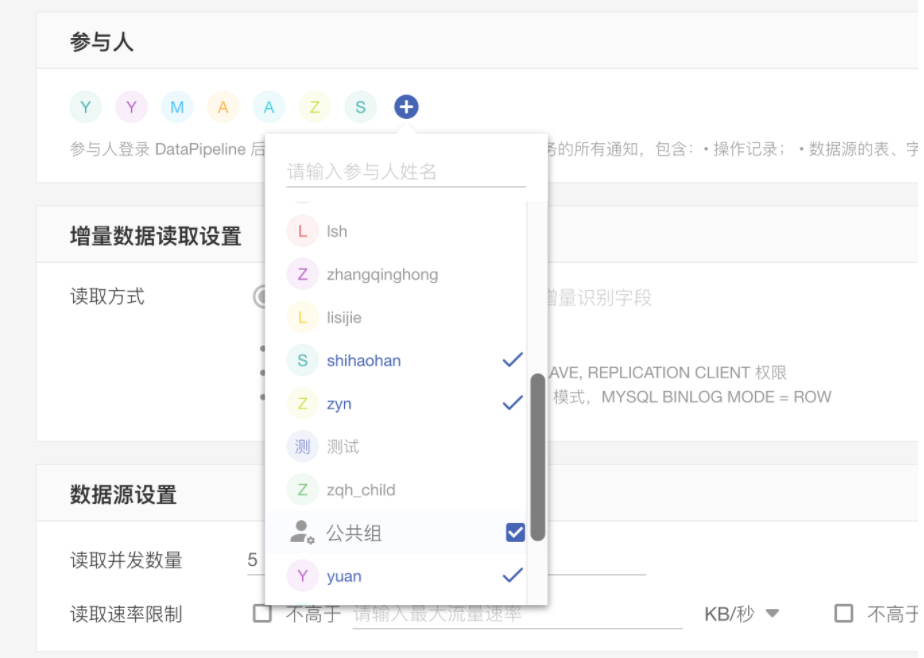
- 点击「+」按钮,将显示下拉框进行参与人选择。
- 支持单选或多选参与人或勾选用户组选择整个用户组的用户作为参与人;
- 再次点击取消选择;
- 支持搜索用户名称,直接在输入框输入用户名关键词即可,区分大小写。
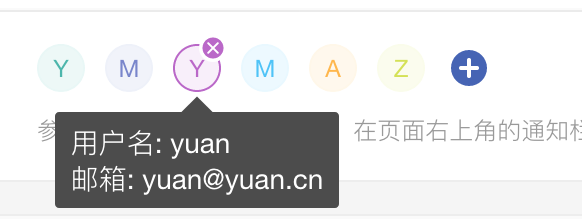
- 参与人列表中,鼠标移动到参与人上,将显示「×」按钮,点击后将删除该参与人。
B.「数据源设置」
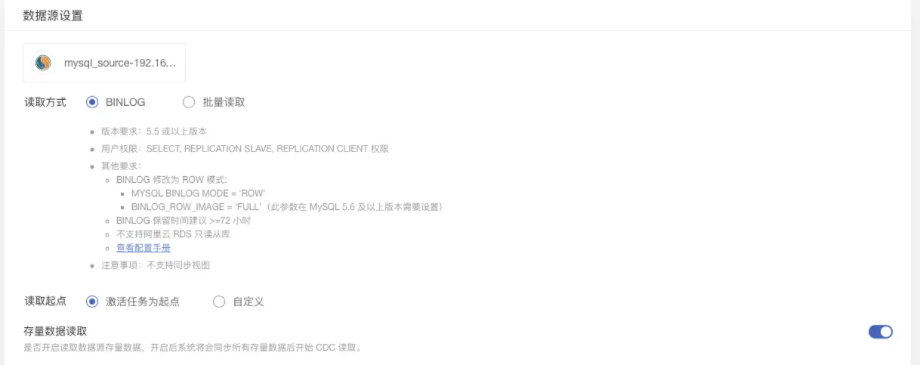
「读取方式」
读取方式:可选择实时模式或批量读取,默认勾选各个数据源的实时模式。
MySQL为Binlog、Oracle为Logminer、SQL Server为Change Tracking、Postgre SQL为wal2json或者decoderbufs
- 实时模式读取方式下会进行实时同步,用户可以选择读取起点和是否开启存量读取。
- 读取起点,用户可以选择从哪里开始读取数据,两个选项:激活任务为起点(默认)、自定义。
- 激活任务为起点,代表任务激活后系统将开始数据同步。
- 选择自定义,用户需要自定义设置读取的起始位置。
- 数据源为MySQL,需要输入Binlog Postion(必填)、Binlog文件名称(必填)、GTID(选填)
- 数据源为Oracle,需要输入「LogMiner scn 」(必填)
- 数据源为SQL Server,需要输入Change tracking version (必填)
- 数据源为PostgreSQL,需要输入lsn (必填)
- 存量数据读取
- 开启后系统会先读取存量再读取增量;
- 关闭后系统不会去存量而是会直接去读增量数据。
- 读取起点,用户可以选择从哪里开始读取数据,两个选项:激活任务为起点(默认)、自定义。
- 批量读取方式下会定时同步数据,需要设置读取频率,两个选项(单选):同步一次,定时读取
- 默认选择「定时读取」。选择定时读取后,要求用户输入读取频率,默认为 60秒,允许使用Cron表达式。
- 也可选择「同步一次」。表示该任务只同步一次数据源数据到目的地即可。(数据源为MySQL、Oracle、SQL Server、Postgre SQL 允许只同步一次)
- 当数据源为Oracle、SQL Server时,LogMiner和Change Tracking实时读取模式会采用定时查询方式读取增量,所以需要用户去设置一定的读取频率,用户设置读取频率越大相对来说数据延迟性也就越大,但读取频率过小时,会对系统造成一定的压力,因此,需要用户根据实际情况设置相对合理的读取频率,目前DataPipeline会默认读取频率为60秒。
「读取并发数量」
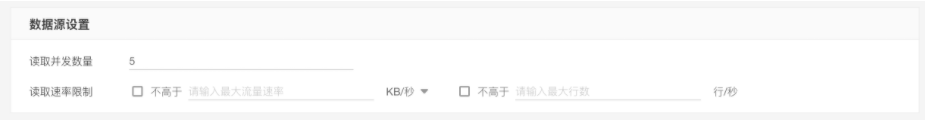
读取并发数量(支持 MySQL、Oracle、SQL Server 、PostgreSQL、Kafka、API、Hive数据源)
- 读取并发数量是指该任务从数据源中并行读取表的数量,默认为5。
- 具体读取并发数量要根据数据源可接受请求量决定。
- 并发数量代表着每次读取的表的数量,当表读取完毕时系统会释放掉该线程,其他的表可继续抢占该线程进程数据的读取。任务暂停后又重启所有的表会重新抢占线程,系统会按照断点续传的方式继续同步新增数据。
「读取速率限制」
- 当用户设置读取速率限制,系统平均读取速率将不会超过该数值。
- 可按流量或行数作为限制条件。
- 用户能够不选、单选或多选,若同时勾选,两种限制将同时应用。
- 勾选后即可激活对应的速率限制,请输入正整数;
- 支持两种速率限制:速率流量限制、速率行数限制;
- 流量限制:限制读取的最高流量速率;
- 默认单位为:KB/秒;
- 点击下拉框可切换单位:MB/秒。
- 行数限制:限制读取的最高行数速率;
- 默认单位:行/秒。
「高级设置」
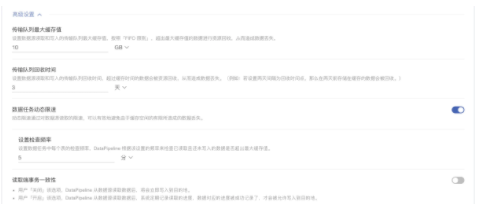
- 传输队列最大缓存值
- 任务开始读取数据后,单个任务默认缓存10GB数据(读写数据量差),用户可自定义。
- 读写数据量差达到10GB(最大缓存值时),根据先进先出的原则,旧数据将会被回收。
- 当任务数据读写速率失衡,读写数据量差大于10GB(最大缓存值)时,将会出现部分数据被回收,未能成功写入数据目的地的情况。
- 传输队列回收时间
- 任务开始读取数据后,单个任务默认缓存3天数据,用户可自定义。
- 缓存数据达到回收时间,旧数据将会被回收。
- 当任务数据读写速率失衡,超过回收时间的数据尚未被写入到目的地,将会出现部分数据被回收,未能成功写入数据目的地的情况。
- 数据任务动态限速
- 开启后该数据任务读写数据量差达到「最大缓存值」,任务将会暂停数据读取工作。当实际缓存数据量小于「最大缓存值」时会重新开始读取数据。
- 可根据用户情况自定义「检查频率」
- 读取端事务一致性
- 用户「关闭」该选项,DataPipeline 从数据源读取数据后,将会立即写入到目的地。
- 用户「开启」该选项,DataPipeline 从数据源读取数据后,系统定期记录读取的进度,数据对应的进度被成功记录了,才会被允许写入到目的地。以此来保证系统出现重启或者rebalance的情况时,根据系统明确的标记信息来保证目的地数据的一致性。
C. 「数据目的地设置」
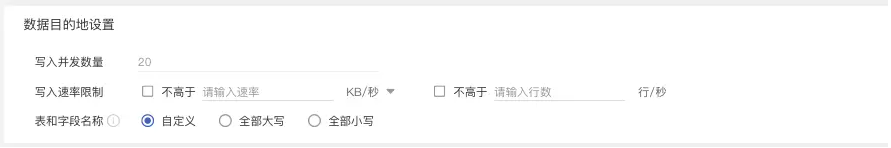
「写入并发数量」
- 写入并发数是指系统一次性写入表的数量,并发数量代表着每次写入的表的数量,当表写入完毕时系统会释放掉该线程,其他的表可继续抢占该线程进程数据的写入。
- 决定该任务的写入并发数,即同时写入数据表的数;
- 请输入正整数。
「写入速率限制」
- 写入速率限制是指系统限制每次写入表的最大流量和每秒写入的最大行数,当设置了写入表的最大流量时,则系统会限制写入表的流量低于用户设置的最大流量数;当设置了每秒写入的最大行数时,则系统限制每秒所写入的行数低于用户设置的最大行数。
- 支持两种速率限制:速率流量限制、速率行数限制;
- 流量限制:限制写入的最高流量速率;
- 默认单位为:KB/秒;
- 点击下拉框可切换单位:MB/秒。
- 行数限制:限制写入的最高行数速率;
* 默认单位:行/秒。 - 用户能够不选、单选或多选,若同时勾选,两种限制将同时应用。
- 勾选后即可激活对应的速率限制,请输入正整数;
「表和字段名称」
(目的地为Kafka时改为Topic和字段名称,FTP时改为文件名和字段名称)
- SQL类型数据源、FTP和S3静态支持设置目的地大小写; FTP和S3动态、API数据源是暂不支持设置目的地大小写;Hive和Redshift目的地也不支持设置目的地大小写。
- 支持用户设置目的地表名称和字段名称大小写
- 选项:自定义(默认)、全部大写、全部小写
- 鼠标浮在每个选项上提示用户
- 选择【自定义】,任务执行后,系统会根据用户自定义的表和字段名称写入到目的地。
- 选择【全部大写】,任务执行后,系统会将用户设置的所有表和字段名称转换为大写(只包含英文)后写入到目的地。
- 选择【全部小写】,任务执行后,系统会将用户设置的所有表和字段名称转换为小写(只包含英文)后写入到目的地。
「每次定时执行批量同步前,允许清除目标表数据」
- 数据源为SQL、API,数据目的地为SQL、Hive、TIDB、Redshift、Greenplum时,读取方式为批量定时读取时,显示该项。
- 点击开启,则每次定时批量读取时,系统都会先清除目标表的数据再进行写入
- 点击关闭,则每次定时批量读取时,系统不会清除目标表的数据会直接把每次批量的数据写入到目的地,系统会根据主键和增量识别字段来进行去重操作。
「高级设置」
高级设置包含了「子任务设置」、「数据源变化设置」、写入数据事务一致性。
「子任务设置」
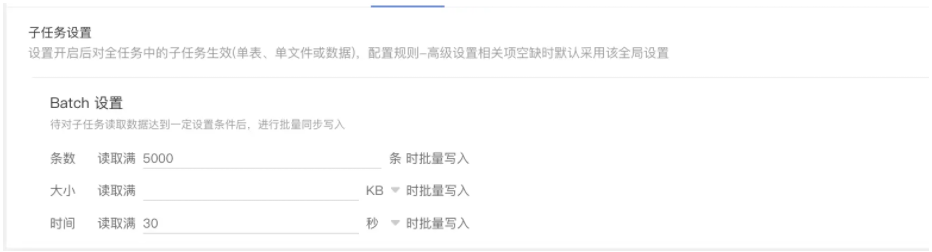
- batch条数、大小和时间代表一次性批量写入表的数据,三者满足一个条件即可生效。当达到用户设置的条数、大小或者时间时,系统会进行一批次地写入。对于设置数值的大小也应根据实际内存容量进行调整,因为当设置的值特别大时,会对内存空间造成一定的影响,如果没有开启动态限速,则读取数据会越来越多对于内存空间也占据越来越大,如果目的地无法及时消费的话,有可能造成数据丢失。
- 支持用户设置batch大小来进行批量任务的写入,开启后对全任务中的子任务生效(单表、单文件或数据),配置规则—高级设置相关项空缺时默认采用该全局设置
- batch设置
- 待对子任务读取数据达到一定设置条件后,进行批量同步写入。
- 条数类型显示“读取满____条时批量写入”,输入框数值默认为5000,允许用户修改,输入为空时提示“不能为空”。
- 大小类型显示,“读取满____KB/MB时批量写入”,KB和MB单位可在下拉栏切换,用户可选填,允许修改,可以为空。
- 时间类型显示“读取满____秒/分时批量写入”,默认为30秒,秒和分可在下拉栏切换,允许修改,输入为空时提示“不能为空”。
- 待对子任务读取数据达到一定设置条件后,进行批量同步写入。
- 条数和时间为必填项,不允许为空
- 大小为选填项,允许为空
「数据源变化设置」
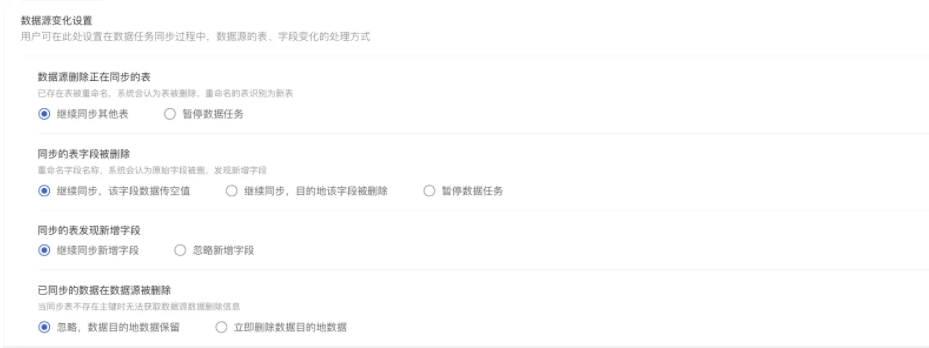
用户可在此处设置在数据任务同步过程中,数据源的表、字段变化的处理方式。
- 数据源删除正在同步的表
- 已存在表被重命名,系统会认为表被删除,重命名的表识别为新表。
- 选项一:继续同步其他表
- 选项二:暂停数据任务
- 已存在表被重命名,系统会认为表被删除,重命名的表识别为新表。
- 同步的表字段被删除
- 重命名字段名称,系统会认为原始字段被删,发现新增字段。
- 选项一:继续同步,目的地该字段传空值
- 选项二:继续同步,目的地该字段被删除
- 选项三:暂停数据任务
- 重命名字段名称,系统会认为原始字段被删,发现新增字段。
- 同步的表发现新增字段
- 选项一:继续同步新增字段
- 选项二:忽略新增字段
- 已同步的数据在数据源被删除
- 当同步表不存在主键时无法获取数据源数据删除信息。
- 选项一:忽略,数据目的地数据保留
- 选项二:立即删除数据目的地数据
- 当同步表不存在主键时无法获取数据源数据删除信息。
「数据源变化设置」根据数据源类型、目的地类型、读取范围、读取模式等的不同而有所变化。
| 数据源类型 | 目的地类型 | 读取方式 | 数据源变化支持类型 |
|---|---|---|---|
| SQL类型(mysql、oracle、sqlserver) | SQL类型/PostgreSQL/TIDB/Greenplum/Kafka/Redshift | 实时 | ①数据源删除正在同步的表 ②同步的表字段被删除 ③同步的表发现新增字段 ④已同步的数据在数据源被删除; |
| SQL类型(mysql、oracle、sqlserver) | SQL类型/PostgreSQL/TIDB/Greenplum/Kafka/Redshift | 批量读取 | ①数据源删除正在同步的表 ②同步的表字段被删除 ③同步的表发现新增字段 |
| SQL类型(mysql、oracle、sqlserver) | FTP、HDFS | 实时/批量读取 | 不支持 |
| SQL类型(mysql、oracle、sqlserver) | Hive | 实时/批量读取 | ①数据源删除正在同步的表②同步的表字段被删除 (不支持继续同步,目的地该字段被删除) ③同步的表发现新增字段 (写入格式为avro时不支持) |
| SQL类型(mysql、oracle、sqlserver) | HBase | 实时 | ①数据源删除正在同步的表 ②同步的表字段被删除 (不支持继续同步,目的地该字段被删除) ③同步的表发现新增字段 ④已同步的数据在数据源被删除; |
| SQL类型(mysql、oracle、sqlserver) | HBase | 批量读取 | ①数据源删除正在同步的表 ②同步的表字段被删除 (不支持继续同步,目的地该字段被删除) ③同步的表发现新增字段 |
| PostgreSQL | SQL类型/TIDB/Greenplum/Kafka/Redshift/HybridDB for PostgreSQL/Redshift | 实时 | ②同步的表字段被删除 ③同步的表发现新增字段 ④已同步的数据在数据源被删 |
| PostgreSQL | SQL类型/TIDB/Greenplum/Kafka/Redshift/HybridDB for PostgreSQL/Redshift | 批量读取 | ①数据源删除正在同步的表 ②同步的表字段被删除 ③同步的表发现新增字段 |
| PostgreSQL | FTP/HDFS | 实时/批量 | 不支持 |
| PostgreSQL | Hive | 实时 | ②同步的表字段被删除 (不支持继续同步,目的地该字段被删除) ③同步的表发现新增字段 |
| PostgreSQL | Hive | 批量读取 | ①数据源删除正在同步的表②同步的表字段被删除 (不支持继续同步,目的地该字段被删除) ③同步的表发现新增字段 (写入格式为avro时不支持) |
| PostgreSQL | HBase | 实时 | ②同步的表字段被删除 (不支持继续同步,目的地该字段被删除) ③同步的表发现新增字段 ④已同步的数据在数据源被删除; |
| PostgreSQL | HBase | 批量读取 | ①数据源删除正在同步的表 ②同步的表字段被删除 (不支持继续同步,目的地该字段被删除) ③同步的表发现新增字段 |
| Hive | SQL类型/TIDB/Greenplum/Kafka/Redshift/HybridDB for PostgreSQL/Redshift/Hive | 定时读取 | ③同步的表发现新增字段 |
| Hive | FTP、HDFS | 定时读取 | 不支持 |
| FTP、Kafka、API、S3、OSS | 所有目的地 | 不支持 |
「 写入数据事务一致性」
- 用户「关闭」该选项,DataPipeline 在写入数据过程中定期标记已写入数据的进度。因系统采用定时标记,当系统出现异常重启时,可能系统无法准确定位到具体的数据位置导致目的地有重启数据产生。
- 用户「开启」该选项,DataPipeline 在每次成功执行写入操作后会记录已写入数据的进度。以此来保证系统出现异常或者rebalance的情况时,根据系统明确的标记信息来保证目的地数据的一致性。
- 如果是 JDBC 目的地,将会在目的地建立一张表进行记录;
- 如果是 FTP/HDFS 目的地,将会采取内部的二阶段提交协议,假如数据写入完成,进度记录失败,将会回滚(删除)已写入的目的地的数据;
- 如果是 Hive 目的地,将会记录进度 walog 到 hdfs,如果进度提交失败,将会回滚已写入目的地的数据;
* 如果是 Kafka 目的地,将会使用 Kafka 的事务功能,在进度被提交成功前,Kafka 内的数据无法消费,以此保证写入数据的数据一致性。
「 批量读取后,先写入到临时表,再转存到实际表」
- 支持的目的地有:MySQL、SQL Server、Oracle、TiDB、AnalyticDB for PostgreSQL、Reshift、Greenplum
- 用户「关闭」该选项,DataPipeline 会把数据直接写入到目的地真实表。
- 用户「开启」该选项,DataPipeline 会先把数据写入到临时表,当完成本批次所有数据的读写工作后,转存到实际表。
D. 「其他设置」
「错误队列设置」
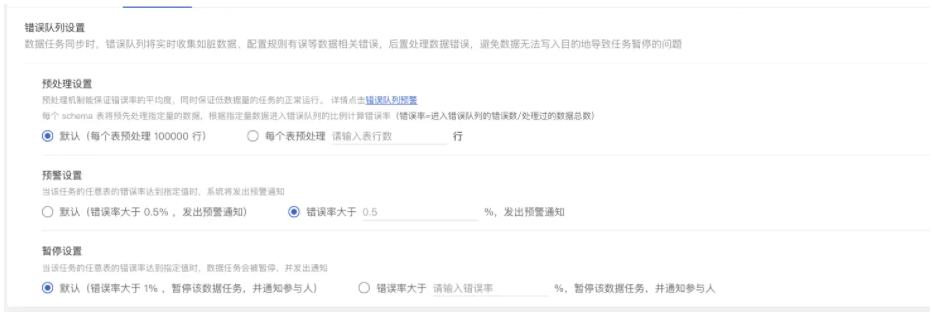
数据任务同步时,错误队列将实时收集如脏数据、配置规则有误等数据相关错误,后置处理数据错误,避免数据无法写入目的地导致任务暂停的问题。
- 支持设置预处理的数据行数(默认为100000行)
- 预处理机制能保证错误率的平均度,同时保证低数据量的任务的正常运行。
- 每个 schema 表将预先处理指定量的数据,根据指定量数据进入错误队列的比例计算错误率(错误率=指定数据量中进入错误队列的错误数/指定的数据量);该批次错误率计算后进行下一批次的计算。
- 支持用户自定义设置该任务每个表预处理的条数,直接在输入框输入即可。
- 支持设置预警的百分比(默认为0.5%)
- 当该任务的任意表的错误率达到指定值时,系统将发出预警通知;
- 支持用户自定义设置该任务触发预警通知的错误率,直接在输入框输入即可。
- 支持设置暂停数据任务的百分比(默认为1%)
- 当该任务的任意表的错误率达到指定值时,数据任务会被暂停,并发出通知;
- 支持用户自定义设置该任务触发任务暂停的错误率,直接在输入框输入即可。
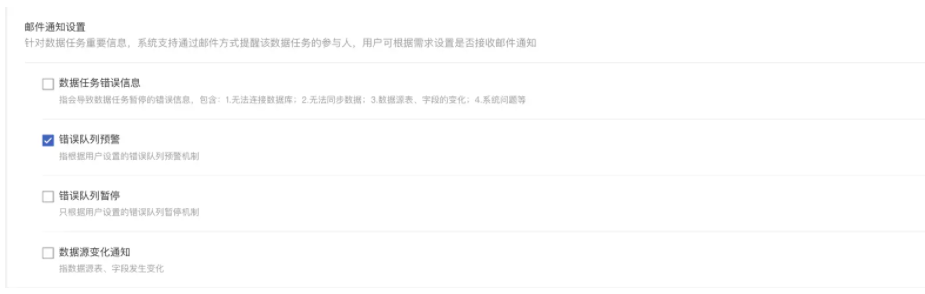
「邮件通知设置」
- 支持用户设置哪些信息需要通过邮件提醒用户(默认勾选全部)
- 数据任务错误信息
- 当发生导致数据任务暂停的错误时,您将受到邮件通知,包括:
1.无法连接数据库;
2.无法同步数据;
3.系统问题等。
- 当发生导致数据任务暂停的错误时,您将受到邮件通知,包括:
- 错误队列预警
- 当错误队列达到预警错误率您将收到邮件通知。
- 错误队列暂停
- 当错误队列达到暂停错误率您将收到邮件通知。
- 数据任务错误信息