版本:v2.7
场景五:关系型数据库数据同步到Hive(例:Oracle到Hive为例)
场景五:关系型数据库数据同步到Hive目的地(Oracle到Hive为例)
一、核心流程
创建数据源 & 目的地
任务设置
读取设置
写入设置
管理数据任务
二、 创建数据源

- 以Oracle批量读取为例,支持实时读取(LogMinner、Agent)、批量读取的方式
- 单个数据任务只允许选择一个数据库类型作为数据源
- 关系型数据库目前支持「MySQL」、「Oralce」、「SQL Server」、「PostgreSQL」作为数据源。
详情见:配置数据源
三、创建数据目的地
详情见:配置Hive数据目的地
四、任务设置
- 确定读取端和写入端数据库后,点击「下一步」,进入任务设置。
- 如该任务为重要数据任务,您可在任务设置页面设置重要任务星标。
- 用户需要设置:参与人、数据源设置、数据目的地设置、其他设置
参与人设置
- 「参与人」拥有该任务的浏览和编辑权限,并且会在通知中心收到该数据任务的所有通知,包含:
- 操作记录;
- 数据任务错误信息;
- 错误队列信息。
- 数据源变化设置
数据源设置
- 设置当前任务数据源使用资源组,通过合理分配任务与资源组,可使重要任务计算资源得到保障。
- 设置读取方式,以Oracle数据库为例,会提供两种读取方式:实时模式 & 批量读取
详情见:Oracle读取设置
数据目的地设置
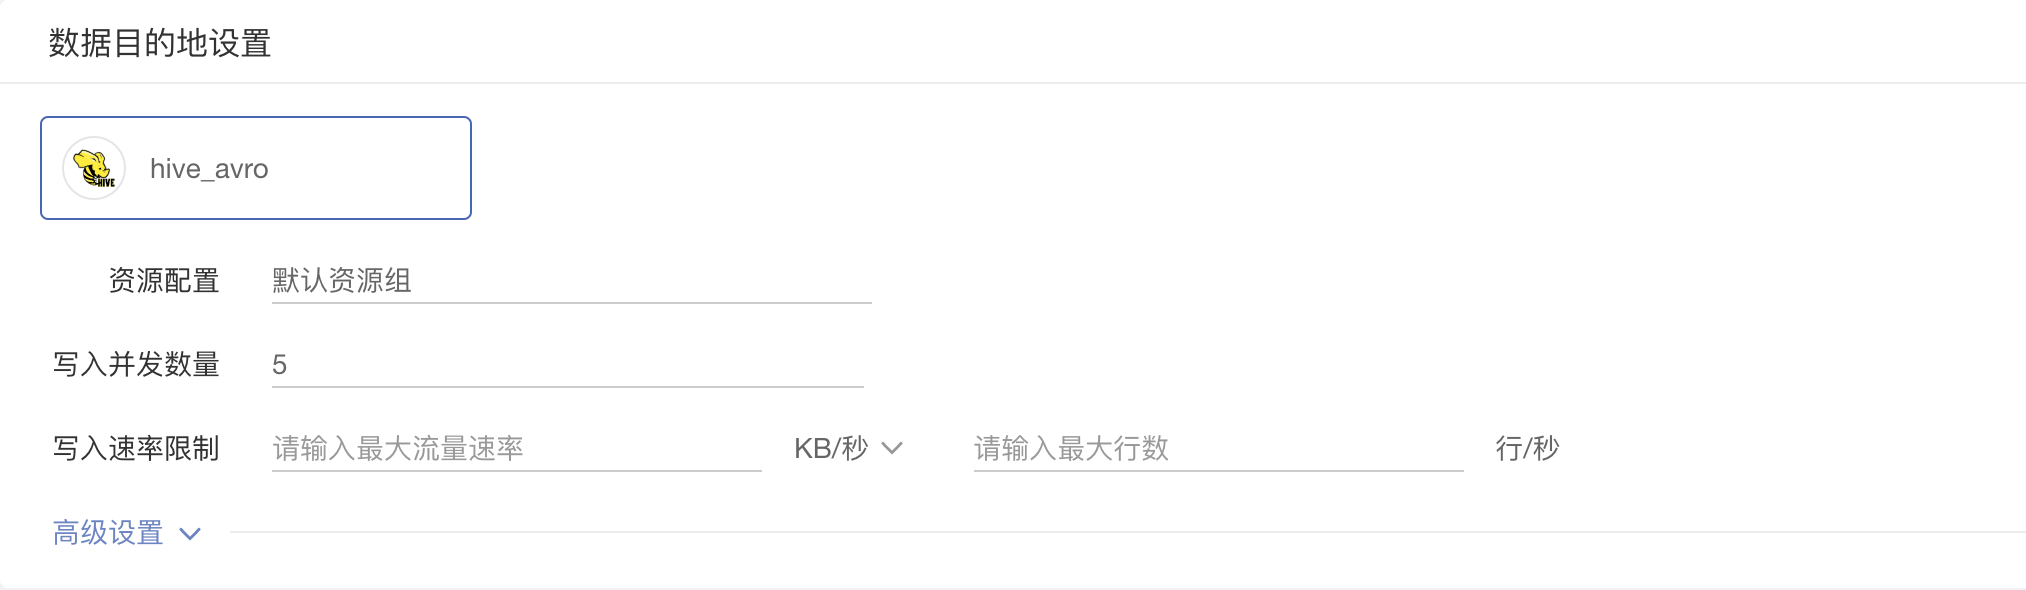
- 设置当前任务数据目的地使用资源组,通过合理分配任务与资源组,可使重要任务计算资源得到保障。
其他设置
五、读取设置
 进入读取设置页面,用户首先需要选择读取对象,保存后即可看到上图页面。
同步列表
- 读取列表显示该任务实时读取的表,点击任一表名称右侧显示该表的表结构。
- 提供搜索功能,主要支持搜索表名称。
- 点击「编辑」,可重新选择读取对象。
- 提供「批量设置」功能,包括:批量移除读取对象,批量设置执行语句。详情见:批量功能
传输队列设置
详情见:读取设置
读取条件设置
详情见:SQL类型数据源读取条件设置
六:写入设置

写入列表
- 写入列表显示本次任务中,哪些数据源表会写入到该目的地。
- 提供搜索功能,主要支持搜索表名称。
- 点击「编辑」,可重新选择写入对象。
- 提供「批量设置」功能,包括:
- 批量移除读取对象。
- 批量设置表名称(主要用于多表同结构数据往目的地一张表写入场景)。
详情见:批量功能
目的地表结构设置
- 点击任一表名称右侧显示每个目的地表的映射关系(左侧是数据源表结构)。
- 若数据目的地没有同名表,激活任务后DataPipeline会在目的地创建新表。
- 若目的地已存在同名表,目的地表名称右侧会有提示。
- 若该任务往已创建的同名表写入数据,会检查表结构是否一致。
- 若表结构一致(只检查字段名,不检查字段类型和其他属性),则正常写入数据。
- 若表结构不一致(少字段或多字段),则强制改为用户设置的表结构后再进行数据同步。
- 若该任务往已创建的同名表写入数据,会检查表结构是否一致。
- 目的地表结构用户可修改字段名称、类型、唯一键等属性
七、数据任务详情页
「数据任务统计」
- 已读取数据量:
- 指 DataPipeline 从数据源已读取的数据量。
- 当 DataPipeline 系统重启,会根据断点续传机制从上一次读取记录点开始重新读取数据,重复读取的数据量不会记录到已读取数据量里。
- 无主键的定时同步时全量替换数据,故每次定时读取全量数据,数据源没有更新的数据会再次读取。
- 已处理数据量:
- 指 DataPipeline 已处理的数据量,这里包括:同步到数据目的的数据量和进入到错误队列的数据量。
- 当 DataPipeline 系统重启,会根据断点续传机制从上一个读取记录点开始重新写入部分数据,但这部分数据不会记录到已写入数据量里。
- 错误队列:指已读取的数据中系统判断无法写入到数据目的地,而异步放到错误队列中的数据量。:
- 读取速率:指DataPipeline从数据源读取数据的速率。
- 处理速率:指DataPipeline处理数据的速率
「复制任务」
详情见:复制任务
「错误队列」
详情见:错误队列
「消息列表」
详情见:消息列表
「回滚功能」
详情见:回滚功能
「重新同步」
详情见:重新同步功能