版本:v2.7
场景四:Hive数据同步到关系型数据库(例:Hive到SQLServer)
场景四:Hive数据同步到关系型数据库(Hive到SQL Server为例)
一、核心流程
创建数据源 & 目的地
任务设置
读取设置
写入设置
管理数据任务
二、创建数据源Hive
- 单个数据任务只允许选择一个数据库类型作为数据源
- 新建数据源Hive,详情见:配置Hive数据源
三、创建数据目的地
单个数据任务允许选择多个数据库作为数据目的地。
- Hive数据源支持同步到所有已支持的数据目的地
- 关系型数据库目前支持「MySQL」、「Oralce」、「SQL Server」、「 AnalyticDB for PostgreSQL」、「TiDB」作为数据目的地。
- 具体可参见:配置数据目的地
- 当存在已有数据目的地时,选择已经支持的目的地即可。
四、任务设置
用户需要设置:重要任务设置、参与人、数据源设置、数据目的地设置、其他设置
重要任务设置
参与人设置
「参与人」拥有该任务的浏览和编辑权限,并且会在通知中心收到该数据任务的所有通知,包含:
数据源设置
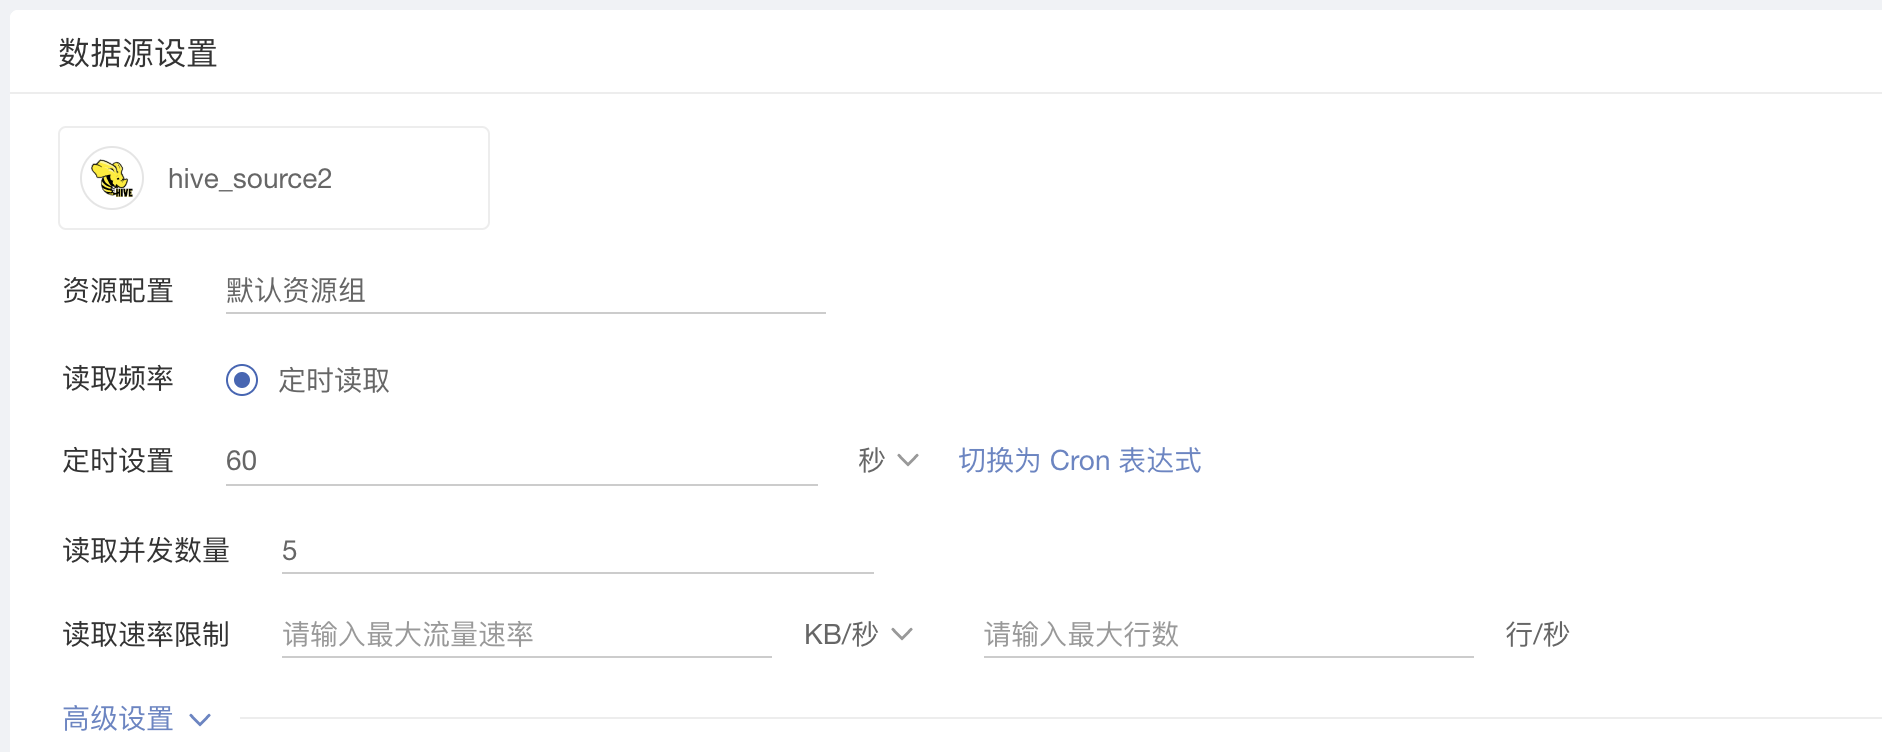
- 设置当前任务读取端使用资源组,通过合理分配任务与资源组,可使重要任务计算资源得到保障。
- 读取频率:定时读取
- 定时设置:用户可以设置读取间隔时间,支持cron表达式。需要注意的地方:如果在用户设置的期间内没有完成读写操作,则系统会等到写入完成后才会开启下次读取。如果在用户设置的期间内完成了读写操作,则系统会按照用户设置的定时设置间隔开启下次读取。
- 读取并发数量
- 读取并发数量是指该任务从数据源中并行读取表的数量,默认为5。
- 具体读取并发数量要根据数据源可接受请求量决定。
- 详细策略:并发数量代表着并行读取表的数量,当表读取完毕时系统会释放掉该线程,其他的表可继续抢占该线程进程数据的读取。任务暂停后又重启所有的表会重新抢占线程,系统会按照断点续传的方式继续同步新增数据。
- 读取速率限制:
- 当用户设置读取速率限制,系统平均读取速率将不会超过该数值。
- 可按流量或行数作为限制条件。
- 用户能够不选、单选或多选,若同时勾选,两种限制将同时应用。
- 勾选后即可激活对应的速率限制,请输入正整数;
数据源高级设置包含:
- 传输队列最大缓存值
- 任务开始读取数据后,单个任务默认缓存10GB数据(读写数据量差),用户可自定义。
- 读写数据量差达到10GB(最大缓存值时),根据先进先出的原则,旧数据将会被回收。
- 当任务数据读写速率失衡,读写数据量差大于10GB(最大缓存值)时,将会出现部分数据被回收,未能成功写入数据目的地的情况。
- 传输队列回收时间
- 任务开始读取数据后,单个任务默认缓存3天数据,用户可自定义。
- 缓存数据达到回收时间,旧数据将会被回收。
- 当任务数据读写速率失衡,超过回收时间的数据尚未被写入到目的地,将会出现部分数据被回收,未能成功写入数据目的地的情况。
- 数据任务动态限速
- 开启后该数据任务读写数据量差达到「最大缓存值」,任务将会暂停数据读取工作。当实际缓存数据量小于「最大缓存值」时会重新开始读取数据。
- 可根据用户情况自定义「检查频率」
- 读取端事务一致性
数据目的地设置

- 设置当前任务数据目的地使用资源组,通过合理分配任务与资源组,可使重要任务计算资源得到保障。
- 写入并发数量
- 基本逻辑与「读取并发数量」一致。写入并发数量是指该任务从数据源中并行写入表的数量,默认为5。
- 具体写入并发数量要根据数据源可接受请求量决定。
- 基本逻辑与「读取并发数量」一致。写入并发数量是指该任务从数据源中并行写入表的数量,默认为5。
- 写入速率限制
- 当用户设置写入速率限制,系统平均写入速率将不会超过该数值。
- 可按流量或行数作为限制条件。
- 用户能够不选、单选或多选,若同时勾选,两种限制将同时应用。
- 勾选后即可激活对应的速率限制,请输入正整数;
- 表和字段名称大小写
- 支持用户设置目的地表名称和字段名称大小写
- 选择【自定义】,任务执行后,系统会根据用户自定义的表和字段名称写入到目的地。
- 选择【全部大写】,任务执行后,系统会将用户设置的所有表和字段名称转换为大写(只包含英文)后写入到目的地。
- 选择【全部小写】,任务执行后,系统会将用户设置的所有表和字段名称转换为小写(只包含英文)后写入到目的地。
- 数据目的地高级设置
其他设置
五、读取设置

同步列表
- 读取列表显示该任务读取的表,点击任一表名称右侧显示该表的表结构。
- 提供搜索功能,主要支持搜索表名称。
- 点击「编辑」,可重新选择读取对象。
- 提供「批量设置」功能,包括:批量移除读取对象,批量设置执行语句。
传输队列设置
详情见:读取设置
读取分区设置

- 数据源表结构每一个表增加读取分区设置
- 每个表结构下提供:「读取分区设置」区域。
- 点击编辑读取条件,用户可以自定义读取分区。
- 详情见:Hive数据源读取分区设置
六:写入设置
写入列表
- 写入列表显示本次任务中,哪些数据源表会写入到该目的地。
- 提供搜索功能,主要支持搜索表名称。
- 点击「编辑」,可重新选择写入对象。
- 提供「批量设置」功能,包括:
- 批量移除读取对象。
- 批量设置表名称(主要用于多表同结构数据往目的地一张表写入场景)。
详情见:批量功能
目的地表结构设置

- 点击任一表名称右侧显示每个目的地表的映射关系(左侧是数据源表结构)。
- 若数据目的地没有同名表,激活任务后DataPipeline会在目的地创建新表。
- 若目的地已存在同名表,目的地表名称右侧会有提示。
- 若该任务往已创建的同名表写入数据,会检查表结构是否一致。
- 若表结构一致(只检查字段名,不检查字段类型和其他属性),则正常写入数据。
- 若表结构不一致(少字段或多字段),则强制改为用户设置的表结构后再进行数据同步。
- 若该任务往已创建的同名表写入数据,会检查表结构是否一致。
- 关于高级清洗使用方法请见:设置清洗脚本
- 目的地表结构用户可修改字段名称、类型、精度、标度、Not Null、主键等属性
七、数据任务详情页
「数据任务统计」
- 已读取数据量:
- 指 DataPipeline 从数据源已读取的数据量。
- 当 DataPipeline 系统重启,会根据断点续传机制从上一次读取记录点开始重新读取数据,重复读取的数据量不会记录到已读取数据量里。
- 无主键的定时同步时全量替换数据,故每次定时读取全量数据,数据源没有更新的数据会再次读取。
- 已处理数据量:
- 指 DataPipeline 已处理的数据量,这里包括:同步到数据目的的数据量和进入到错误队列的数据量。
- 当 DataPipeline 系统重启,会根据断点续传机制从上一个读取记录点开始重新写入部分数据,但这部分数据不会记录到已写入数据量里。
- 错误队列:指已读取的数据中系统判断无法写入到数据目的地,而异步放到错误队列中的数据量。:
- 读取速率:指DataPipeline从数据源读取数据的速率。
- 处理速率:指DataPipeline处理数据的速率
「复制任务」
详情见:复制任务
「错误队列」
详情见:错误队列
「消息列表」
详情见:消息列表