设置清洗脚本
清洗脚本
在写入设置页面,支持清洗脚本功能。默认提供以下模版:
| 模版 | 描述 |
|---|---|
| DML.java | 代表DML字段标识脚本,源表数据发生变化时,在目的地表中增加相应的 DML 标识字段,包括 insert、update、delete |
| CollectTime.java | 代表读取时间脚本,根据数据读取时间,在目的地表中增加相应的时间字段 |
| UpdateTime.java | 代表写入时间脚本:根据数据写入时间,在目的地表中增加相应的时间字段 |
| TimestampProcess.java | 将 Timestamp 类型数据转换为日期类型 |
| JSONProcess.java | 将 JSON 数据解析,并指定到目标表表结构(含有 JSON 数据解析样例) |
具体操作如下: 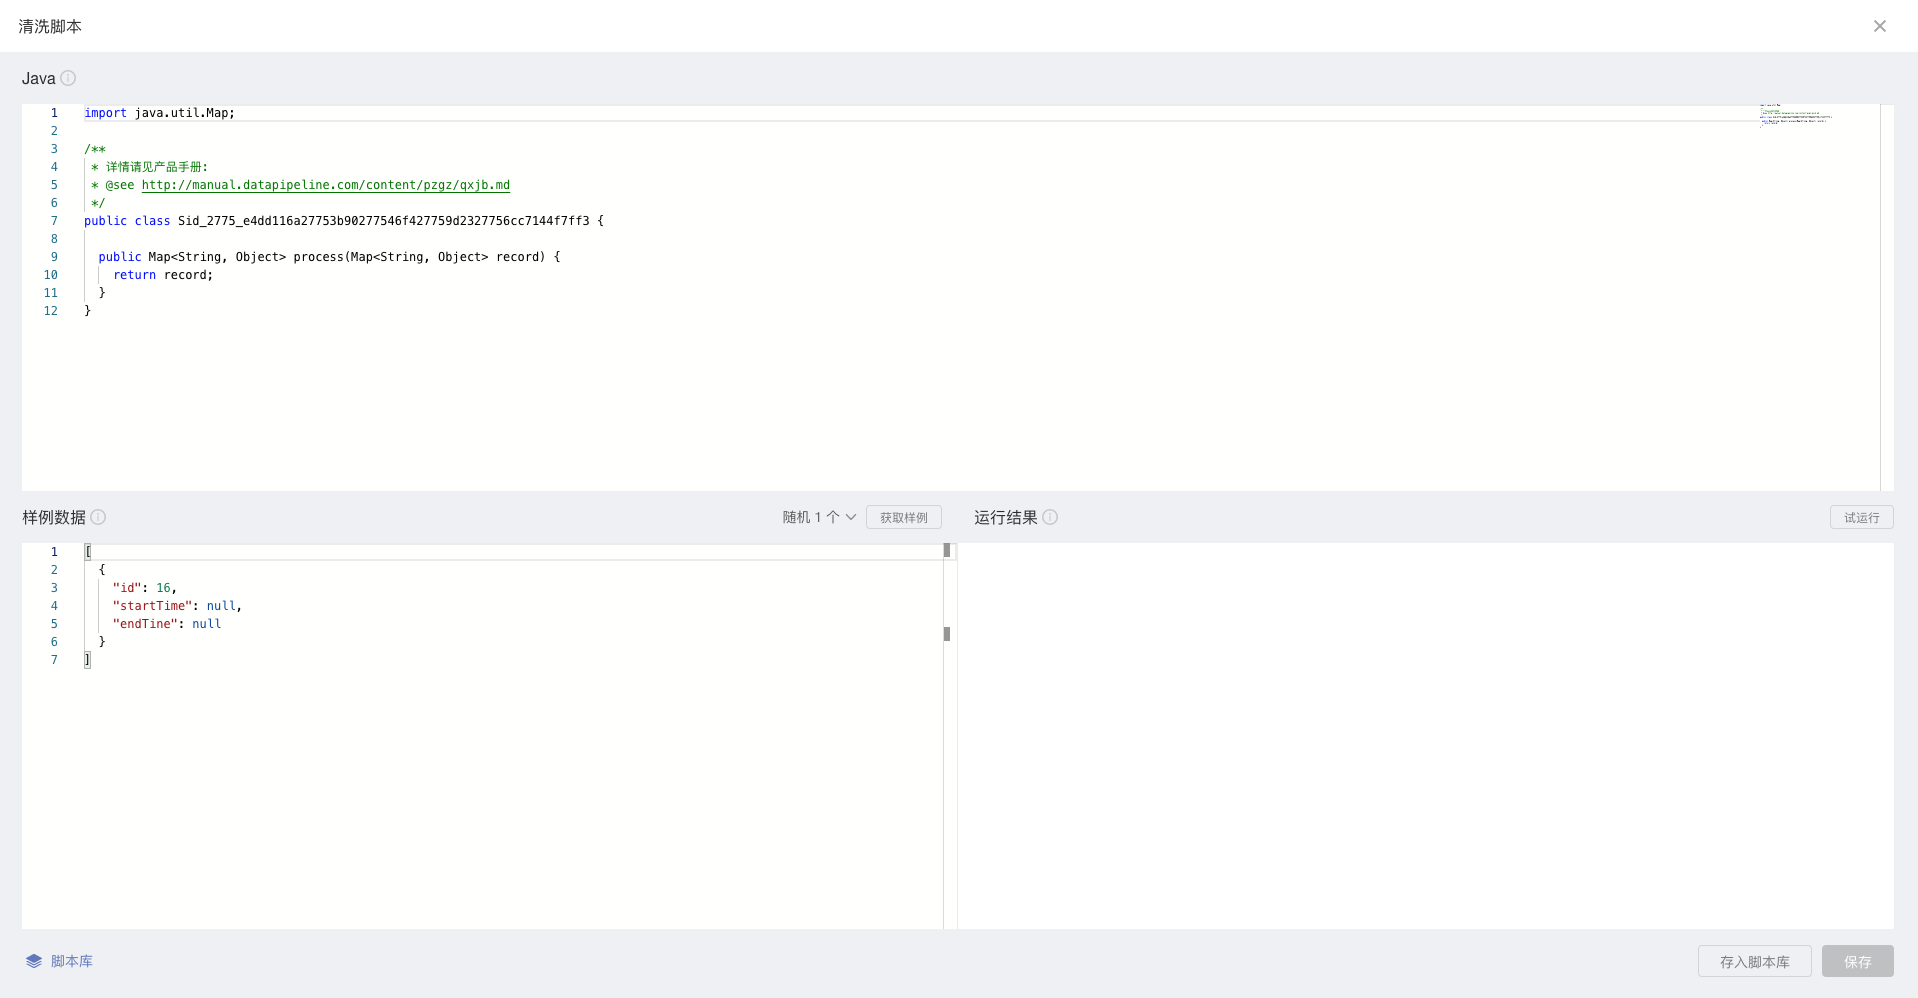
- 点击「清洗脚本」开关可以打开或关闭清洗脚本功能。
- 默认为关闭状态,点击后将高亮开关,并进入新窗口进行清洗脚本编辑;
- 上方输入框支持用户输入或粘贴清洗逻辑,默认已经提供了基本的代码结构;
- 目前支持Java语言进行清洗逻辑的编写;
- 支持用户在脚本库调用脚本,不用每次都重新输入
- 左下角显示「脚本库」按钮,点击按钮,显示脚本库的脚本列表
- 点击选择需要使用的脚本,选择后脚本显示在编辑界面上,可修改
- 脚本库提供一些默认脚本模版,如DML.java,CollectTime.java,UpdateTime.java、TimestampProcess.java、JSONProcess.java
- DML.java:代表DML字段标识脚本,源表数据发生变化时,在目的地表中增加相应的 DML 标识字段,包括 insert、update、delete
- CollectTime.java:代表读取时间脚本,根据数据读取时间,在目的地表中增加相应的时间字段
- UpdateTime.java:代表写入时间脚本:根据数据写入时间,在目的地表中增加相应的时间字段
- 使用默认的DML字段标识脚本、读取时间脚本以及写入时间脚本时,需要用户在目的地添加相应的字段,否则该脚本无法生效。
- TimestampProcess.java:将 Timestamp 类型数据转换为日期类型
- JSONProcess.java:将 JSON 数据解析,并指定到目标表表结构(含有 JSON 数据解析样例)
- 使用默认的TimestampProcess.java和JSONProcess.java时,需要用户按实际情况修改模板中的字段信息。
- 点击“使用此脚本”,当前脚本对表进行配置
- 左下角显示「脚本库」按钮,点击按钮,显示脚本库的脚本列表
- 支持查看样例数据,默认情况下系统将自动获取随机1个数据源的样例数据,您可选择获取随机10个或随机100个样例,点击按钮即可刷新获取。
- 若样例数据为空,系统将返回一对中括号。
- 支持对清洗逻辑进行试运行:
- 试运行的结果将实时显示,有变化的内容将以如图形式呈现。
- 若输入的清洗逻辑有误,运行结果窗口将报错,请您查看错误详细内容重试。
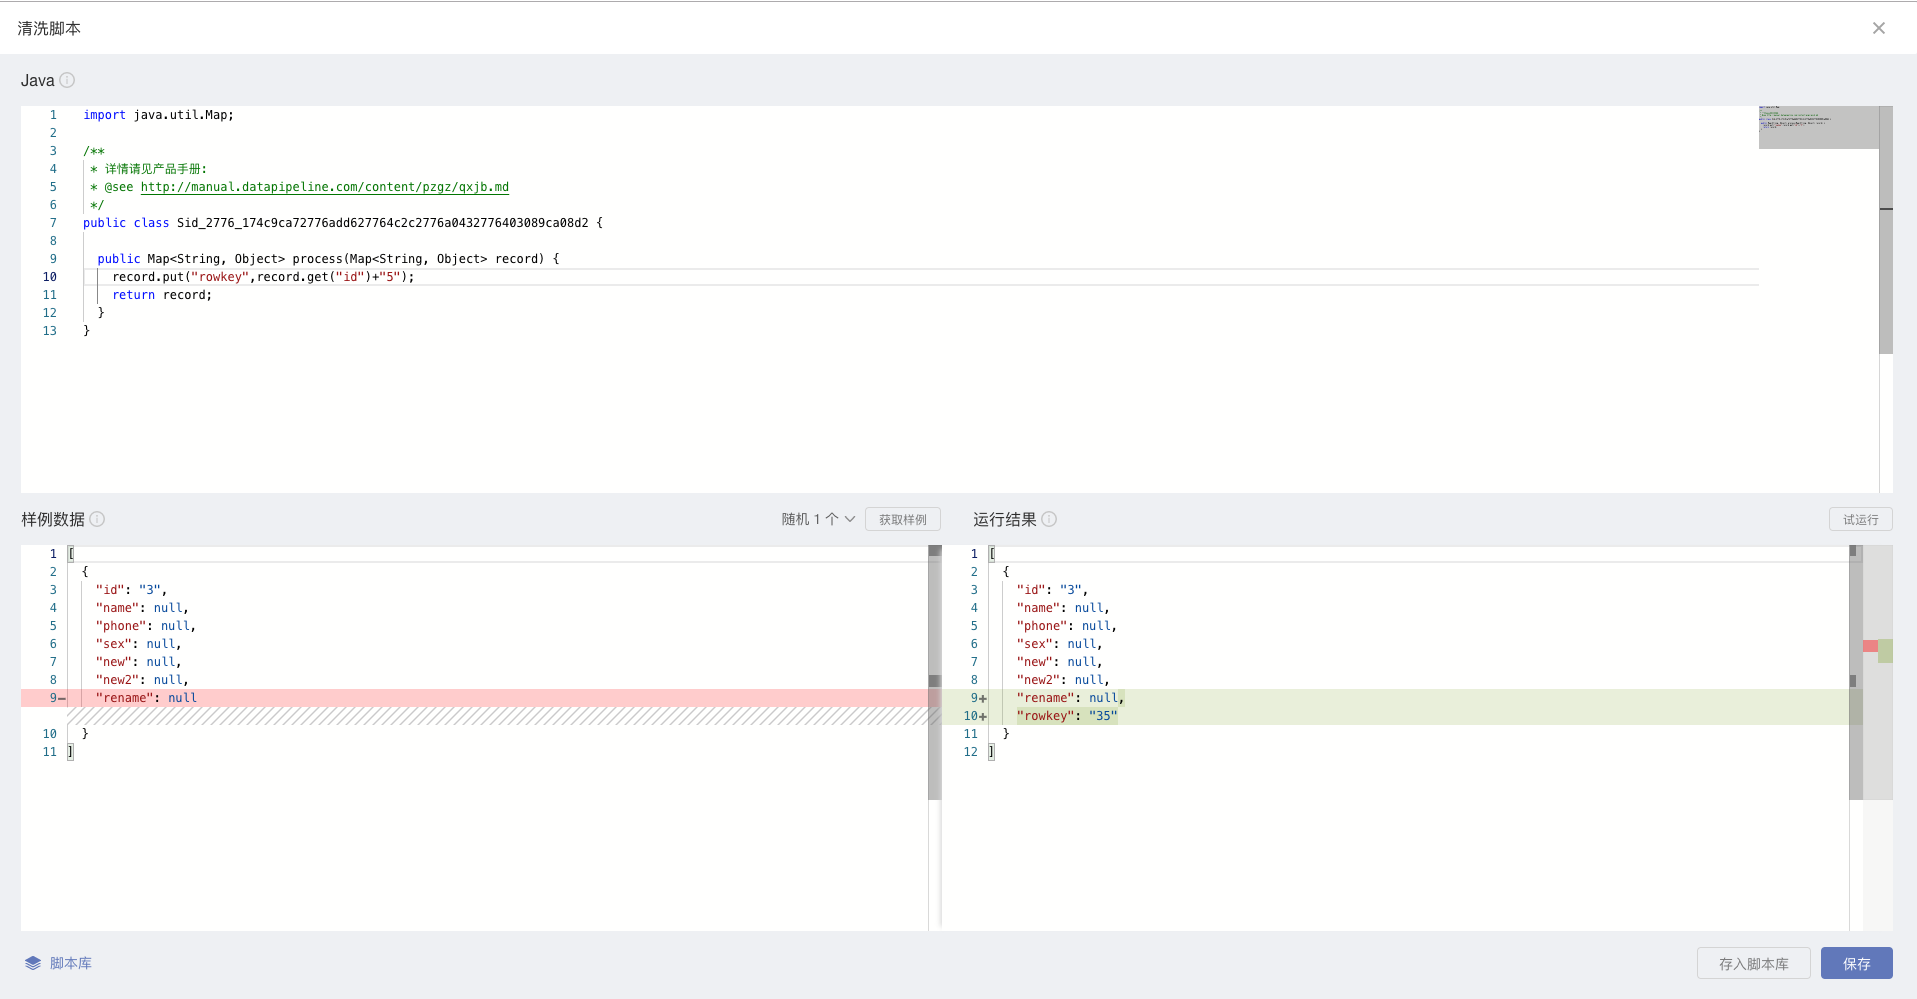
- 脚本编辑界面右上角显示关闭按钮,用户设置完毕后点击保存按钮退出
- 用户退出清洗脚本后,可以通过编辑按钮再次进入。
- 点击编辑按钮,进入清洗脚本界面,点击返回返回到配置页,与当前逻辑一致。
- 关闭清洗脚本,编辑脚本入口按钮不可编辑,鼠标放在上面浮层提示:请开启清洗脚本
- 激活前后,清洗脚本开启和编辑按钮均可编辑
- 点击保存就能够回到写入设置页面。
- 点击存入脚本库,用户可以将写好的脚本保存到脚本库以供后续使用。
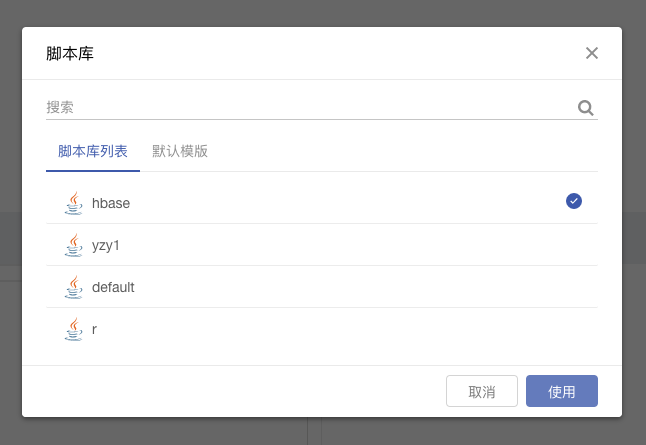
- 用户可以自定义脚本名称用以区分不同的脚本。
- 用户可选择脚本列表已有脚本,点击确认脚本会被重新覆盖(只有管理员和自己创建的脚本才允许覆盖)。
- 用户输入新的名称,则会保存一个新的脚本。
- 当目的地为HBase时,要求必须在高级清洗中为rowkey赋值,否则目的地只会保留最新的一条记录。
如: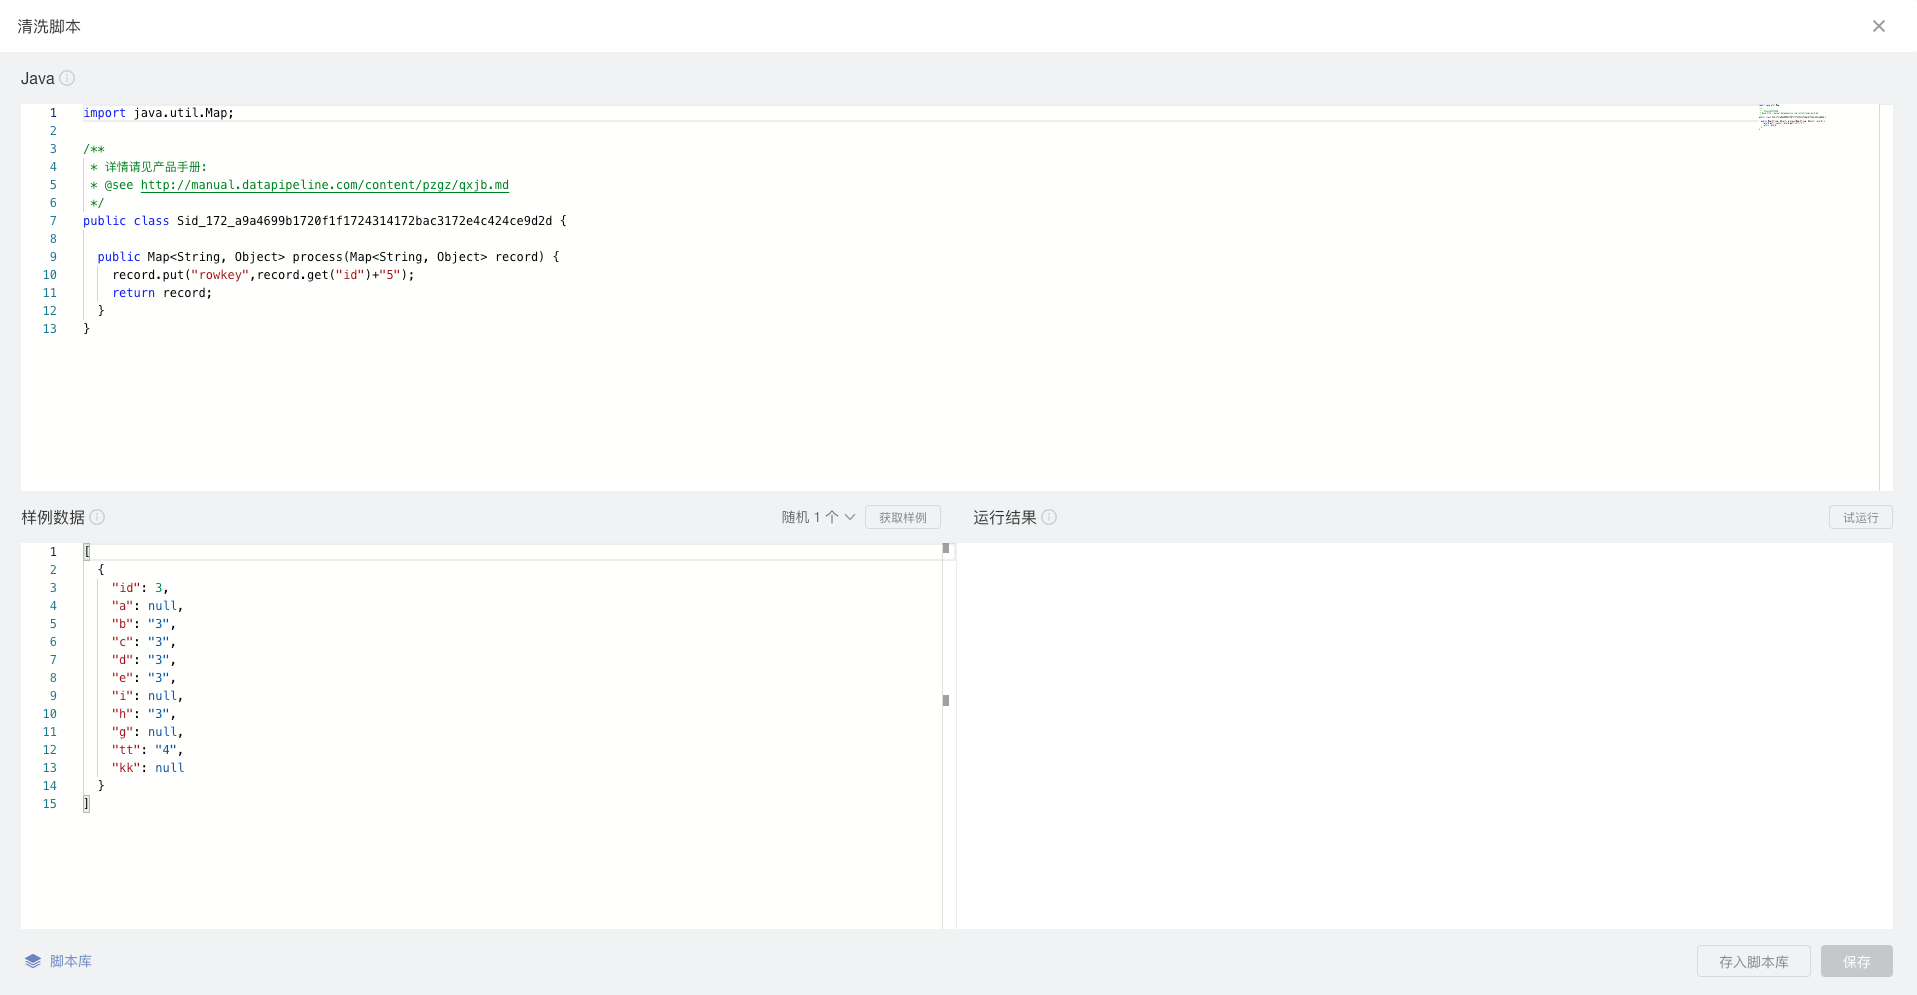
使用案例
一、DML字段标识脚本
脚本描述:源表数据发生变化时,在目的地表中增加相应的 DML 标识字段,包括 insert、update、delete
import com.datapipeline.clients.connector.record.DpRecordMeta;
import java.util.Map;

public  class AddDMLField {
    public  static Map process(Map record, DpRecordMeta meta) {
        // 系统会向 dml 字段写入标识:insert、update、delete。
        // 如果是定时读取模式,所有 dml 字段会表示为 insert,只有通过实时模式读取数据时才会识别 update 和 delete。
        record.put("dml", meta.getType());
        // 保存该脚本后,请在目的地表结构添加新字段:dml,并把字段类型改为字符串类型(例如:varchar)
        return record;
    }
}
二、读取时间脚本
脚本描述:根据数据读取时间,在目的地表中增加相应的时间字段
import com.datapipeline.clients.connector.record.DpRecordMeta;
import java.util.Map;
import java.time.LocalDateTime;
import java.time.ZoneId;
import java.time.Instant;
import java.time.format.DateTimeFormatter;

public  class AddCollectTimeField {
    private  static DateTimeFormatter DATE_TIME_FORMATTER = DateTimeFormatter.ofPattern("yyyy-MM-dd HH:mm:ss");

    public Map process(Map record, DpRecordMeta meta) {
        // 系统会向 collect_time 字段写入读取该数据的时间,格式为:yyyy-MM-dd HH:mm:ss。
        record.put("collect_time", Instant.ofEpochMilli(meta.getSourceRecordTimestamp()).atZone(ZoneId.of("UTC")).format(DATE_TIME_FORMATTER));
        // 保存脚本后,在目的地表结构中添加字段:collect_time,并把字段类型改为时间类型(或字符串类型)。
        return record;
    }
}
三、写入时间脚本
脚本描述:根据数据写入时间,在目的地表中增加相应的时间字段
import java.util.Map;
import java.time.LocalDateTime;
import java.time.ZoneId;
import java.time.format.DateTimeFormatter;

public  class AddUpdateTimeField {
    private  static DateTimeFormatter DATE_TIME_FORMATTER = DateTimeFormatter.ofPattern("yyyy-MM-dd HH:mm:ss");

    public Map process(Map record) {
        // 系统会向 update_time 字段写入写入目的地的时间,格式为:yyyy-MM-dd HH:mm:ss。
        record.put("update_time", LocalDateTime.now(ZoneId.of("Asia/Shanghai")).format(DATE_TIME_FORMATTER));
        // 保存脚本后,在目的地表结构中添加字段:update_time,并把字段类型改为时间类型(或字符串类型)。
        return record;
    }
}
四、日期类型转换脚本
脚本描述:将 Timestamp 类型数据转换为日期类型
import java.time.LocalDateTime;
import java.time.format.DateTimeFormatter;
import java.util.Map;

public  class TimestampProcess {
    private  static  final DateTimeFormatter DATE_FORMATTER = DateTimeFormatter.ofPattern("yyyy-MM-dd");
    private  static  final DateTimeFormatter TIMESTAMP_FORMATTER =
    DateTimeFormatter.ofPattern("yyyy-MM-dd HH:mm:ss.SSS");

    public Map process(Map record) {
        // timestamp_type 类型为字符串,格式为:2019-07-24 17:06:54.000
        final String timestampStr = (String) record.get("timestamp_type");
        if (timestampStr != null) {
            try {
                // 将字符串转换为日期对象
                final LocalDateTime localDateTime = LocalDateTime.parse(timestampStr, TIMESTAMP_FORMATTER);
                // 将时间对象转换为 DATE_FORMATTER 格式的字符串,转化之后的字符串为:2019-07-24
                record.put("formatedTime", DATE_FORMATTER.format(localDateTime));
            } catch (Exception e) {
                e.printStackTrace();
            }
        }
        return record;
    }
}
五、Timestamp 转换脚本
脚本描述:将日期类型转换为Timestamp 类型数据
import java.time.ZoneId;
import java.time.ZonedDateTime;
import java.time.format.DateTimeFormatter;

public class Date2TimeStampSample {

    public Map<String, Object> process(Map<String, Object> record)  throws Exception{
        // date = "20180101 12:0:22.123"
        String date = record.get("date");
        long timeStamp = ZonedDateTime.parse(date, DateTimeFormatter.ofPattern("yyyy-MM-dd HH:mm:ss.SSS").withZone(ZoneId.of("Asia/Shanghai"))).toInstant().toEpochMilli();
        record.put("ts", timeStamp);
        return record;
    }
}
六、JSON解析脚本
脚本描述:将 JSON 数据解析,并指定到目标表表结构
import com.alibaba.fastjson.JSON;
import com.alibaba.fastjson.JSONArray;
import com.alibaba.fastjson.JSONObject;
import java.util.ArrayList;
import java.util.HashMap;
import java.util.List;
import java.util.Map;
import java.util.Objects;

public class Test_api_url_nameTransformEngine {
    public List<Map<String, Object>> process(Map<String, Object> record) {
        List<Map<String, Object>> records = new ArrayList<>();
        if (!Objects.isNull(record)) {
            String jsonStr = (String) record.get("content");
            JSONObject jsonNode = JSON.parseObject(jsonStr);
            JSONArray items = jsonNode.getJSONObject("reponseData").getJSONArray("data");
            for (Object iterm : items) {
                JSONObject eachIterm = (JSONObject) iterm;
                String title = String.valueOf(eachIterm.get("title"));
                if (title != null && title.length() > 100) {
                    title = title.substring(0, 100);
                }
                Map<String, Object> eachRowData = new HashMap<>();
                eachRowData.put("_id", String.valueOf(eachIterm.get("id")));
                eachRowData.put("tab", String.valueOf(eachIterm.get("tab")));
                eachRowData.put("title", title);
                records.add(eachRowData);
            }
        }
        return records;
    }
}
效果如下:
在DataPipeline的「高级清洗」界面的显示如下: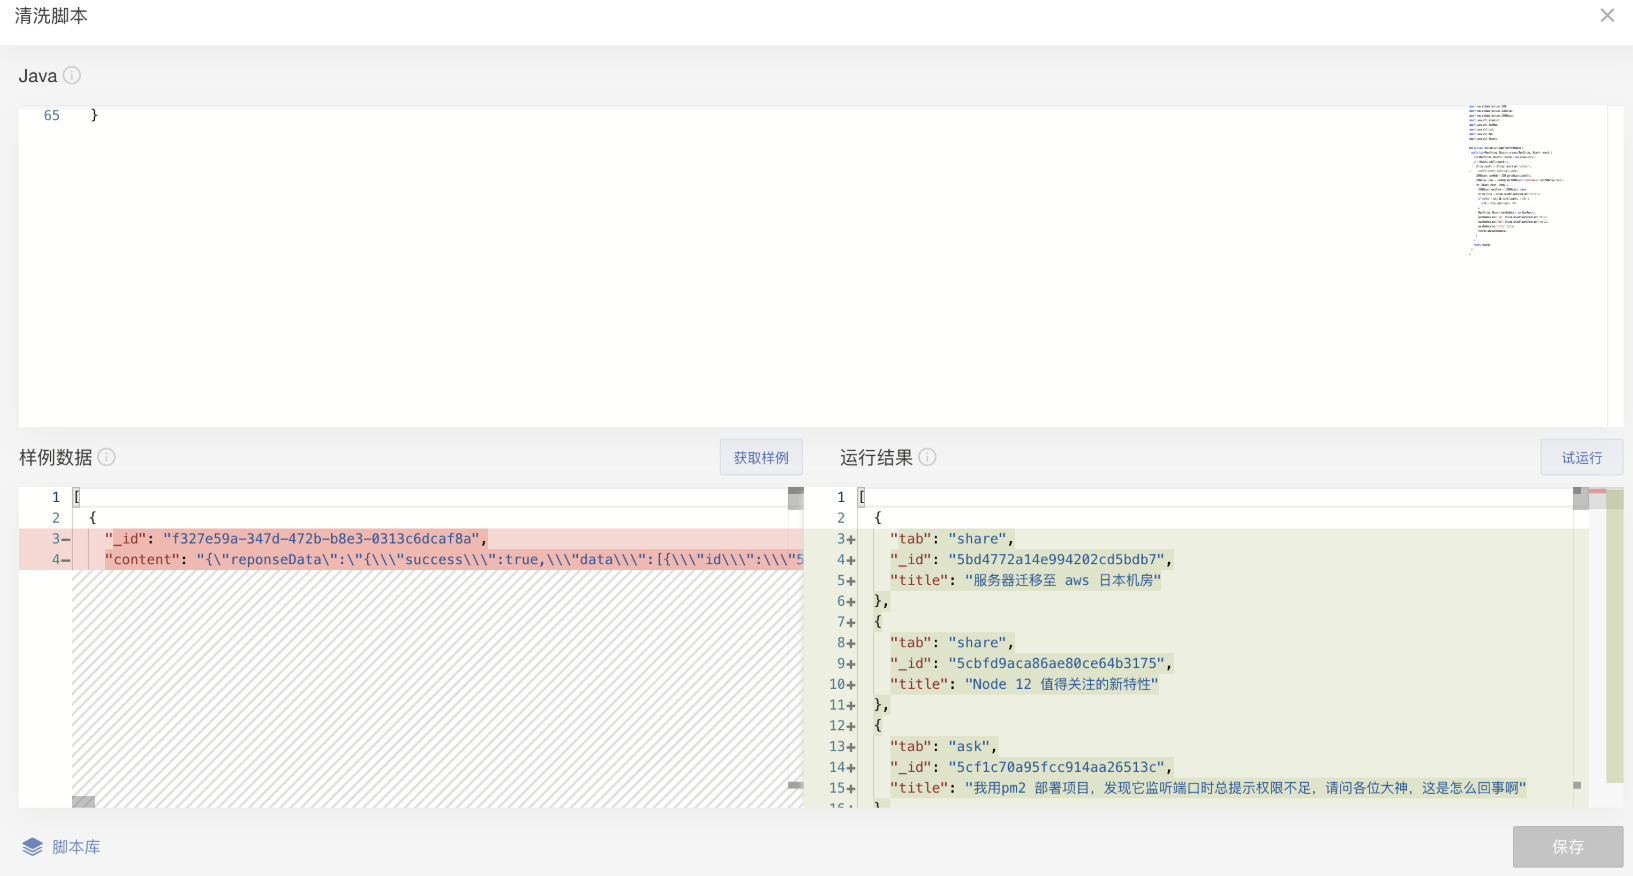
七、数据脱敏
场景描述:用户想对表格中的信息进行脱敏,比如手机号或者身份证号。
例:身份证号脱敏,保留前四位和后四位,手机号码脱敏,保留前三位和后四位。
具体代码如下:
import java.util.Map;

public class Sid_2382_05b0f75d2382f96a23824d7023829c612382ef7ac208785d {

    public Map process(Map record) {

        record.put("id",((String)record.get("id")).replaceAll("(\\d{4})\\d{10}(\\d{4})","$1**********$2"));
        record.put("phone",((String)record.get("phone")).replaceAll("(\\d{3})\\d{4}(\\d{4})","$1****$2"));

        return record;
    }
}
效果如下:
数据源的原表为: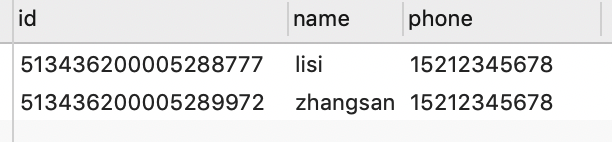
经过「高级清洗」后,数据目的地的表内容为:
在DataPipeline的「高级清洗」界面的显示如下: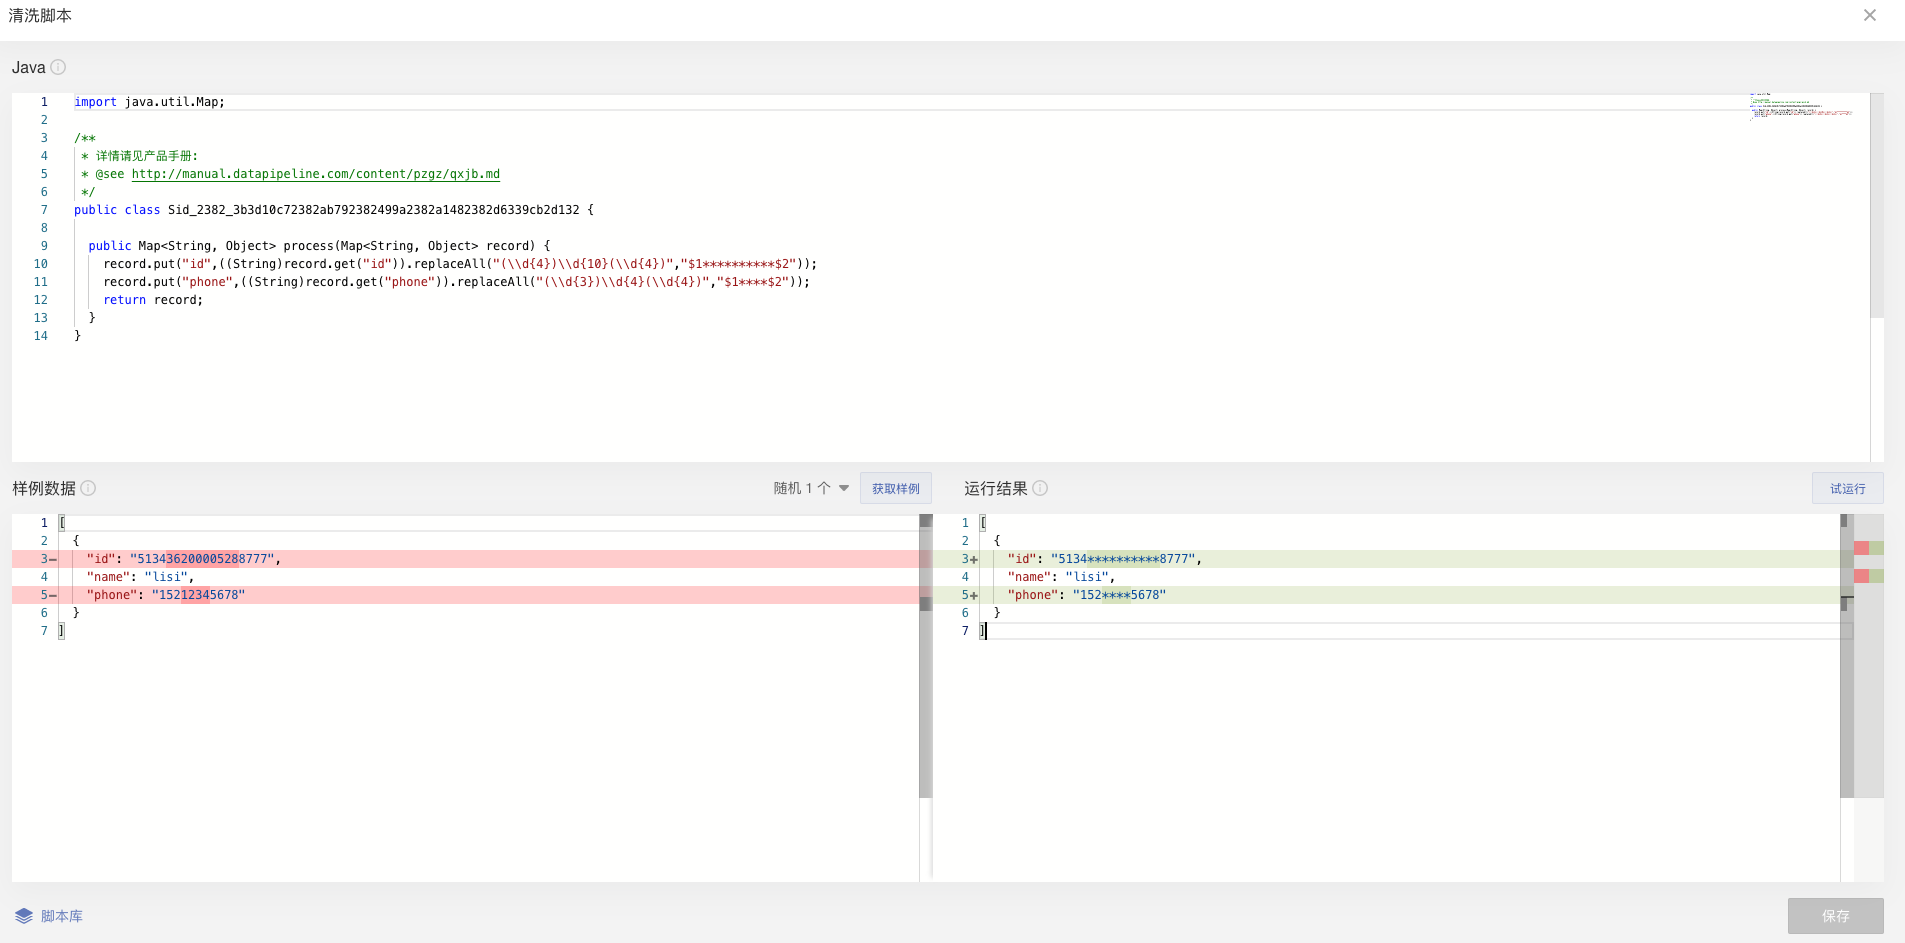
八、枚举类型转换
场景描述:用户想对表格中的类型进行转换。
例:把原表中表示性别的‘0’和‘1‘,到目的地表中,转换为对应的‘男’和‘女’。
具体代码如下:
import java.util.Map;

public class Sid_2383_a8984a582383944223834f332383b7e52383aa115c629f93 {

    public Map process(Map record) {
        if (record.get("sex").equals("0"))
        {record.put("sex","男");}
        else if(record.get("sex").equals("1"))
        {record.put("sex","女");}
        else
        {record.put("sex","");}
        return record;
    }
}
效果如下:
数据源的原表为:
经过「高级清洗」后,数据目的地的表内容为:
在DataPipeline的「高级清洗」界面的显示如下: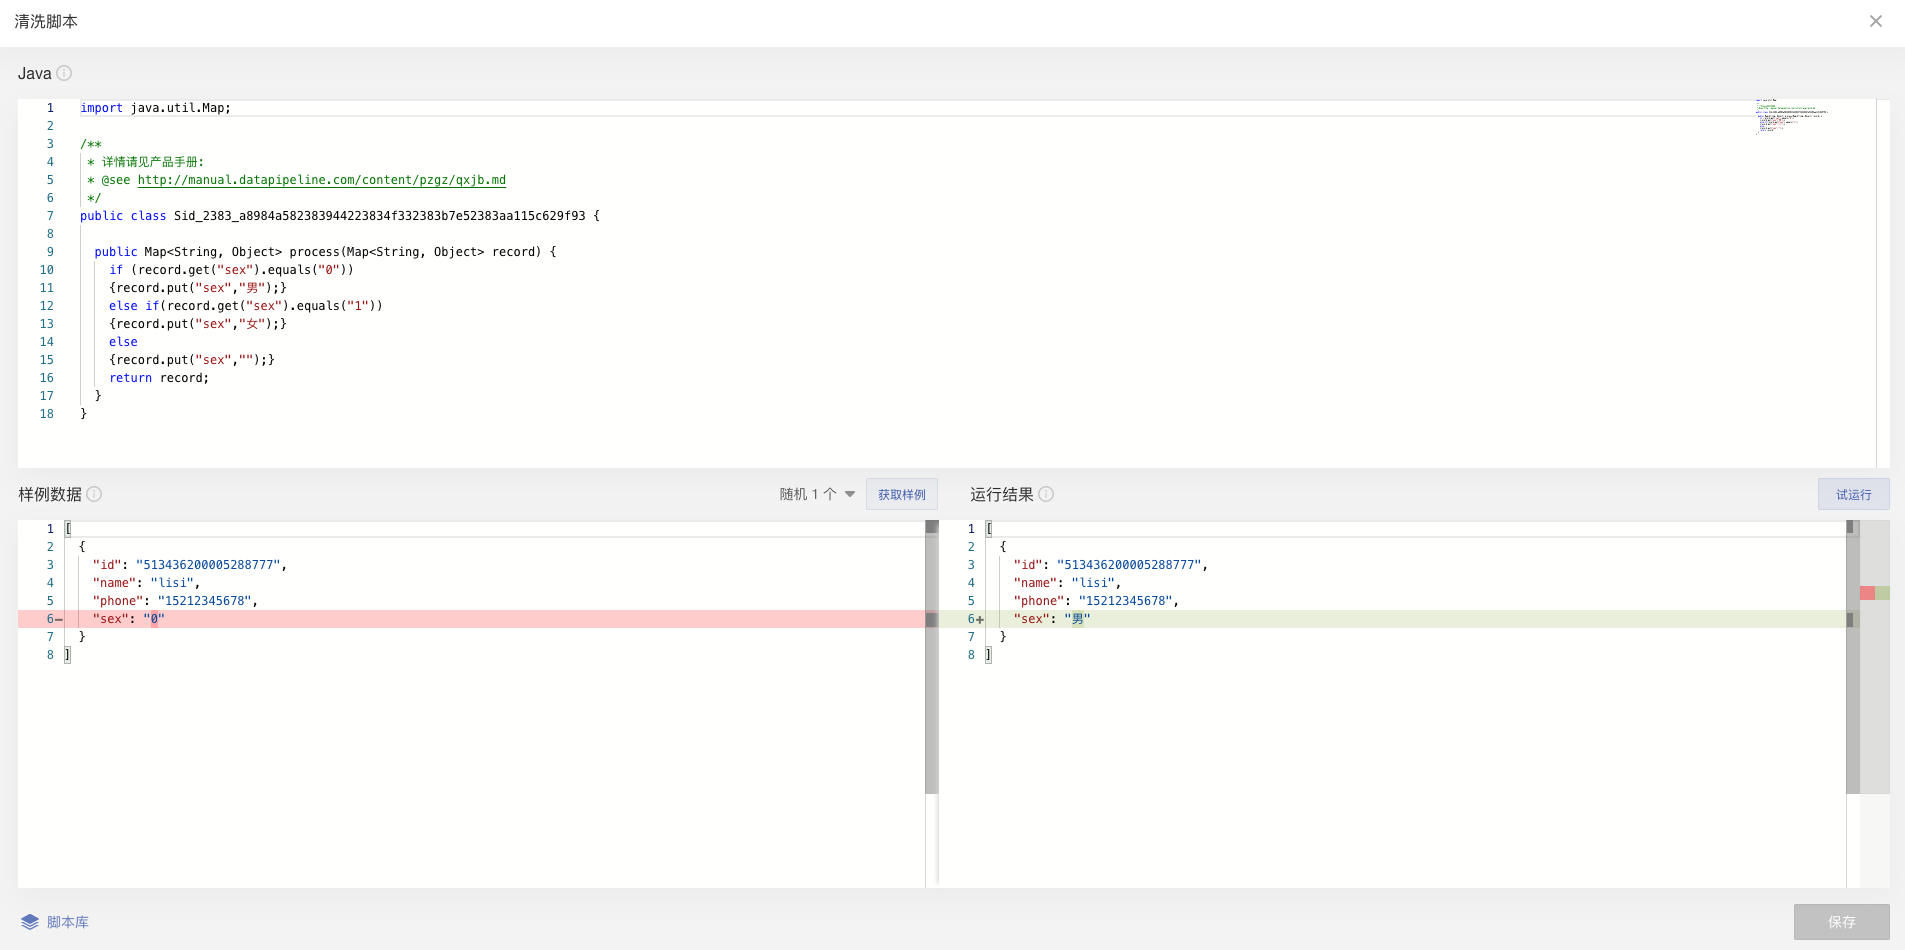
九、字段求和
场景描述:用户想对表格中的几个字段的内的数据进行求和。
例:把原表中的两个字段内的薪水,到目的地表中,生成一个新的字段,其值为前两个字段的和。
具体代码如下:
import java.util.Map;

public class Sid_2384_f049d91a2384daea23844a3a23848fd923847cc3bc23dc6e {

    public Map<String, Object>process(Map<String, Object>record) {
        record.put("sum",(Double) record.get("salary1")+(Double) record.get("salary2"));
        return record;
    }
}
效果如下:
数据源的原表为:
经过「高级清洗」后,数据目的地的表内容为: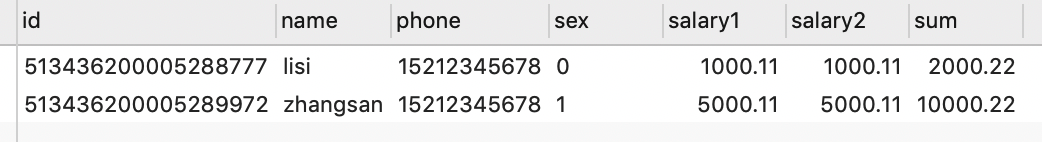
在DataPipeline的「高级清洗」界面的显示如下: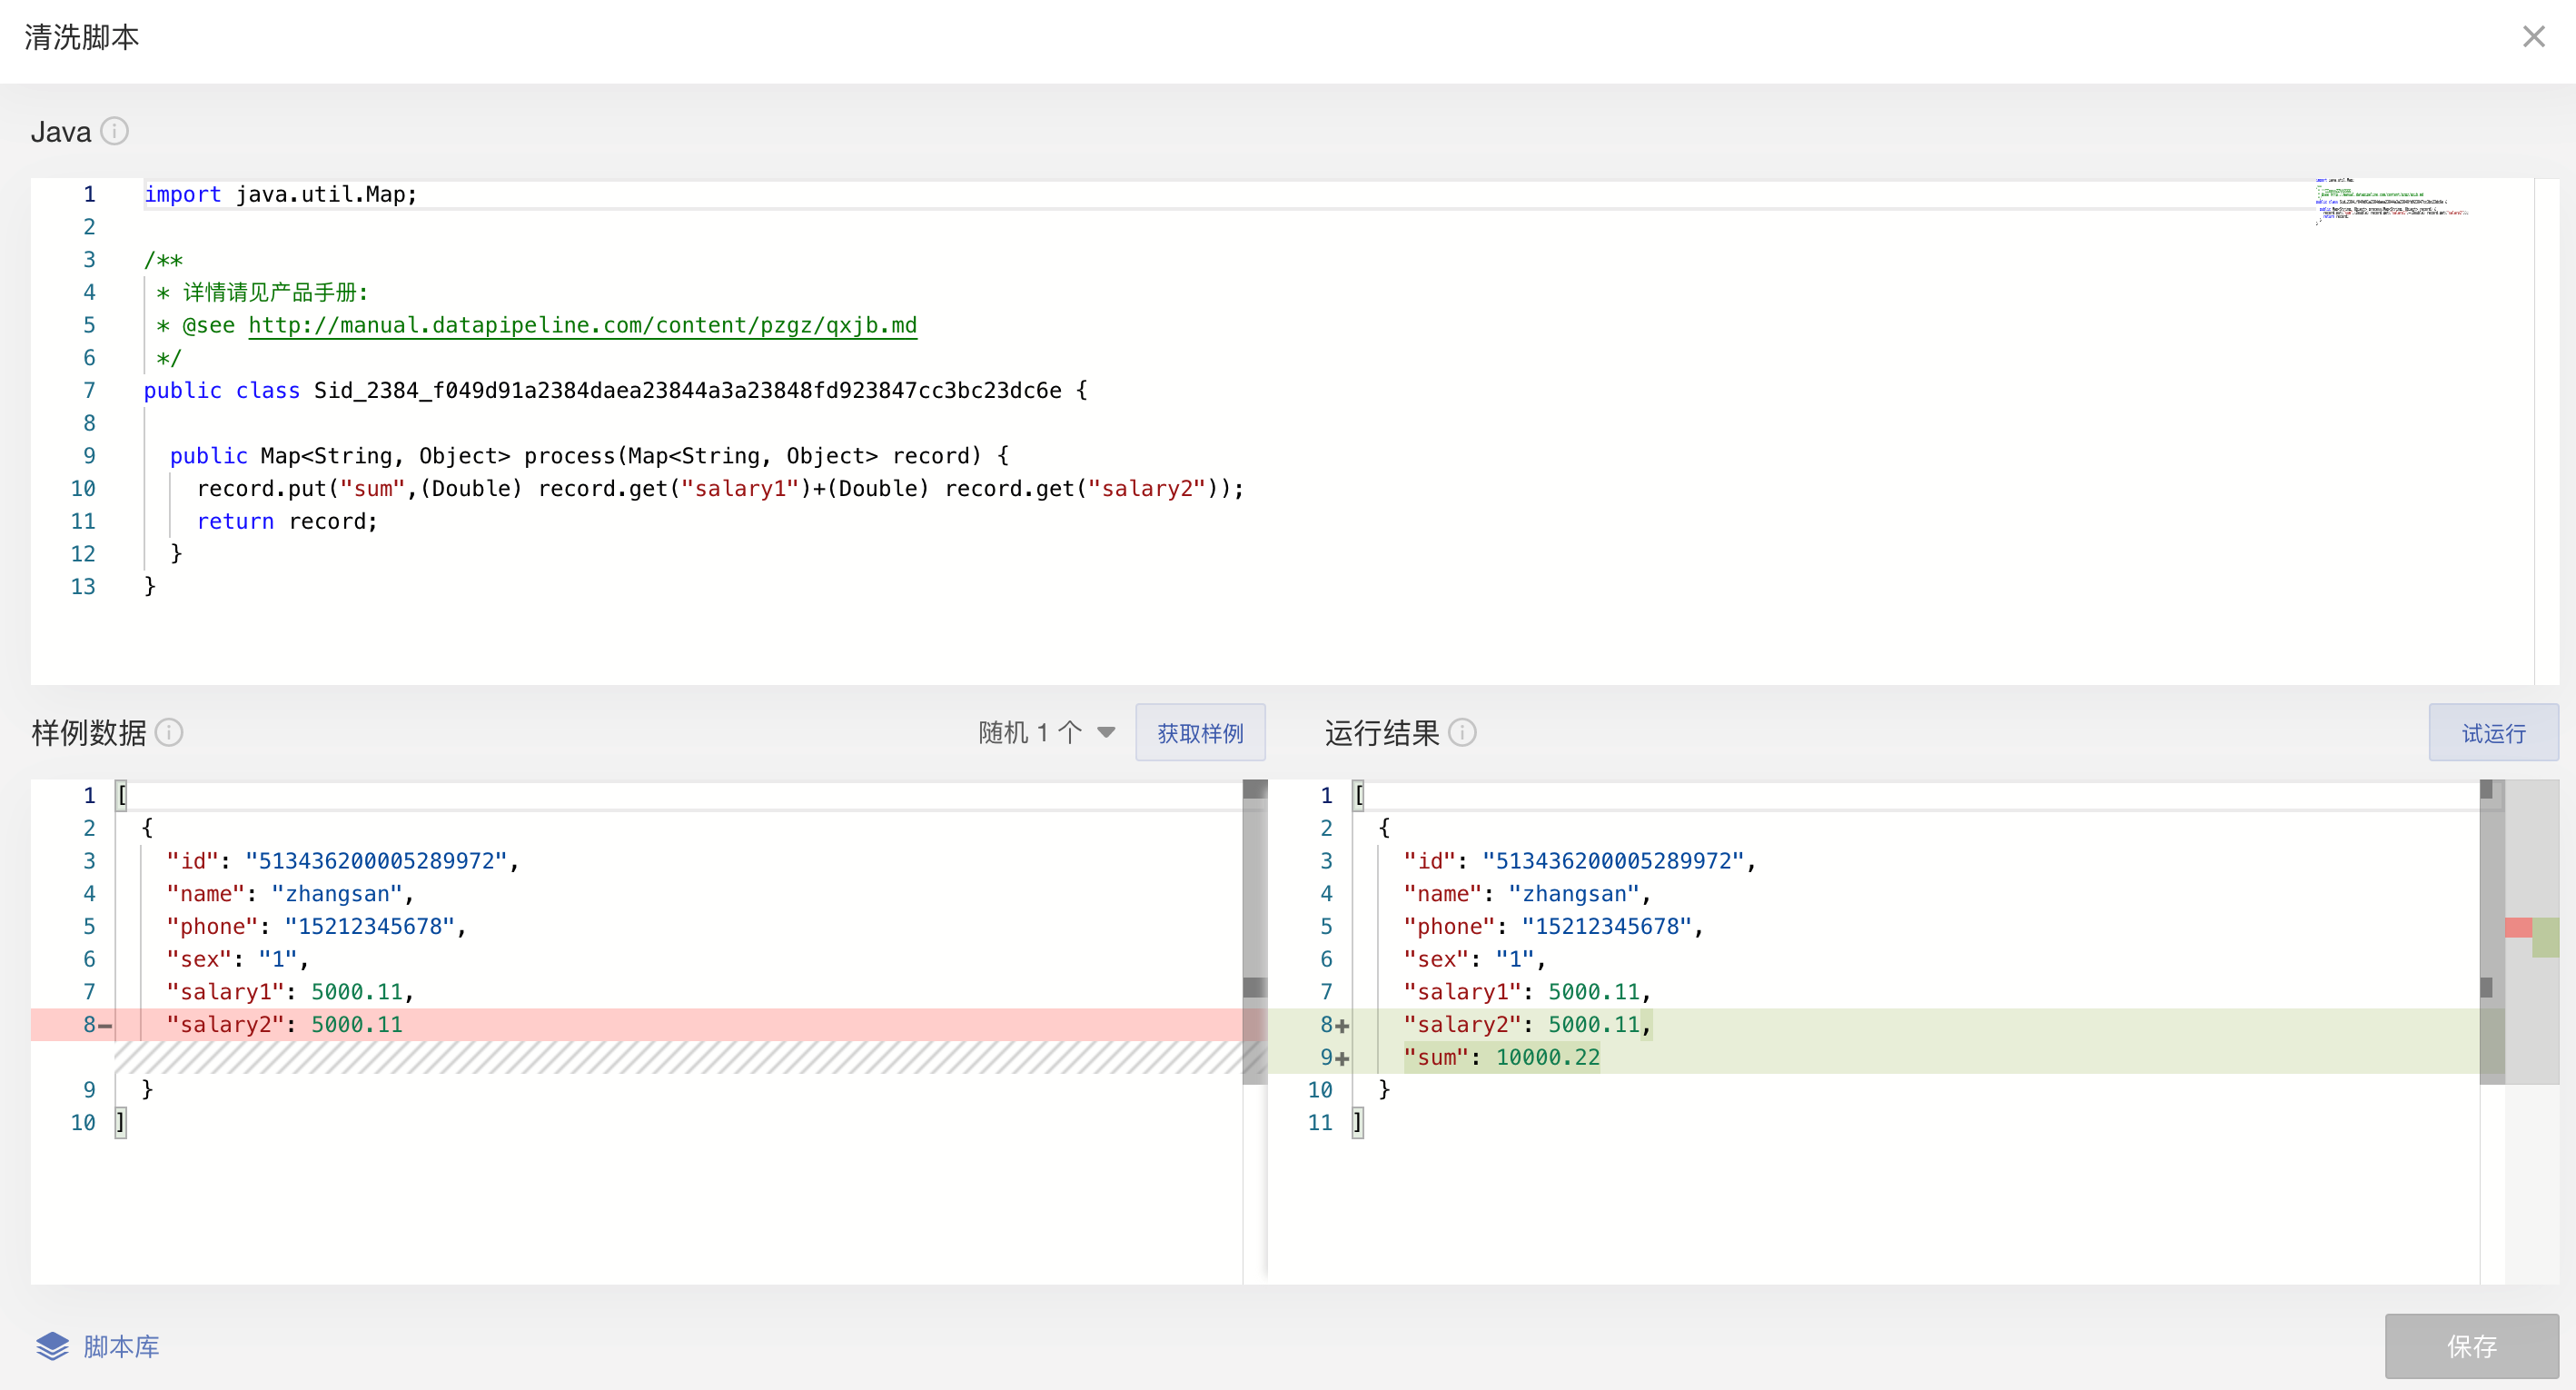
十、时间类型格式统一
场景描述:用户想对表格中字段的日期格式统一。(2019115、20190115、2019.01.15)转换成 YYYY-MM-DD(2019-01-15)。
具体代码如下:
import java.text.SimpleDateFormat;
import java.util.Date;
import java.util.HashMap;
import java.util.Map;

public class ConventDateSample {

    public Map<String, Object> process(Map<String, Object> record)  throws Exception{
        try{
            SimpleDateFormat df = new SimpleDateFormat("yyyyMMdd");
            SimpleDateFormat df2 = new SimpleDateFormat("yyyy-MM-dd");
            Date datetime=df1.parse(record.get("datetime").toString());
            String newDatetime = df2.format(datetime);
            record.put("datetime",newDatetime);
        }catch(Exception e){
        }
        return record;
    }
}
效果如下:
数据源的原表为: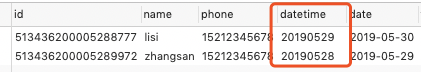
经过「高级清洗」后,数据目的地的表内容为:
在DataPipeline的「高级清洗」界面的显示如下: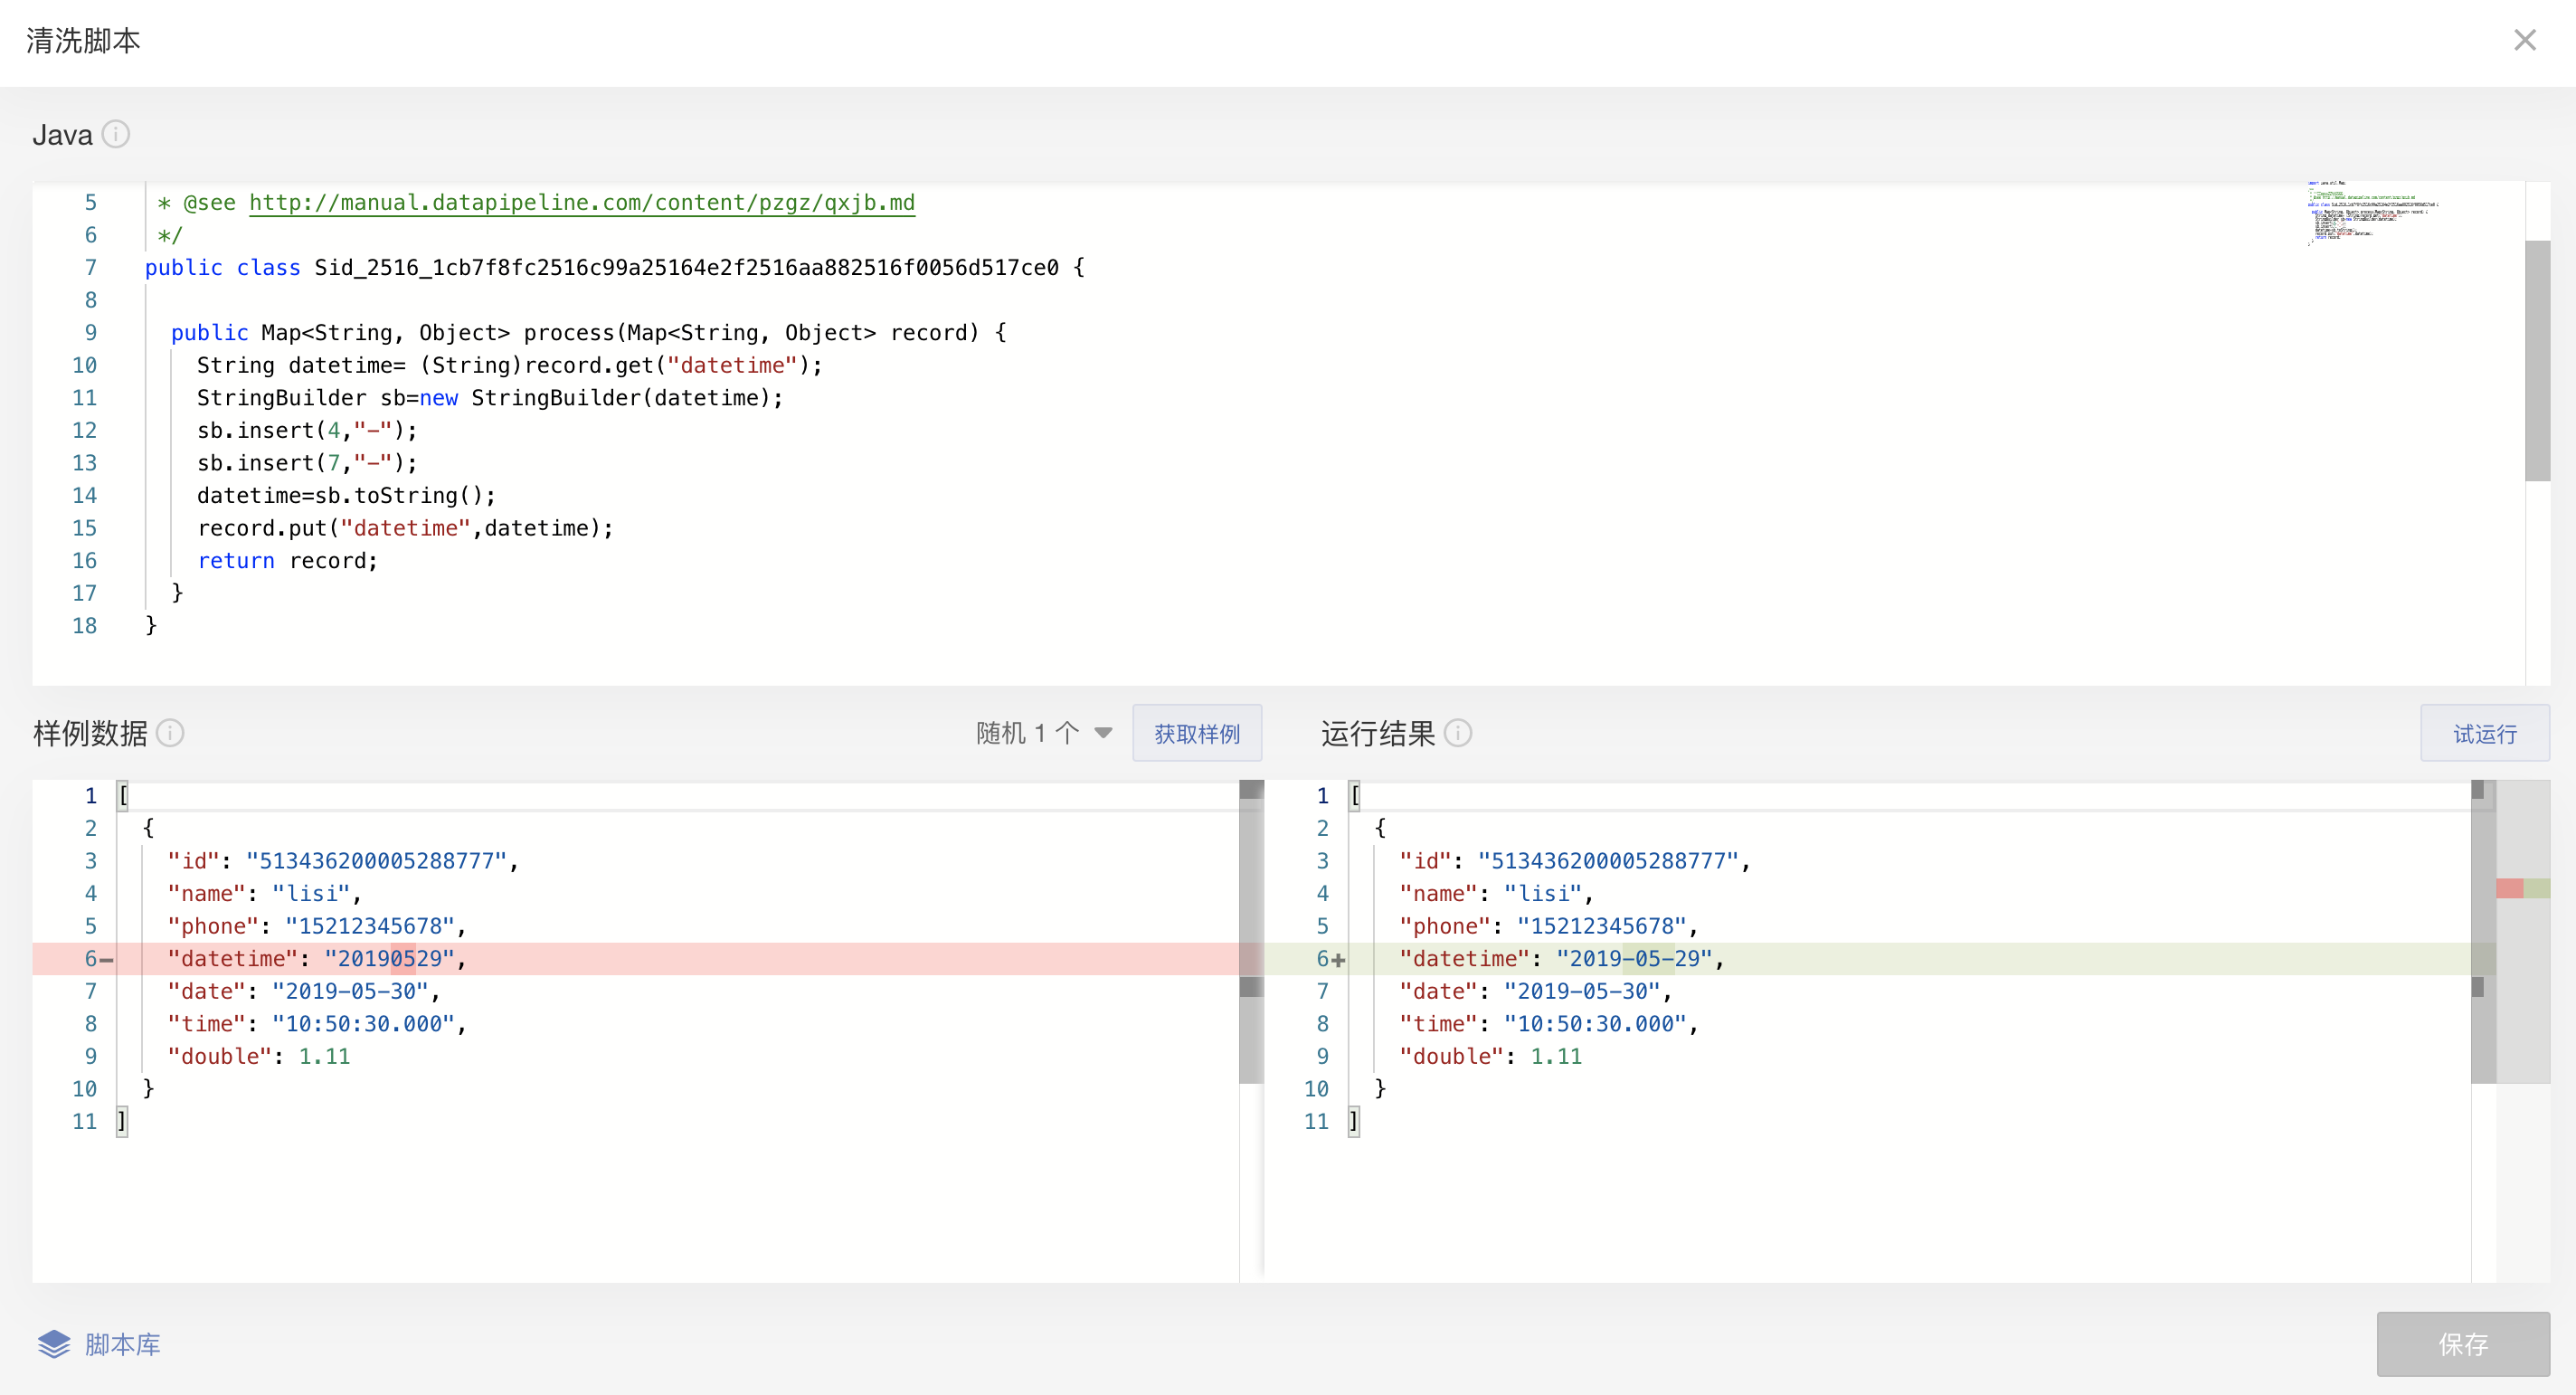
十一、库存日期结合
场景描述:用户想对表格中日期和时间,结合到一个字段内。
具体代码如下:
import java.util.Map;
import java.util.Date;
import java.text.ParseException;
import java.text.SimpleDateFormat;

public class Sid_2516_8ffcc7ca2516201f25164ee7251690f3251641b41d3bbd5c {

    public Map<String, Object>process(Map<String, Object>record) {
        record.put("datetime2", record.get("date")+" "+ record.get("time"));
        return record;
    }
}
效果如下:
数据源的原表为:
经过「高级清洗」后,数据目的地的表内容为:
在DataPipeline的「高级清洗」界面的显示如下: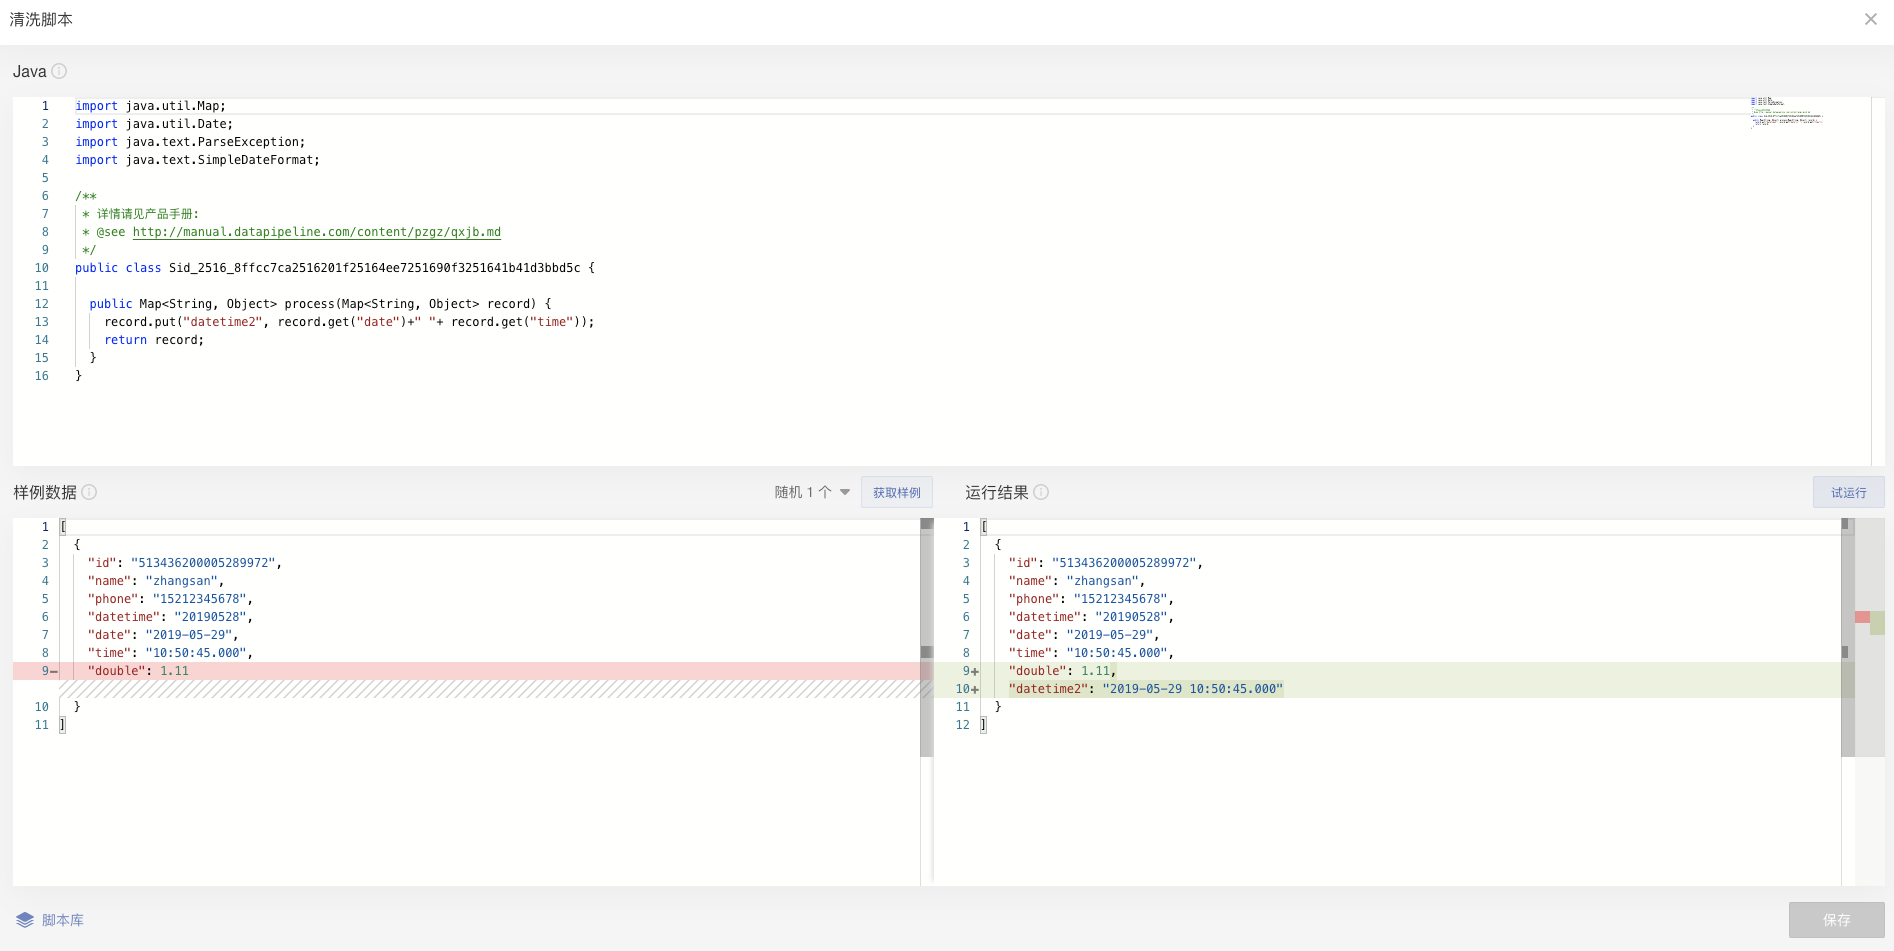
十二、日期间隔计算
场景描述:用户想对表格中两个日期之间相差的天数,进行计算,再写入到一个字段内。
具体代码如下:
import java.text.SimpleDateFormat;
import java.util.Date;
import java.util.HashMap;
import java.util.Map;

public class Sid_2519_5017952225194a2425194ff5251980f3251985af080e3b28 {

    public Map<String, Object>process(Map<String, Object> record)  throws Exception{

        SimpleDateFormat df = new SimpleDateFormat("yyyy-MM-dd");
        SimpleDateFormat df2 = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss");
        Date start=df2.parse(record.get("startTime").toString());
        Date end=df2.parse(record.get("endTine").toString());
        try{
            int days= (int) ((df.parse(df.format(end)).getTime() -df.parse(df.format(start)).getTime()) / (24 * 60 * 60 * 1000));
            record.put("days",days);
        }catch(Exception e){
        }
        return record;
    }
}
效果如下:
数据源的原表为:
经过「高级清洗」后,数据目的地的表内容为:
在DataPipeline的「高级清洗」界面的显示如下: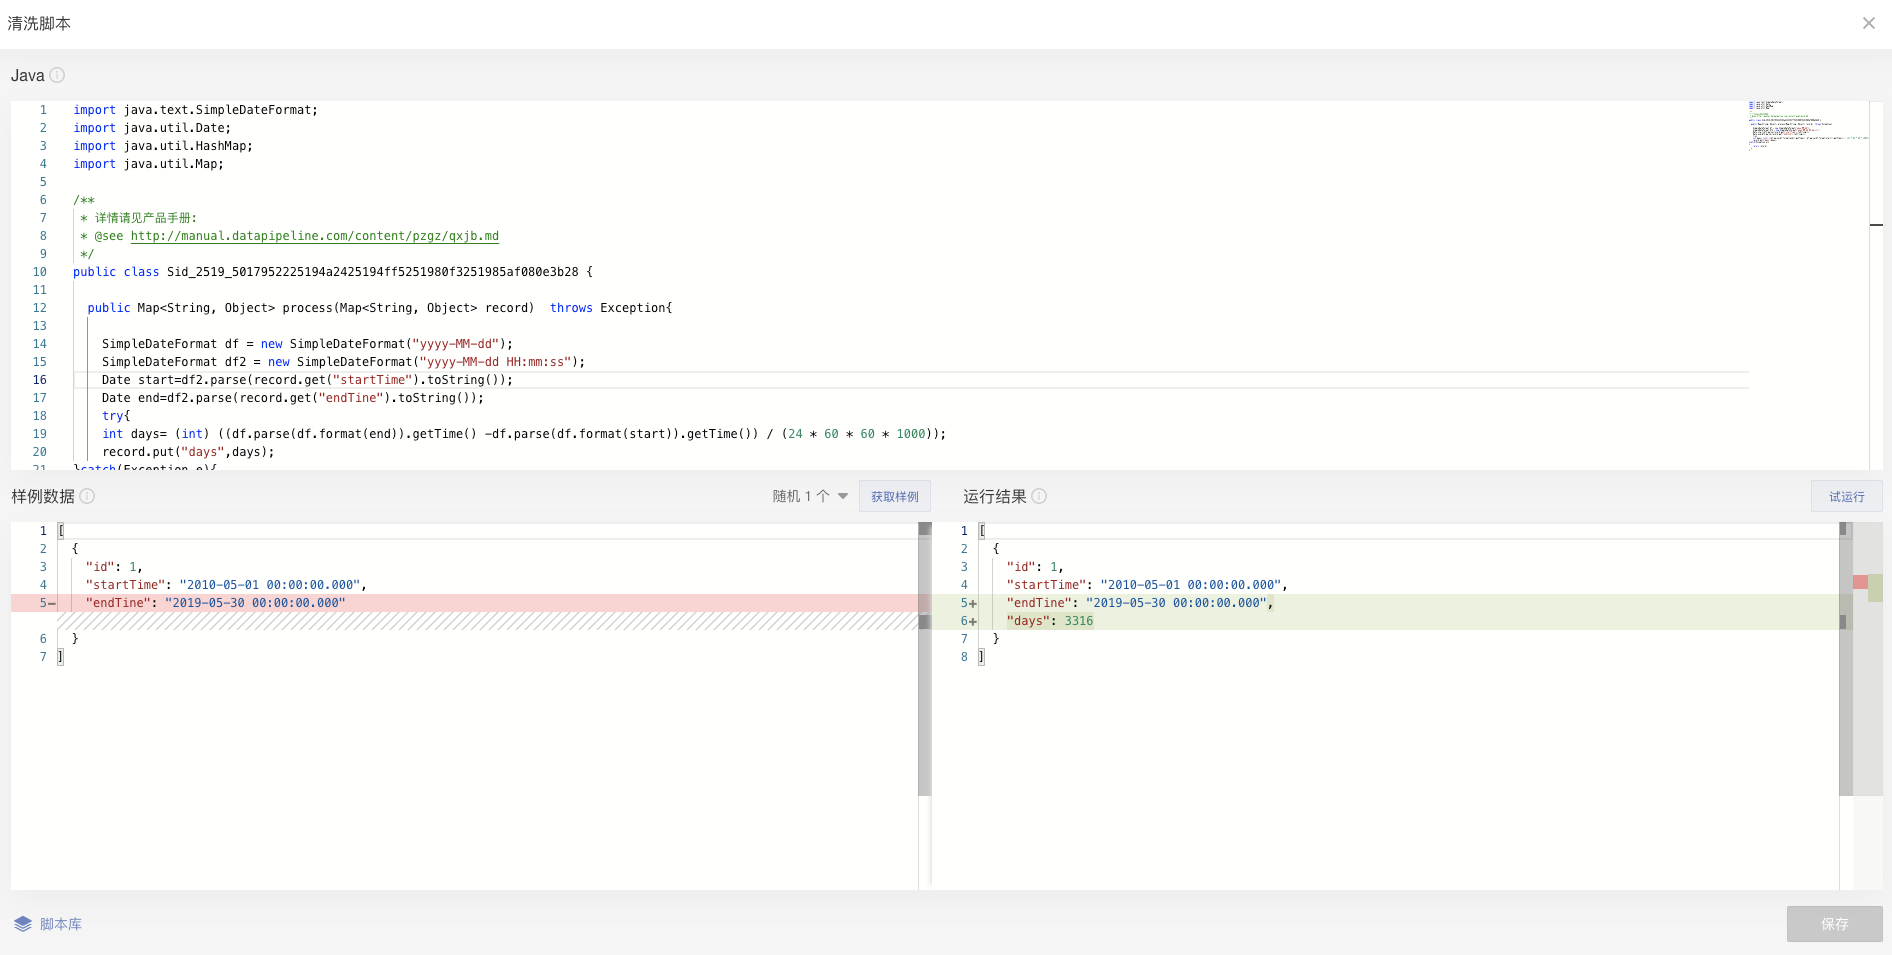
十三、非空字段判断
场景描述:判断一个字段是否为空
import java.util.Map;
import java.util.Objects;
import com.datapipeline.clients.utils.CodeEngineUtils;

public  class Example13 {
    public Map process(Map record)
    final Object orderno = record.get("orderno");
    boolean ordernoIsNull = CodeEngineUtils.isNull(orderno);
}
效果如下:
判断表字段「name」是否为空字段,在DataPipeline的「高级清洗」界面的显示如下: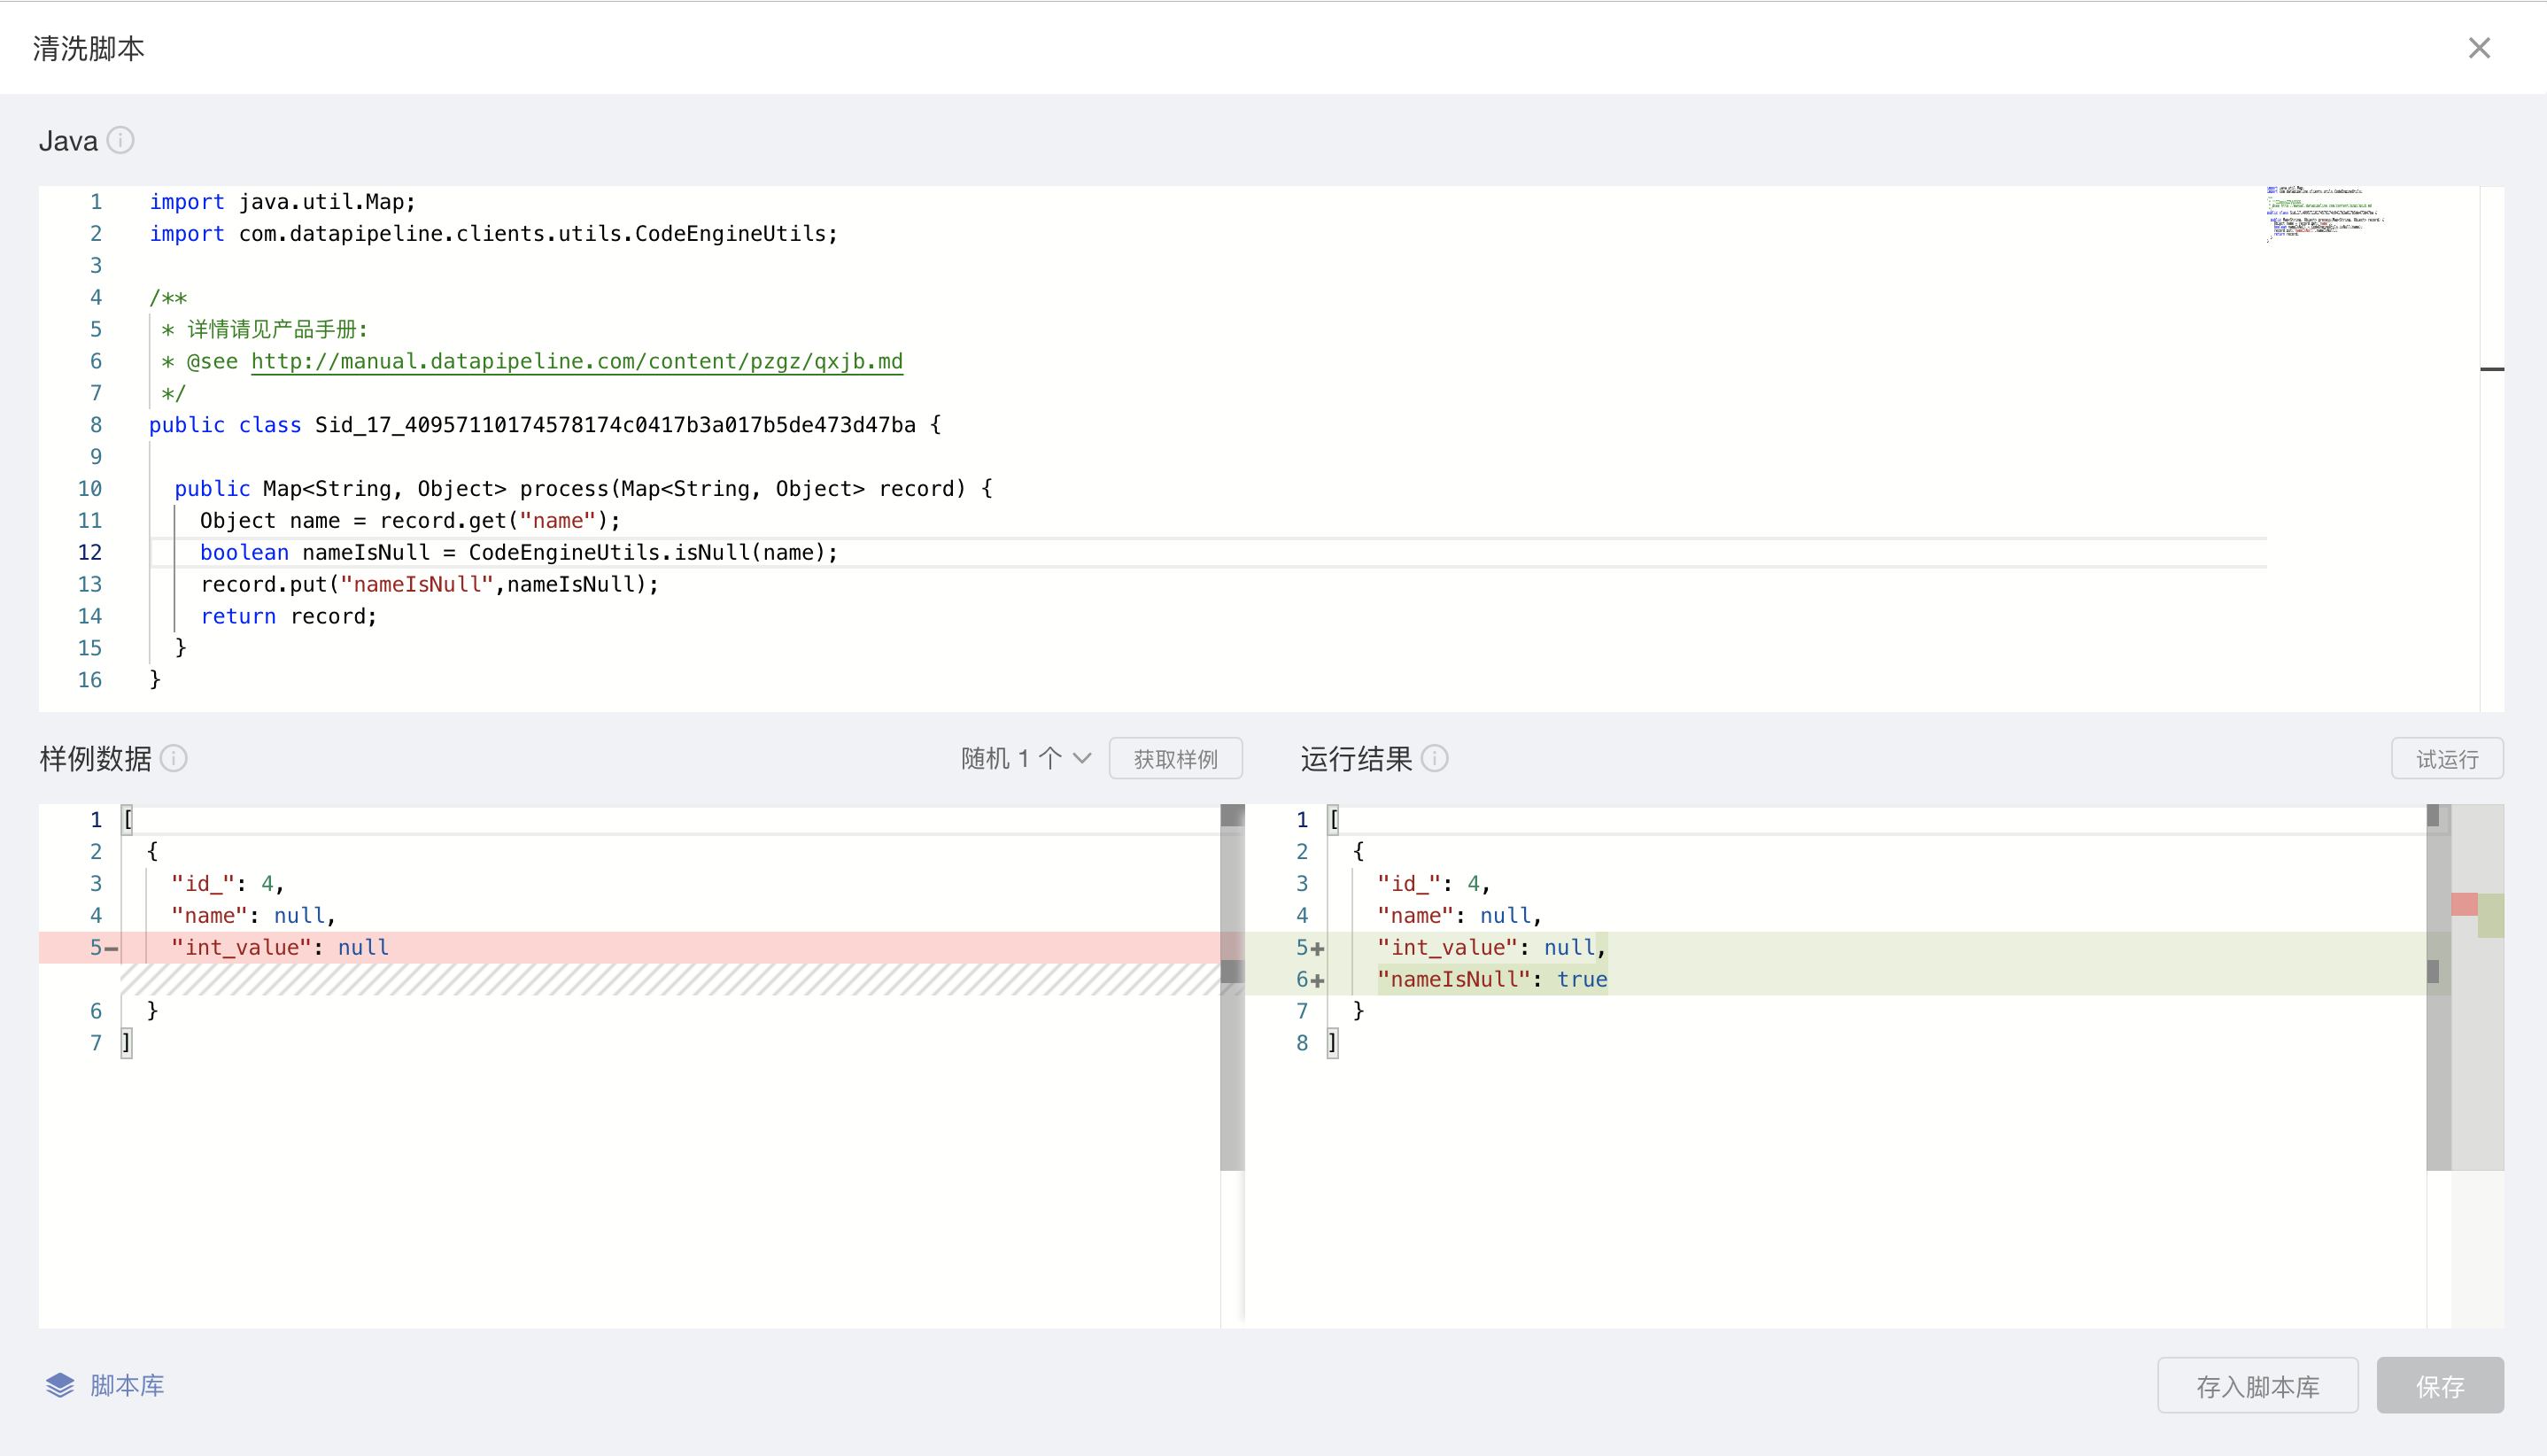
从返回结果来看,该字段为空。
十四、指定数据进错误队列
场景描述:指定某一些数据进入错误队列
import java.util.Map;
import java.util.Objects;
import java.lang.String;
import java.lang.Throwable;
import com.datapipeline.clients.codeengine.CustomizedCodeEngineException;

public class Example14 {
    public Map process(Map record) throws CustomizedCodeEngineException {
        if(Integer.parseInt(record.get("age").toString()) <= 20){
            throw new CustomizedCodeEngineException(new Exception("Illegal data!"));
        }
        return record;
    }
}
十五、时区转换
场景描述:将上海时间转化为标准时间
import java.util.Map;
import java.time.*;
import java.time.format.DateTimeFormatter;


public class localTime2standardTime {
    public Map<String, Object> process(Map<String, Object> record) {
        String crt = (String)record.get("create_time");
        try {
            long ncrt = ZonedDateTime.parse(crt,DateTimeFormatter.ofPattern("yyyy-MM-dd HH:mm:ss.SSS").withZone(ZoneId.of("Asia/Shanghai"))).toInstant().toEpochMilli();
            record.put("timestamp",ncrt);
        }
        catch (Exception e) {
            e.printStackTrace();
        }
        return record;
    }
}
十六、字符集编码转换
场景描述:当数据源的数据为乱码时,可通过高级清洗转换字符集编码,处理乱码数据。
package com.dp.exltcsv;

import java.io.UnsupportedEncodingException;
import java.util.Map;

public class utf2gbk {
    public Map<String, Object> process(Map<String, Object> record) throws UnsupportedEncodingException {
        // 针对单个字段的格式
        //        String key = (String)record.get("key");
        //        record.put(key,(Object)new String(key.getBytes("utf-8"),"gbk"));
        //        return record;

        // 针对所有字段
        for (String key : record.keySet()) {
            String value = (String)record.get(key);
            record.put(key,(Object)new String( value.getBytes("utf-8"), "gbk"));
        }

        return record;
    }
}