版本:v2.7
场景七:一对多场景介绍
场景七:一对多场景介绍
需求场景一:
用户从一个API数据源或者从KafkaTopic获取JSON数据后,通过高级清洗解析,希望将JSON中的数据写入到不同的表中,如a,b字段写到A表,c,d字段写到B表。
核心操作步骤
- 创建数据源
详情见:配置数据源 - 创建数据目的地
- 如果用户希望同步到多个数据库的多个表,则需要建立这些数据目的地。
- 如果用户希望同步到一个数据库的多个表,则需要建立多个相同的该数据目的地,并在写入设置中每个数据目的地下设置不同的表名
- 创建多个相同的该数据目的地
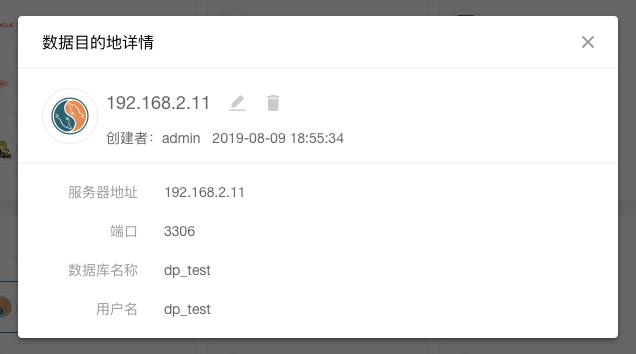
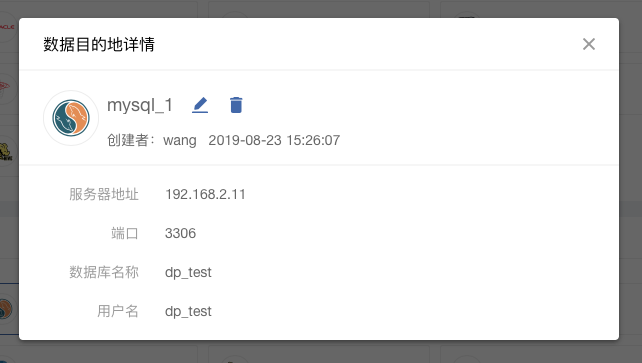
详情见:配置数据目的地
- 创建多个相同的该数据目的地
- 任务设置
任务设置主要包括了以下几个部分:
- 重要任务设置:如该任务为重要数据任务,您可在任务设置页面设置重要任务星标。
- 参与人:拥有该任务的浏览和编辑权限,可以查看数据任务的所有通知
- 数据源设置:包括选择数据源的读取方式,读取并发数量,读取速率限制,高级设置等,可根据数据的特性和用户的需求场景对数据读取进行相应设置
- 数据目的地设置:包括写入并发数量,处理速率限制,表和字段名称,高级设置等,可对数据写入进行设置
- 其他设置:包括错误队列设置和邮件通知设置
详情见任务设置
- 读取设置
- Kafka json、string数据源不会出现表结构映射,不支持设置读取条件等。
- 其他读取设置见读取设置
- 写入设置
详情见写入设置
- 写入同一数据库的多张表:
- 在不同的数据目的地下分别进行脚本清洗和目的地字段添加,实现不同的字段同步
- 例如:
在第一个目的地下,设置表名为json_1,并添加想要同步的字段,在清洗脚本中进行相应的字段清洗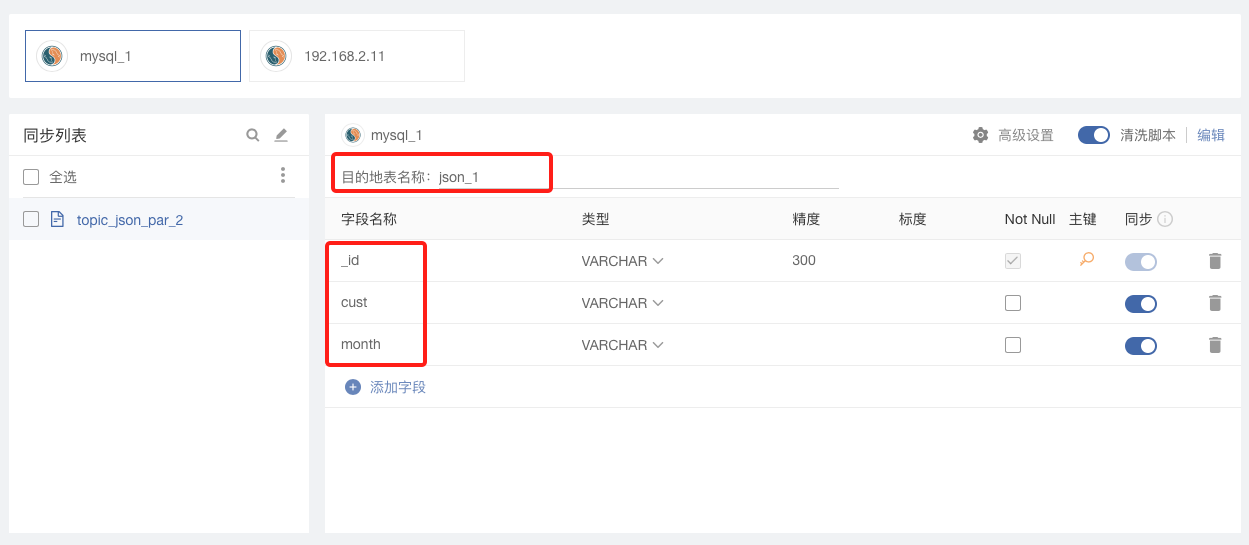
在第二个目的地下,设置表名为json_2,并添加想要同步的字段,在清洗脚本中进行相应的字段清洗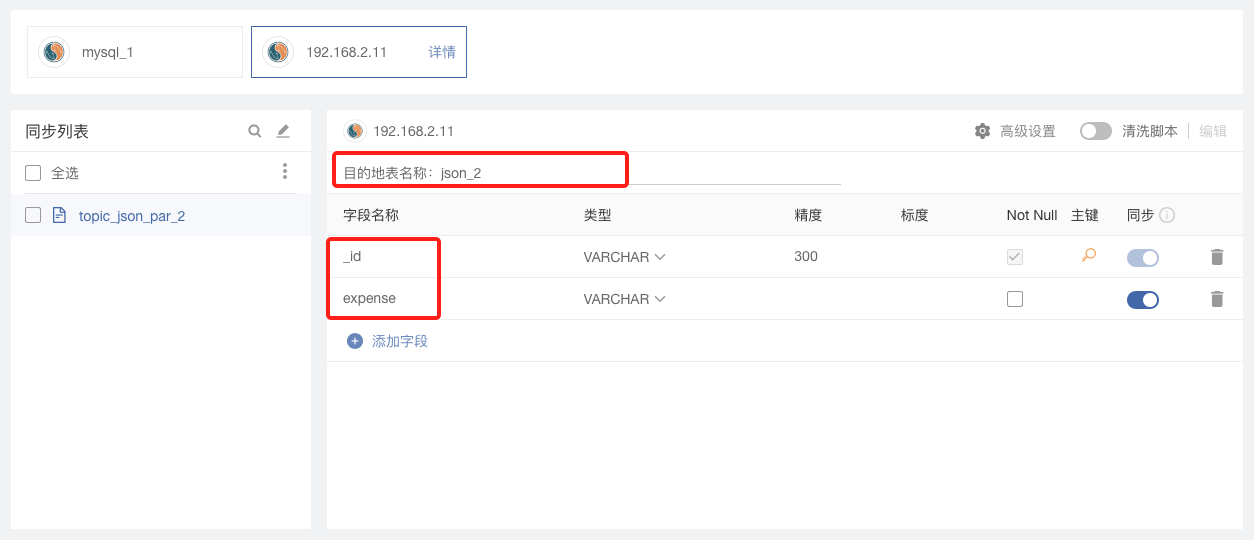
即可通过一个数据任务将同一json格式的数据源分发到不同的表中。
- 管理数据同步
详情见管理数据同步
需求场景二:
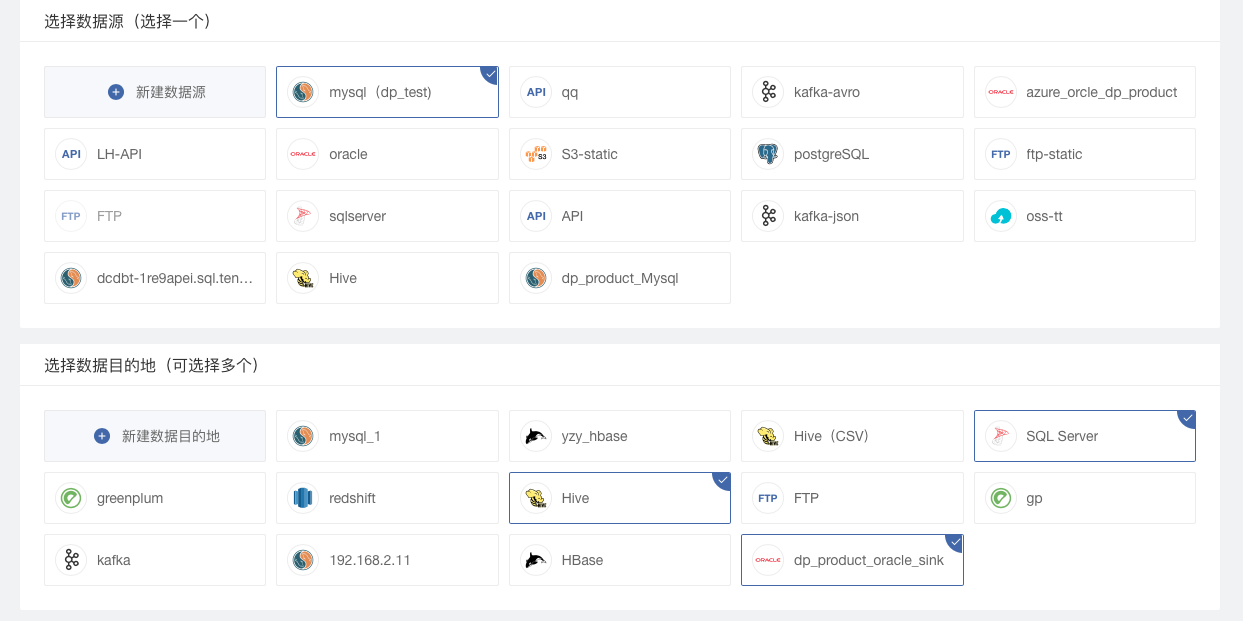
用户希望创建一个数据任务,并从一个关系型数据库表实时(或定时)分发到多个数据目的地。在历史版本中,用户需要创建多个任务来解决,但创建多个任务执行该需求时会重复读取数据源同一张表的数据,比较浪费资源。用户更希望只读取一次便可直接解析为多个表,完成该需求场景。
核心操作步骤
- 参与人:拥有该任务的浏览和编辑权限,可以查看数据任务的所有通知
- 数据源设置:包括选择数据源的读取方式,读取并发数量,读取速率限制,高级设置等,可根据数据的特性和用户的需求场景对数据读取进行相应设置
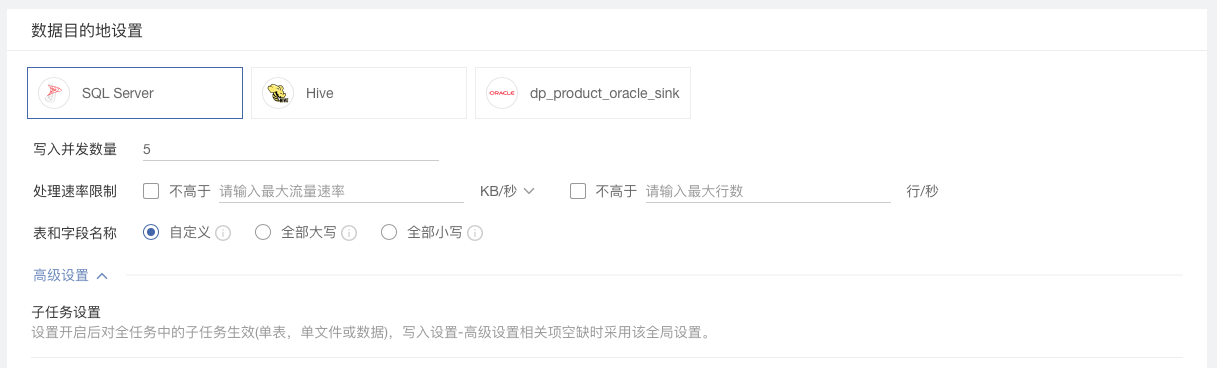
- 数据目的地设置:包括写入并发数量,处理速率限制,表和字段名称,高级设置等,可对数据写入进行设置
需要分别在每个数据目的地下分别设置。
- 其他设置:包括错误队列设置和邮件通知设置
详情见任务设置。
- 读取设置
读取设置主要包括几个部分:
- 同步列表:用户选择的要同步的表
- 表结构:选中某个表后,会展示该表的字段名称、类型、精度、标度、Not Null等信息
- 传输队列设置:可对每个表单独进行设置,优先级高于任务设置中的传输队列设置
- 读取条件:可编辑where语句对数据进行筛选,符合条件的数据才会被读写
具体设置见读取设置
- 写入设置
该页面主要包括:
- 同步列表:用户选择的要同步的表,可点击进行切换,对每个表的写入规则进行设置
- 映射列表:从数据源到目的地的映射详情,可对目的地表名、字段名、类型、精度、标度、Not Null、主键、是否同步字段等进行修改,可以添加和删除字段
- 高级设置:可以进行子任务Batch 设置,是单表级别的设置,优先级高于任务设置中的子任务设置
- 清洗脚本:可以开启后进行编辑,自定义对数据完成一些替换或清洗操作
需要在每个目的地下分别进行写入设置。详情见写入设置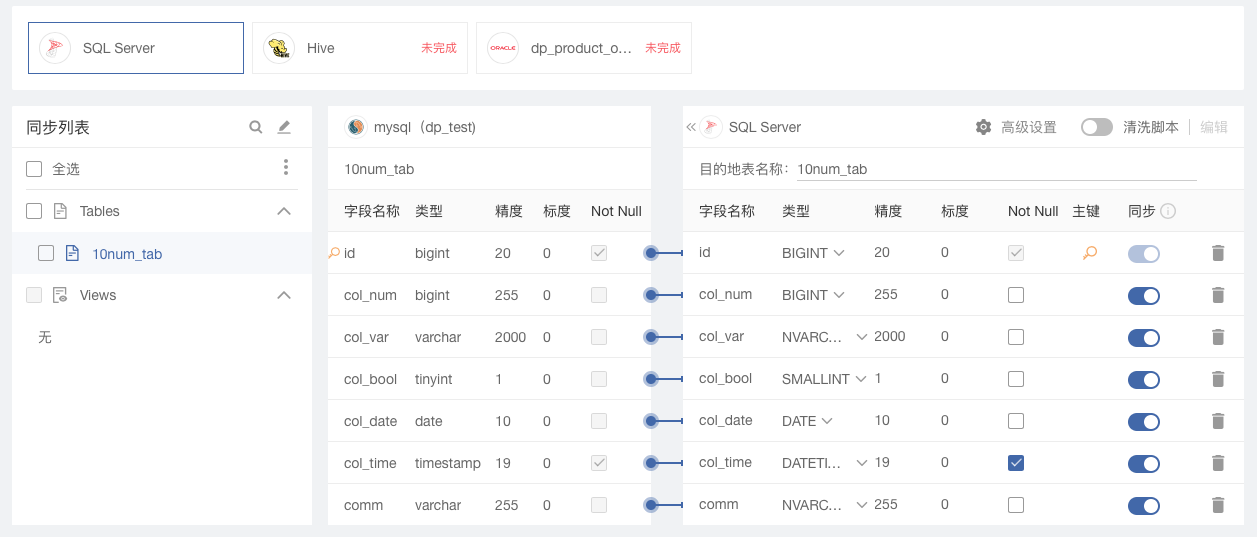
- 管理数据同步
详情见管理数据同步