版本:v2.7
场景一:实时同步异构数据库数据(例:MySQL到Oracle)
场景一:实时同步异构数据库场景(MySQL到Oracle为例)
一、核心流程
创建数据源 & 目的地
任务设置
读取设置
写入设置
管理数据任务
二、 创建数据源
- 单个数据任务只允许选择一个数据库类型作为数据源
- 关系型数据库目前支持「MySQL」、「Oralce」、「SQL Server」、「PostgreSQL」作为数据源。
详情见:配置数据源
三、创建数据目的地
- 单个数据任务允许选择多个数据库作为数据目的地。
- 关系数据库目前支持「MySQL」、「Oralce」、「SQL Server」、「AnalyticDB for PostgreSQL」、「TiDB」
详情见:配置数据目的地
四、任务设置
- 确定读取端和写入端数据库后,点击「下一步」,进入任务设置。
- 如该任务为重要数据任务,您可在任务设置页面设置重要任务星标。
- 用户需要设置:参与人、数据源设置、数据目的地设置、其他设置
- 参与人设置
- 「参与人」拥有该任务的浏览和编辑权限,并且会在通知中心收到该数据任务的所有通知,包含:
- 操作记录;
- 数据任务错误信息;
- 错误队列信息。
- 数据源变化设置
- 「参与人」拥有该任务的浏览和编辑权限,并且会在通知中心收到该数据任务的所有通知,包含:
- 设置当前任务数据源使用资源组,通过合理分配任务与资源组,可使重要任务计算资源得到保障。
- 设置读取方式,以MySQL数据库为例,会提供两种读取方式:Binlog(实时模式) & 批量读取
- Binlog
- 可达到秒级别读取MySQL实时数据。
- 若发现无法勾选Binlog读取模式(或其他数据库实时模式),请查看Binlog配置方法 (其他数据库实时模式也可点击查看)
- 读取起点默认为「激活任务为起点」,指任务激活后数据源产生数据会根据Binlog解析视为同步对象。
- 若用户需要从历史Binlog位置开始读取,则可以选择「自定义」,并完成输入Binlog Postion(必填)、Binlog文件名称(必填)、GTID(选填)。
- 若用户在同步Binlog实时同步数据前要迁移该数据库存量数据,可开启「存量数据读取」。激活任务后系统将通过SELECT * FROM table_name方式(读取设置步骤可以添加WHERE语句)读取存量数据,完成存量数据同步后再进行Binlog读取模式。
- Binlog
- 读取并发数量
- 读取并发数量是指该任务从数据源中并行读取表的数量,默认为5。
- 具体读取并发数量要根据数据源可接受请求量决定。
- 详细策略:并发数量代表着并行读取表的数量,当表读取完毕时系统会释放掉该线程,其他的表可继续抢占该线程进程数据的读取。任务暂停后又重启所有的表会重新抢占线程,系统会按照断点续传的方式继续同步新增数据。
- 读取速率限制
- 当用户设置读取速率限制,系统平均读取速率将不会超过该数值。
- 可按流量或行数作为限制条件。
- 用户能够不选、单选或多选,若同时勾选,两种限制将同时应用。
- 勾选后即可激活对应的速率限制,请输入正整数;
- 数据源高级设置包含:
- 传输队列最大缓存值
- 任务开始读取数据后,单个任务默认缓存10GB数据(读写数据量差),用户可自定义。
- 读写数据量差达到10GB(最大缓存值时),根据先进先出的原则,旧数据将会被回收。
- 当任务数据读写速率失衡,读写数据量差大于10GB(最大缓存值)时,将会出现部分数据被回收,未能成功写入数据目的地的情况。
- 传输队列回收时间
- 任务开始读取数据后,单个任务默认缓存3天数据,用户可自定义。
- 缓存数据达到回收时间,旧数据将会被回收。
- 当任务数据读写速率失衡,超过回收时间的数据尚未被写入到目的地,将会出现部分数据被回收,未能成功写入数据目的地的情况。
- 数据任务动态限速
- 开启后该数据任务读写数据量差达到「最大缓存值」,任务将会暂停数据读取工作。当实际缓存数据量小于「最大缓存值」时会重新开始读取数据。
- 可根据用户情况自定义「检查频率」
- 读取端事务一致性
- 用户「关闭」该选项,DataPipeline 从数据源读取数据后,将会立即写入到目的地。
- 用户「开启」该选项,DataPipeline 从数据源读取数据后,系统定期记录读取的进度,数据对应的进度被成功记录了,才会被允许写入到目的地。以此来保证系统出现重启或者rebalance的情况时,根据系统明确的标记信息来保证目的地数据的一致性。
- 传输队列最大缓存值
- 数据目的地设置
- 数据目的地资源组设置,设置当前任务读取端使用资源组,通过合理分配任务与资源组,可使重要任务计算资源得到保障。
- 写入并发数量
- 基本逻辑与「读取并发数量」一致。写入并发数量是指该任务从数据源中并行写入表的数量,默认为5。
- 具体写入并发数量要根据数据源可接受请求量决定。
- 写入速率限制
- 当用户设置写入速率限制,系统平均写入速率将不会超过该数值。
- 可按流量或行数作为限制条件。
- 用户能够不选、单选或多选,若同时勾选,两种限制将同时应用。
- 勾选后即可激活对应的速率限制,请输入正整数;
- 表和字段名称大小写
- 支持用户设置目的地表名称和字段名称大小写
- 选择【自定义】,任务执行后,系统会根据用户自定义的表和字段名称写入到目的地。
- 选择【全部大写】,任务执行后,系统会将用户设置的所有表和字段名称转换为大写(只包含英文)后写入到目的地。
- 选择【全部小写】,任务执行后,系统会将用户设置的所有表和字段名称转换为小写(只包含英文)后写入到目的地。
- 数据目的地高级设置
详情见:子任务设置
详情见:数据源变化设置
详情见:写入一致性
五、读取设置

进入读取设置页面,用户首先需要选择读取对象,保存后即可看到上图页面。
A.同步列表
- 读取列表显示该任务实时读取的表,点击任一表名称右侧显示该表的表结构。
- 提供搜索功能,主要支持搜索表名称。
- 点击「编辑」,可重新选择读取对象。
- 提供「批量设置」功能,包括:批量移除读取对象,批量设置执行语句。
B.传输队列设置
- 若用户针对某一个表进行传输队列的自定义设置时,可点击表结构右上角的「传输队列设置」。
- 功能与任务设置的「传输队列设置一致」,但用户设置了表级别的「传输队列设置」,该标的传输队列策略会依照该设置。
C.执行语句
- Binlog模式不会使用SQL语句读取数据,但在本次案例中用户在任务设置中选择了「存量数据读取」,所以用户激活任务后会先执行SQL语句,同步存量数据后再监听Binlog同步实时数据。
- 执行语句默认为:SELECT * FROM table_name , 若用户需要添加读取条件,则点击「编辑读取条件」增加WHERE条件。
- last_max()方法是DataPipeline提供的函数,目的是帮助用户解决批量只读取增量数据的,所以在本次案例中不会用到。
- WHERE条件语句要求符合数据源类型格式要求,可使用数据库本身提供的方法。
- 用户可点击「试运行」查看SQL语句是否正确,试运行最多请求10条数据(limit 10)。
六、写入设置
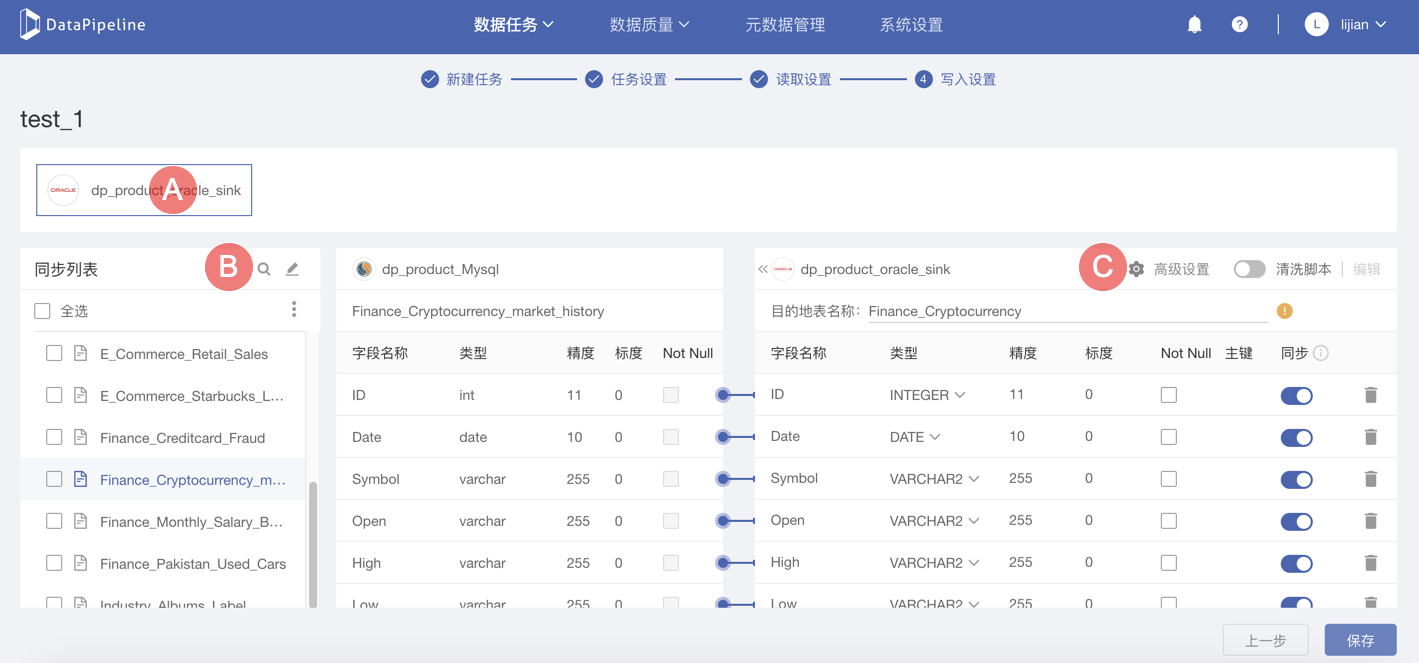
A.目的地列表
- 若用户选择多个目的地作为该数据任务的写入目标,此处会显示多个目的地,用户可点击切换各个目的地的写入设置内容。
B.写入列表
- 写入列表显示本次任务中,哪些数据源表会写入到该目的地。
- 提供搜索功能,主要支持搜索表名称。
- 点击「编辑」,可重新选择写入对象。
- 提供「批量设置」功能,包括:
- 批量移除读取对象。
- 批量设置表名称(主要用于多表同结构数据往目的地一张表写入场景)。
C.目的地表结构设置
- 点击任一表名称右侧显示每个目的地表的映射关系(左侧是数据源表结构)。
- 若数据目的地没有同名表,激活任务后DataPipeline会在目的地创建新表。
- 若目的地已存在同名表,目的地表名称右侧会有提示。
- 若该任务往已创建的同名表写入数据,会检查表结构是否一致。
- 若表结构一致(只检查字段名,不检查字段类型和其他属性),则正常写入数据。
- 若表结构不一致(少字段或多字段),则强制改为用户设置的表结构后再进行数据同步。
- 关于高级清洗使用方法请见:设置清洗脚本
- 目的地表结构用户可修改字段名称、类型、精度、标度、Not Null、主键等属性
- 「同步」功能
- 开启「同步」,任务激活后该字段数据会写入到目的地。
- 关闭「同步」,目的地依然存在该字段,但不会同步该字段值,会传空。
- 支持用户删除字段或添加字段,添加字段的值需要通过高级清洗指定逻辑。详见:设置清洗脚本
- 完成所有写入设置后,即可「保存」,即可以一键开始同步数据。
- 「同步」功能
数据任务详情页
「数据任务统计」
- 已读取数据量:
- 指 DataPipeline 从数据源已读取的数据量。
- 当 DataPipeline 系统重启,会根据断点续传机制从上一次读取记录点开始重新读取数据,重复读取的数据量不会记录到已读取数据量里。
- 无主键的定时同步时全量替换数据,故每次定时读取全量数据,数据源没有更新的数据会再次读取。
- 已处理数据量:
- 指 DataPipeline 已处理的数据量,这里包括:同步到数据目的的数据量和进入到错误队列的数据量。
- 当 DataPipeline 系统重启,会根据断点续传机制从上一个读取记录点开始重新写入部分数据,但这部分数据不会记录到已写入数据量里。
- 错误队列:指已读取的数据中系统判断无法写入到数据目的地,而异步放到错误队列中的数据量。:
- 读取速率:指DataPipeline从数据源读取数据的速率。
- 处理速率:指DataPipeline处理数据的速率
「复制任务」
详情见:复制任务
「错误队列」
详情见:错误队列
「消息列表」
详情见:消息列表
「回滚功能」
详情见:回滚功能
「重新同步」
详情见:重新同步功能
常见问题
Q1:读取模式失效的,复制任务后任务以何种方式读取数据?
原任务读取模式失效,复制后的任务采用任务设置的默认选择。
Q2:数据表失效的,复制任务后的任务是否还同步失效的表?
数据表选择失效的,复制后新任务不再选择失效表。