版本:v2.7
写入设置
写入设置
1.什么是「写入设置」?
写入设置界面将展示出数据源以及目的地表结构之间的映射关系,用户可以修改目的地表结构,设置清洗脚本以及高级设置等功能来实现需要同步的数据。
DataPipeline提供可视化操作界面,帮助用户零开发完成自定义表名、字段名称,过滤、清洗脚本等「数据清洗」功能。
2.「写入设置」支持哪些功能?
3. 如何配置「写入设置」界面?
勾选导入列表(集合)后,显示写入设置页面。
「Table 列表」
- Table 列表显示将同步到目的地的数据源表名称,可点击列表顶部「编辑」按钮以及批量操作按钮。
- 批量操作,详情见:批量功能
- 在列表中选择数据源表,右侧会显示该数据源表和目的地表的映射关系详情。
- 用户可浏览该数据表的内的所有字段和类型在数据源和目的地之间的映射关系:
- 系统将实时检测各表名称是否符合目的地表名称要求;
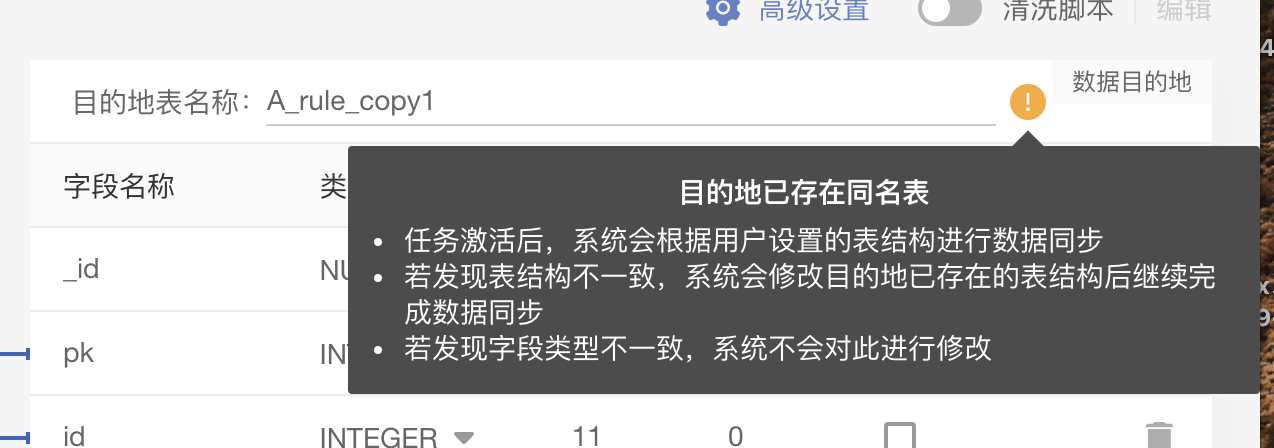
- 若存在同名表将会提示用户「目的地已存在同名的表」。
- 目的地为Kafka的任务,将检验目的地是否已经存在的Topic名称,若不存在将提示「Topic名称不存在」;
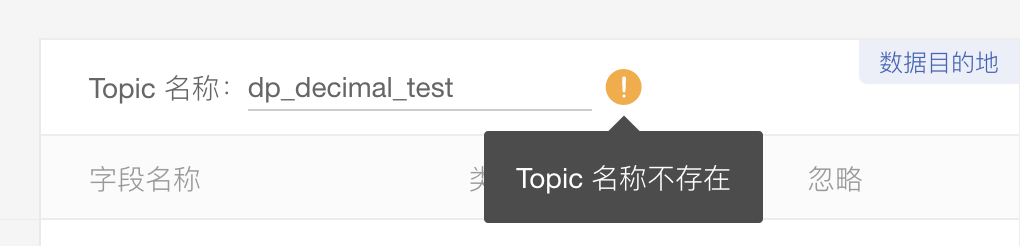
- 若用户Kafka目的地支持自动创建Topic,则该任务激活后将自动创建该Topic;
- 若用户Kafka目的地不支持自动创建Topic,则要求用户输入已存在的Topic后才可点击保存。
- 支持对目的地表名称的自定义修改;
- 支持对目的地表的字段名称的自定义修改;
- 修改规则请参考下表:
- 若不符合规则,则会提示用户具体错误信息。
| 数据目的地类型 | 自定义表名称限制 | 自定义字段名称限制 |
| --- | --- | --- |
| MySQL、Oracle、SQL Server、AnalyticDB for PostgreSQL、Redshift 、TiDB、Greenplum、Hive、HDFS、HBase | 只允许英文、下划线和数字。 | 只允许英文、下划线和数字;
不支持同名字段 | | FTP、Kakfa | 只允许英文、下划线、数字、点和横杠。 | |
- 若不符合规则,则会提示用户具体错误信息。
| 数据目的地类型 | 自定义表名称限制 | 自定义字段名称限制 |
| --- | --- | --- |
| MySQL、Oracle、SQL Server、AnalyticDB for PostgreSQL、Redshift 、TiDB、Greenplum、Hive、HDFS、HBase | 只允许英文、下划线和数字。 | 只允许英文、下划线和数字;
- 系统将实时检测各表名称是否符合目的地表名称要求;
- 用户可浏览该数据表的内的所有字段和类型在数据源和目的地之间的映射关系:
「数据源表结构」
「数据目的地表结构」
目的地表结构默认显示:数据源表结构经过Schema Mapping后的表结构。
数据目的地表结构会根据目的地类型的不同而展示不同的内容
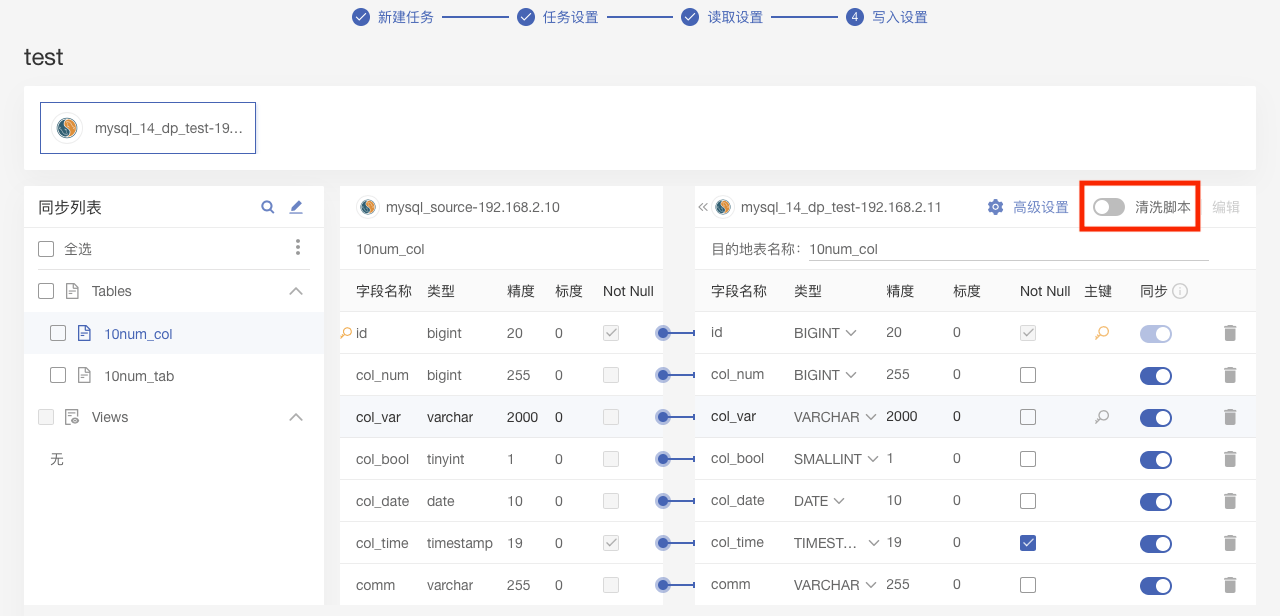
支持修改目的地字段(包括主键)
可编辑字段名称、类型、标度、精度、主键/唯一键、Not Null、同步按钮以及删除按钮。
- 字段类型:显示该数据目的地的所有字段类型,用户可根据需要设置相应的字段名称。
- 精度、标度:允许为空,空值代表为目的地默认值;只允许输入整数,(Oracle数据库Number字段类型的标度允许输入负整数)
- DataPipeline中的精度和标度在不同数据库中代表的意思如下:\ | DataPipeline | 精度 | 标度 | | --- | --- | --- | | MySQL | Length | Decimals | | Oracle | Size | Scale | | SQL Server | Size | Scale | | Postgre SQL | Length | Decimals |
主键。
- 目的表可设置多个主键,但不允许没有主键。
- 主键字段主要是用于目的地数据的去重。允许设置多个主键字段去重。不允许为空值。
唯一键(目的地为hive、kafka、FTP数据目的地时)
- 目的地表可设置多个唯一键,按默认规则组合唯一键去重;选择1个,选中字段直接用于唯一键去重;指定多个唯一键时,后端自动生成唯一键虚拟值用以去重筛选。但唯一键的去重逻辑只适用于每批数据的去重,不同批次的数据无法实现去重。
支持删除目的地字段
- 删除字段后,用户激活数据任务,系统在创建目的地表时,不会创建该字段。
- 激活前允许用户去恢复字段,点击【恢复字段】,重新显示该字段
- 数据源新增字段与用户在激活任务前删除的字段同名,要求在该表底部新增一个同名字段,不覆盖当前的已被操作删除的字段。
支持新增目的地字段
- 点击【添加字段】,要求在目的地表最后一行新增一个字段,激活任务后该字段会被同步到目的地表中。
- 新增字段的数据来源要求用户在【高级清洗】逻辑中添加。比如:
- 增加字段【InsertTime】,该逻辑可在高级清洗逻辑中实现。
- 合并字段A+字段B值,该逻辑可在高级清洗逻辑中实现。
关于自增_id需求变化
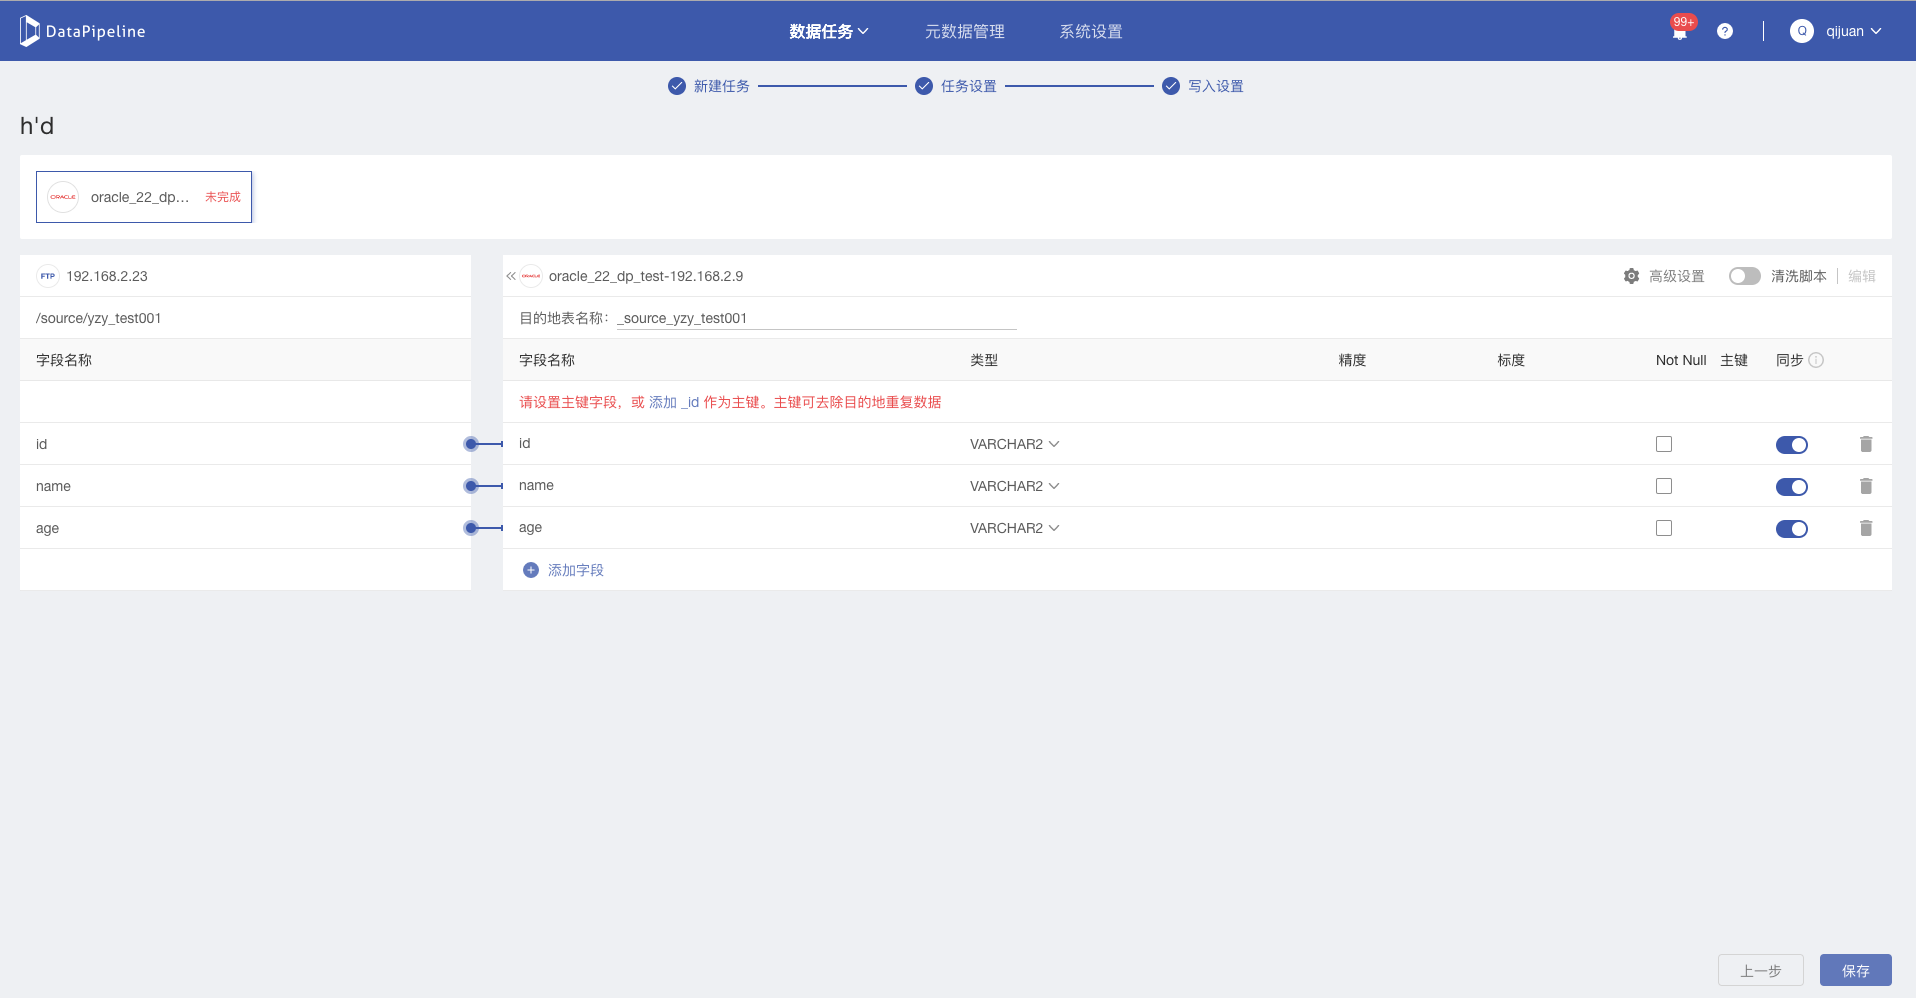
- 当数据源表没有主键字段,或数据源为文件系统时,系统会在目的地中新增一个_id字段作为主键以保证目的地数据的唯一性。
- 当目的地为Hive、 Kafka、FTP、HDFS时,目的地中新增一个_id字段作为唯一键以保证目的地数据的唯一性。
- 目的地表结构首行默认添加_id字段作为主键/唯一键。
- 为保证目的地数据的唯一性,不允许去掉自增_id
- 点击【添加_id】,在目的地表结构首行添加【_id】字段,并标记为主键,如果目的地已有【_id】字段,则添加为【 _ _ id】,依次类推。
- 允许修改字段名称、字段类型、标度、精度
Not Null:指该字段值不能为空,当用户勾选了not null,源端的字段为空时,系统会报错提示。
同步按钮
- 开启同步按钮,则系统会同步该字段数据,
- 关闭同步按钮,则系统只会同步该字段,但不会同步该字段的值。
动态修改表结构
- 当任务激活后想要修改目的地表结构时,可以暂停任务,进行增减字段的操作,逻辑与上述删除字段和新增字段的逻辑保持一致。
常见问题:
Q1:如果自定义目的地表名时创建了多个同名表会发生什么?
当您激活任务后,系统将尝试把数据源多张表的数据传输到同一个表中,此时:
- 若这些表的表结构一致,则多张表能够成功合并为同一张表;
- 若该表与目的地同名表的表结构不一致,根据目的地表结构设置修改目的地原有的同步表。
Q2:关于字段名称修改需要注意什么?
Oracle中数据表的字段名称可能同时含有大小写,当选择的目的地为其他不支持同时含大小写字段名数据表的数据库(例如 Mysql )时,若您使用默认的映射关系,不修改目的地表字段名称,数据目的地将把表字段名称中的大小写视作一致;
- 例如:当您选择了 Oracle 中的一个含字段 Aa 、 aA 的数据表作为需要同步的表,数据目的地选择了 Mysql ,如果未修改对应的目的地字段名称,则 Mysql 目的地将把这两个字段视作同名字段进行传输,可能会导致问题。