版本:v2.7
Hive数据源读取分区设置
数据源为Hive时
源端表结构中显示源端分区字段,支持分区字段的同步
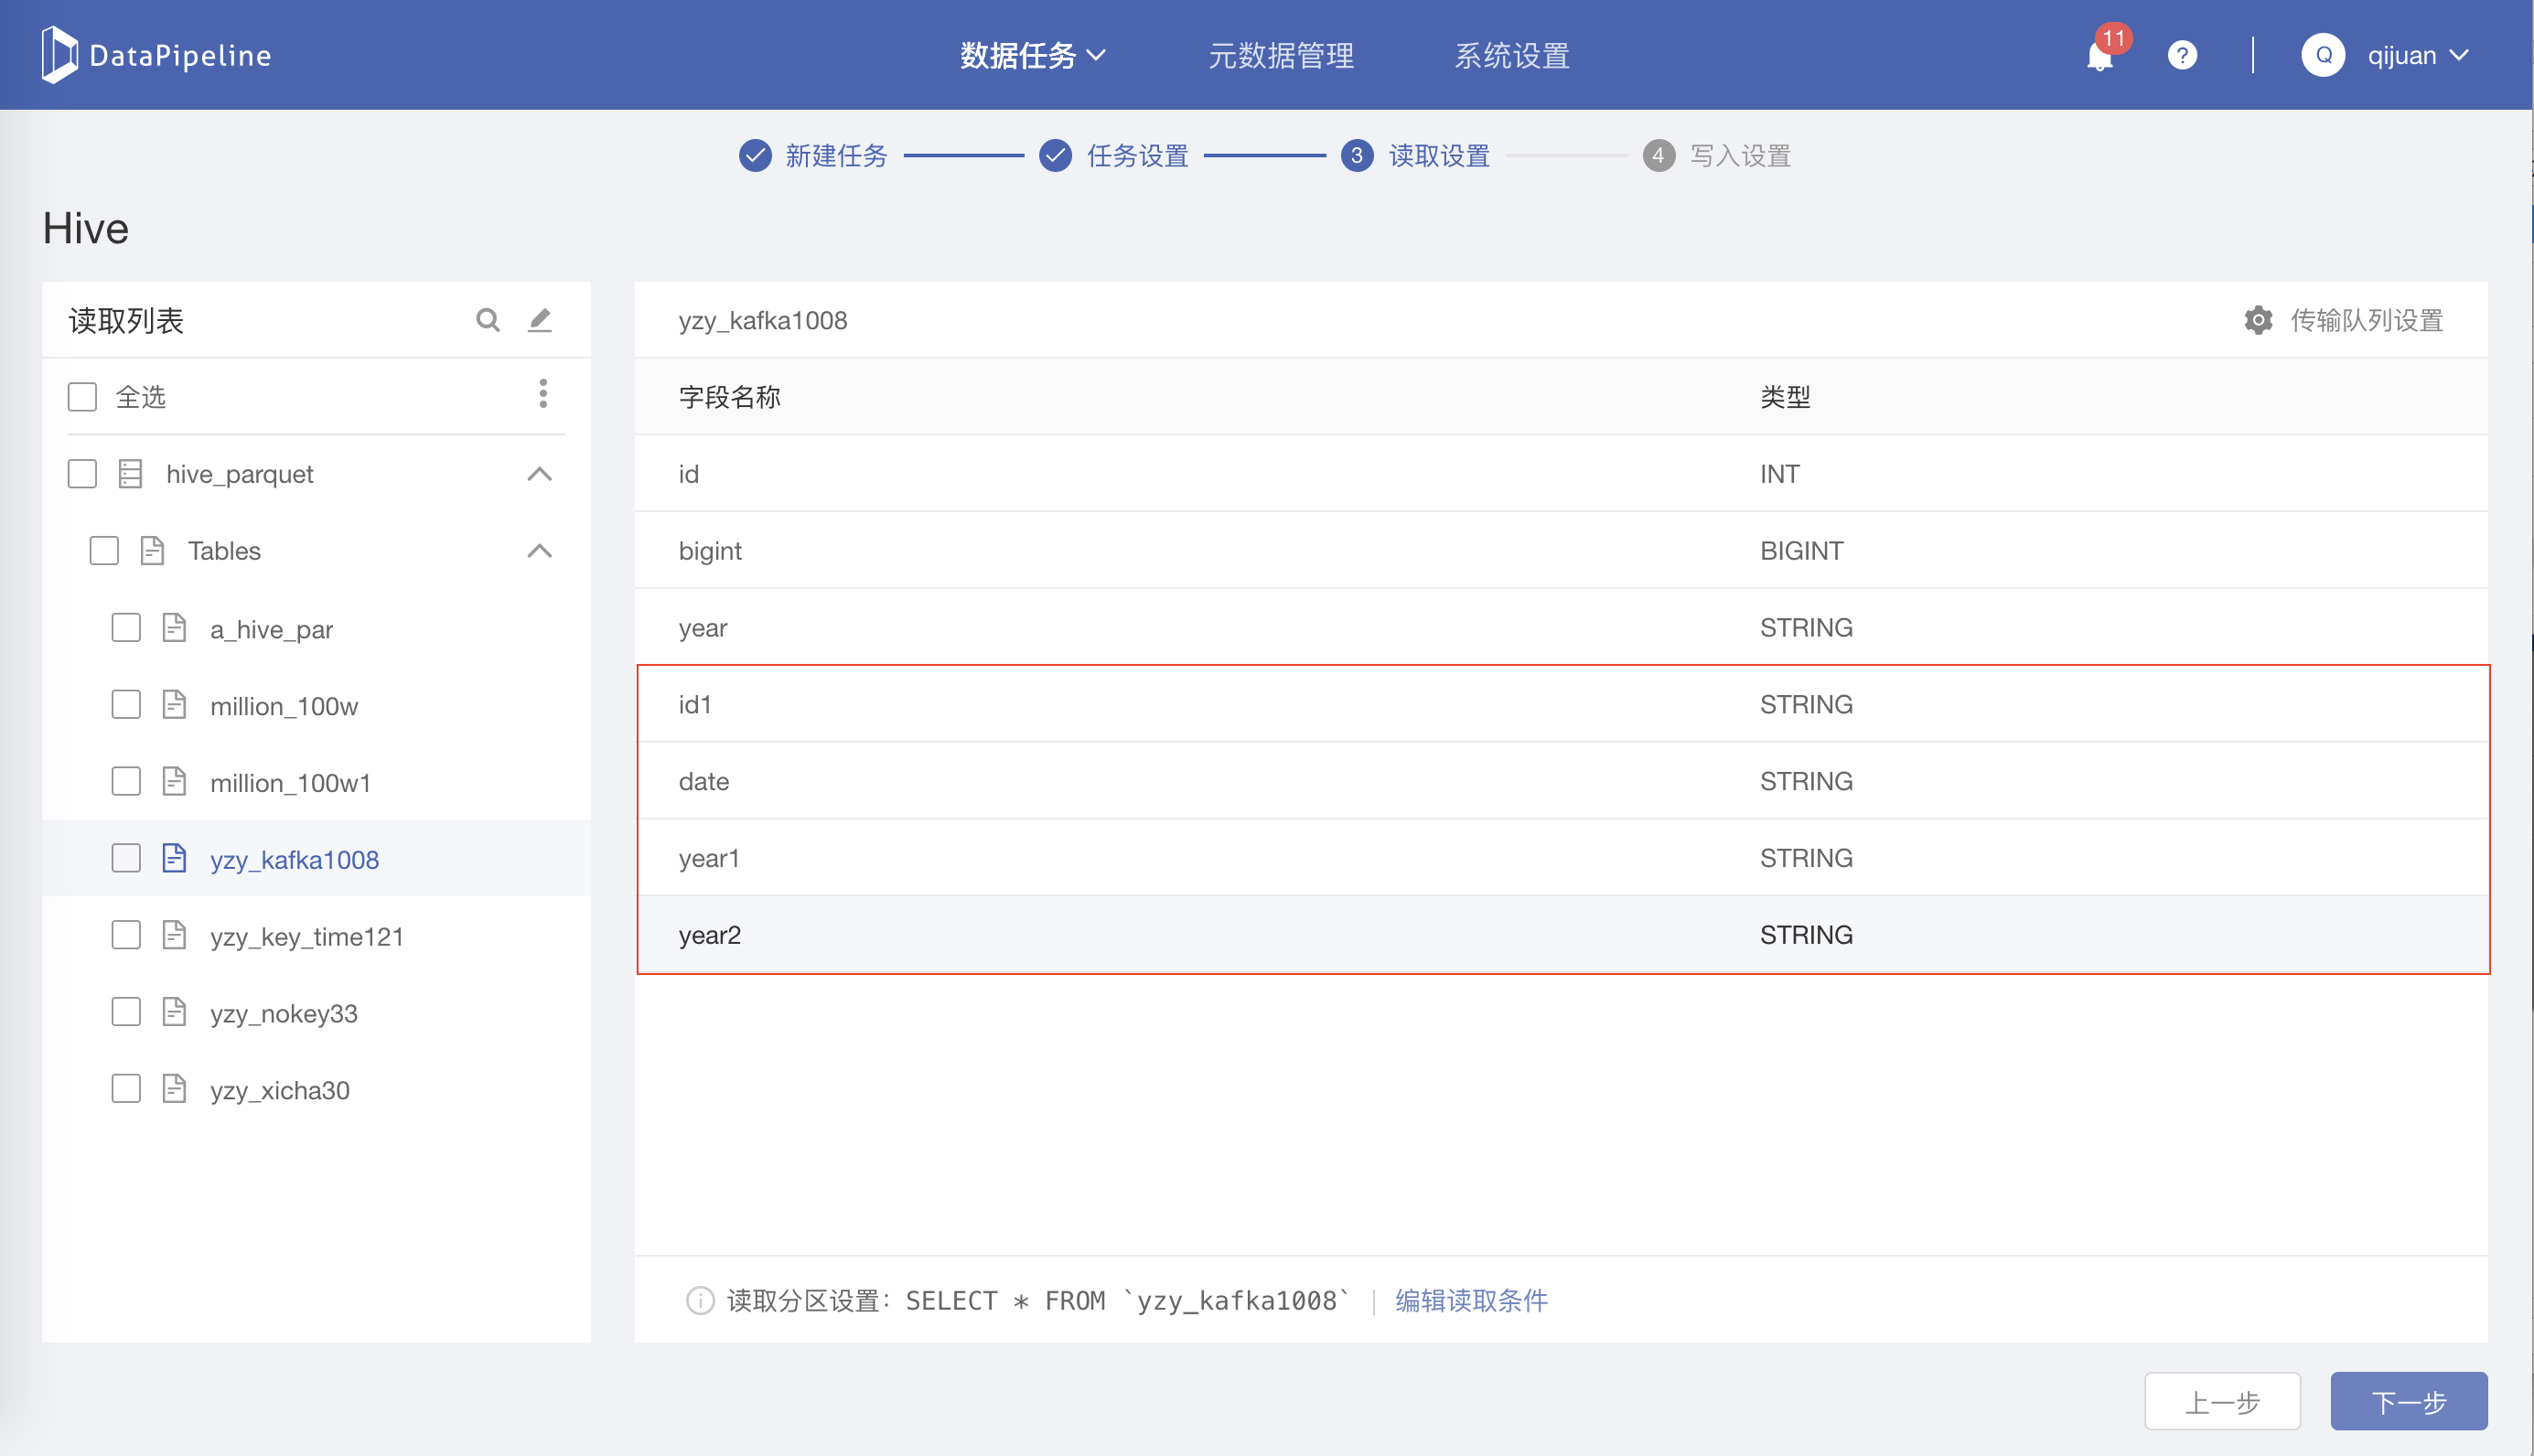
数据源表结构每一个表增加读取分区设置

- 每个表结构下提供:「读取分区设置」区域。
- 默认为读取所有分区数据,若用户未自定义读取分区,则系统每次都会读取整个表的所有分区数据。
- 当用户设置了读取分区设置时, 默认为只对用户设置的读取规则来进行数据读取。
- 点击「编辑读取条件」,立即弹窗显示编辑窗口。
- 用户可以参照左侧的样例来输入自定义的读取条件。
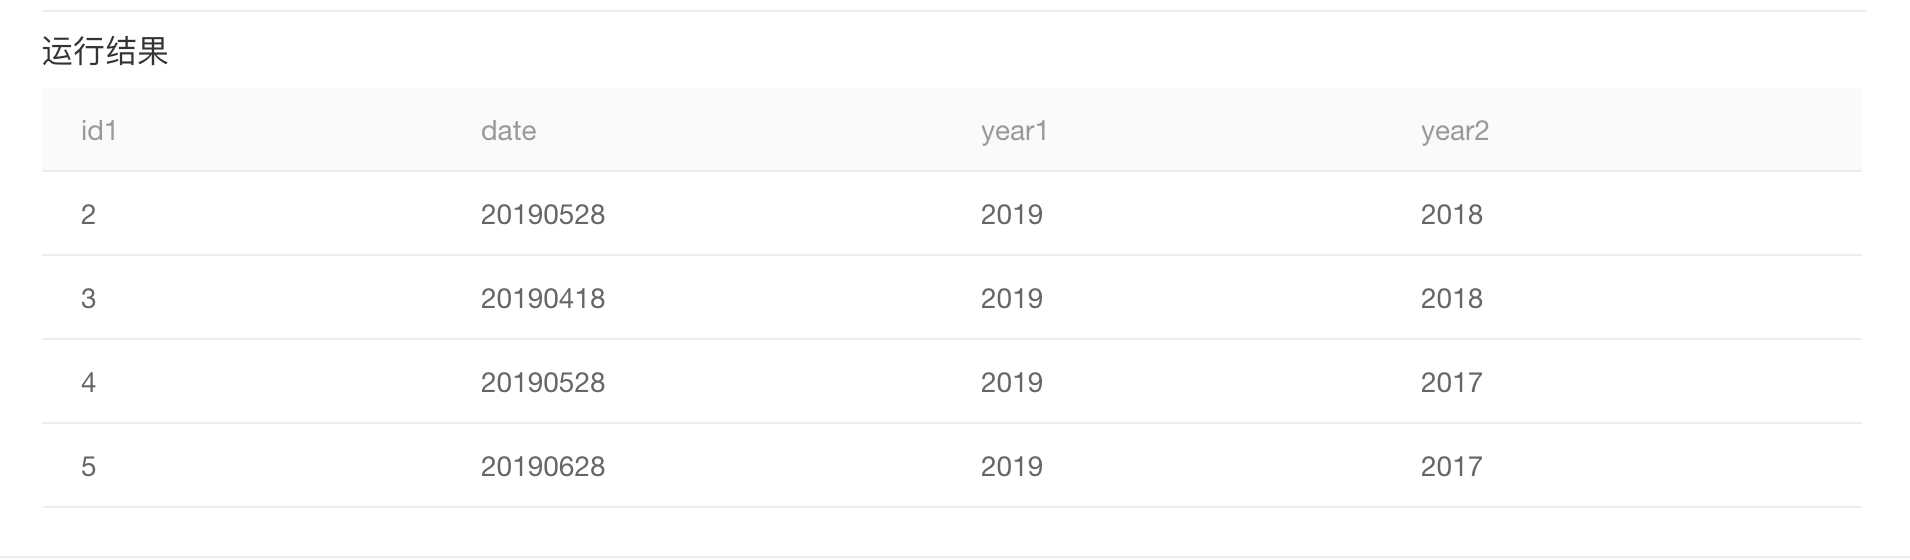
- 提供「试运行」按钮。
- 点击后执行当前sql语句,系统会返回增加 limit 10的结果供用户参考。
- 样例介绍
- 用户可根据需求设置分区读取条件,DataPipeline 提供用户设置的读取条件来定时读取分区数据,以下举出三个例子进行说明。
- 例子一:以分区字段作为读取条件,同步已有分区中的分区字段的最大值。每次执行批量读取时,系统会过滤出分区字段的最大值,假设分区字段的最大值已经同步过则不会再次同步。
- SELECT * FROM
table1WHERE partition >= max_partition(partition) - 注:max_partition() 函数为 DataPipeline 自定义函数,使用该函数 DataPipeline 会从源端「partition」分区中,每次定时读取大于等于「partition」的最大分区。(partition 为分区字段)
- SELECT * FROM
- 例子二:以日期分区字段作为读取条件,每次只同步当前日期减一天的分区。
- SELECT * FROM
table1WHERE date = CURDATE(yyyyMMdd, -1, day) - 注:每次只同步 date 分区字段值为昨天的分区。("yyyyMMdd" 为分区字段的格式,day 为天)
- SELECT * FROM
- 例子三:以某一个日期分区作为读取条件,每次只读取大于某一个日期的分区。
- 例子一:以分区字段作为读取条件,同步已有分区中的分区字段的最大值。每次执行批量读取时,系统会过滤出分区字段的最大值,假设分区字段的最大值已经同步过则不会再次同步。
目前的策略:
- 读取数据的方式是直接去HDFS文件系统解析文件。不支持JDBC方式读取(验证性能不可行,差几十倍)
- 默认系统会读取该表所有分区下的数据,支持用户设置「读取分区条件」,如:
- 源端已经按时间字段进行分区,我们会根据分区字段读取文件
- 例:如果想读取表table1的三个分区:date=20190601、date=20190602以及date=20190603,可以使用select * from table1 where date=20190601 and date=20190602 and date=20190603
- 如果没有做分区策略,则读取分区下所有文件。
- 如果在没有分区的情况下,可以通过清洗脚本去过滤掉表的数据。
如:源端没有分区,想要读取id>1的数据
- 如果在没有分区的情况下,可以通过清洗脚本去过滤掉表的数据。
- 源端已经按时间字段进行分区,我们会根据分区字段读取文件

读取策略:
- 用户需要设置「读取条件」可以直接编辑where语句。
- 每次定时会扫所有分区,然后命中读取条件的分区进行数据读取,不命中的不会去读。
- 命中读取条件的分区下,如果有新文件或者新分区会读取写入到目的地。
- 如果老分区的文件更新时间有变化(大于上次读取的时间),系统会重新读取该文件数据,但是目的地会产生重复数据,为避免产生重复数据,可以提前删除掉目的地原有数据。
- 如果文件在写入目的地的过程中,源端数据发生了变化,那么目的地必然会产生一定的重复数据,因此应该尽量避免在同步过程中数据发生变化。