版本:v2.7
SQLServer读取设置
SQL Server数据源读取设置
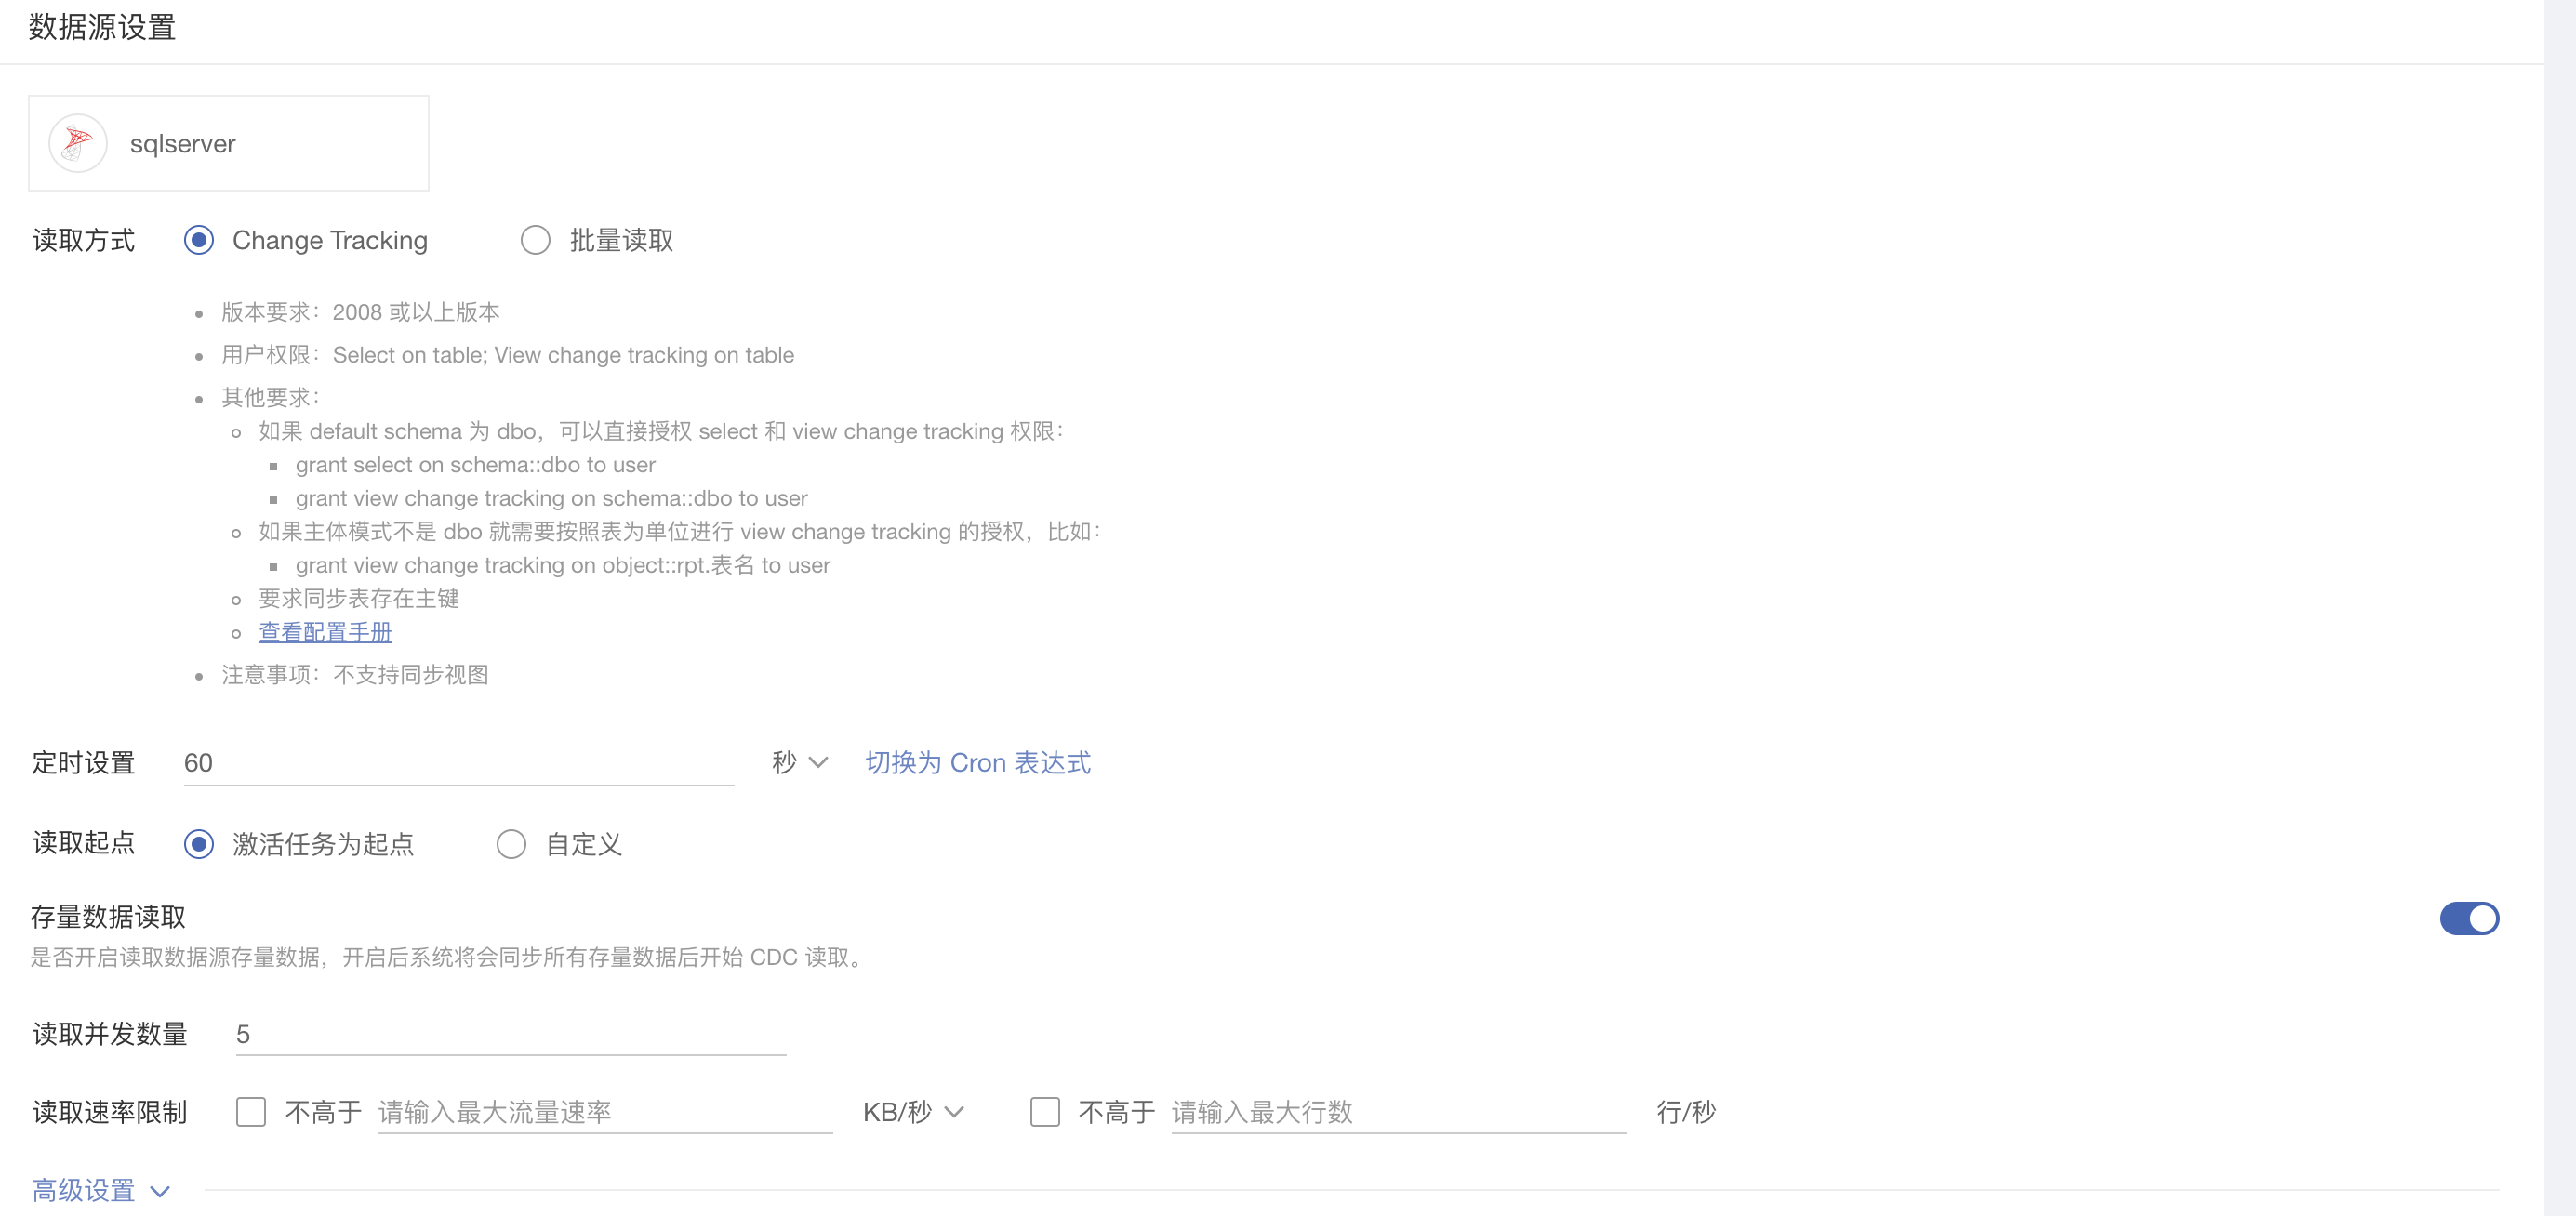
- 读取方式
- 首先要设置读取方式,SQL Server数据源可选择两种读取方式:Change Tracking(实时模式) & 批量读取
- Change Tracking
- 可通过Change Tracking读取SQL Server数据源的实时数据。
- 若发现无法勾选Change Tracking读取模式(或其他数据库实时模式),请查看SQL Server - Change Tracking配置方法 (其他数据库实时模式也可点击查看)
- 读取起点默认为「激活任务为起点」,指任务激活后数据源产生数据会根据Binlog解析视为同步对象。
- 若用户需要从历史Change Tracking位置开始读取,则可以选择「自定义」,并完成输入Change Tracking Version(必填)。
- 若用户在同步Change Tracking实时同步数据前要迁移该数据库存量数据,可开启「存量数据读取」。激活任务后系统将通过SELECT * FROM table_name方式(读取设置步骤可以添加WHERE语句)读取存量数据,完成存量数据同步后再进行Binlog读取模式。
- 批量读取方式下会定时同步数据,需要设置读取频率,两个选项(单选):同步一次,定时读取。
- 批量读取:
- 批量读取模式要求数据源用户名拥有SELECT权限,定期执行SQL语句的方式读取数据。
- 定时读取,要求用户输入读取频率,默认为 60秒,允许使用Cron表达式。
- 同步一次:表示该任务只同步一次数据源数据到目的地即可。(数据源为MySQL、Oracle、SQL Server、Postgre SQL、腾讯云TDSQL 允许只同步一次)
- Change Tracking
- 读取并发数量
- 读取并发数量是指该任务从数据源中并行读取表的数量,默认为5。
- 具体读取并发数量要根据数据源可接受请求量决定。
- 详细策略:并发数量代表着并行读取表的数量,当表读取完毕时系统会释放掉该线程,其他的表可继续抢占该线程进程数据的读取。任务暂停后又重启所有的表会重新抢占线程,系统会按照断点续传的方式继续同步新增数据。
- 读取速率限制
- 当用户设置读取速率限制,系统平均读取速率将不会超过该数值。
- 可按流量或行数作为限制条件。
- 用户能够不选、单选或多选,若同时勾选,两种限制将同时应用。
- 勾选后即可激活对应的速率限制,请输入正整数;
- 数据源高级设置
- 传输队列最大缓存值
- 任务开始读取数据后,单个任务默认缓存10GB数据(读写数据量差),用户可自定义。
- 读写数据量差达到10GB(最大缓存值时),根据先进先出的原则,旧数据将会被回收。
- 当任务数据读写速率失衡,读写数据量差大于10GB(最大缓存值)时,将会出现部分数据被回收,未能成功写入数据目的地的情况。
- 传输队列回收时间
- 任务开始读取数据后,但个任务默认缓存3天数据,用户可自定义。
- 缓存数据达到回收时间,旧数据将会被回收。
- 当任务数据读写速率失衡,超过回收时间的数据尚未被写入到目的地,将会出现部分数据被回收,未能成功写入数据目的地的情况。
- 数据任务动态限速
- 开启后该数据任务读写数据量差达到「最大缓存值」,任务将会暂停数据读取工作。当实际缓存数据量小于「最大缓存值」时会重新开始读取数据。
- 可根据用户情况自定义「检查频率」
- 读取端数据一致性
- 用户「关闭」该选项,DataPipeline 从数据源读取数据后,将会立即写入到目的地。
- 用户「开启」该选项,DataPipeline 从数据源读取数据后,系统定期记录读取的进度,数据对应的进度被成功记录了,才会被允许写入到目的地。以此来保证系统出现重启或者rebalance的情况时,根据系统明确的标记信息来保证目的地数据的一致性。
- 传输队列最大缓存值