版本:v5.13
版本要求
| 节点 | 读取方式 | 版本要求 | 权限要求 |
|---|---|---|---|
| 数据源节点 | JDBC | + 支持版本为:5.2.01、5.2.02、5.2.03、6.1.01、6.1.02、6.1.03 + 支持的部署模式:集中式和分布式部署 其中6.1.02版本支持配置集中式的多DN节点(主备模式)以及数据同步 | --赋值元数据库的查询权限GRANT SELECT ON information_schema.tables,information_schema.collation_character_set_applicability,information_schema.statistics,information_schema.schemata,information_schema.columns TO 'dp_user'@'%'; -- 赋值需要同步的数据库的查询权限GRANT SELECT ON your_database_name.* TO 'dp_user'@'%'; |
| Binlog | + 支持的版本为:6.1.02 + 支持的部署模式:集中式和分布式部署 6.1.02版本支持配置集中式的多DN节点(主备模式)以及数据同步 | --赋值元数据库的查询权限GRANT SELECT ON information_schema.tables,information_schema.collation_character_set_applicability,information_schema.statistics,information_schema.schemata,information_schema.columns TO 'dp_user'@'%'; -- 赋值需要同步的数据库的查询权限GRANT SELECT ON your_database_name. TO 'user_name'@'%'; -- 增量同步数据复制权限; GRANT REPLICATION SLAVE, REPLICATION CLIENT ON .* TO 'user_name'@'%'; | |
| GoldenDB CDC | + 支持的版本为:6.1.02、6.1.03 + 支持的部署模式:集中式和分布式部署 | --赋值元数据库的查询权限GRANT SELECT ON information_schema.tables,information_schema.collation_character_set_applicability,information_schema.statistics,information_schema.schemata,information_schema.columns TO 'dp_user'@'%'; -- 赋值需要同步的数据库的查询权限GRANT SELECT ON your_database_name. TO 'dp_user'@'%'; -- 增量同步数据复制权限; GRANT REPLICATION SLAVE, REPLICATION CLIENT ON .* TO 'user_name'@'%'; | |
| Datapipeline GoldenDB 采集代理 | + 支持的版本为:6.1.02 + 支持的部署模式:集中式和分布式部署 | --用户权限要求:相关视图和表的 SELECT 权限,REPLICATION SLAVE,REPLICATION CLIENT,CREATE OBJECT,INSERT,UPDATE,DELETE,DROP | |
| 目的地节点 | JDBC | + 支持的版本为:6.1.02 + 支持的部署模式:集中式和分布式部署 | + SELECT ANY TABLE + INSERT ANY TABLE + UPDATE ANY TABL + DELETE ANY TABLE + ALTER ANY TABLE + CREATE ANY TABLE + CREATE ANY INDEX + DROP ANY TABLE |
读取方式
说明:
分布式部署模式下,对应delete会读取两遍,binlog中读出即为如此,这是截止到6.1.03版本的一个现象。
- JDBC 读取:
- 当您需要使用 JDBC 模式同步增量数据时,要求需要同步的表拥有增量识别字段。选择的字段必须为可排序,例如数字或时间类型,推荐的字段类型一般为随数据更新而自增的字段,如:更新时间戳(例: UpdatedAt)
- GoldenDB CDC 读取:
- 请提前安装并配置 CDC 节点,详情请参见用户操作指南
- BINLOG_ROW_IMAGE = 'FULL'
- BINLOG 保留时间建议 >=72 小时
- BINLOG 读取:
- GOLDENDB BINLOG MODE = 'ROW'
- BINLOG_ROW_IMAGE = 'FULL'
- BINLOG 保留时间建议 >= 72 小时
- Datapipeline GoldenDB 采集代理读取:
- 请进行 GoldenDB 采集代理部署(部署文档请联系项目经理获取)
- BINLOG_ROW_IMAGE = 'FULL'
- BINLOG 保留时间建议 >=72 小时
| 读取方式 | 场景 | 权限要求 | 对应功能 |
|---|---|---|---|
| JDBC | 批量同步场景,全量初始化 | --赋值元数据库的查询权限GRANT SELECT ON information_schema.tables,information_schema.collation_character_set_applicability,information_schema.statistics,information_schema.schemata,information_schema.columns TO 'dp_user'@'%'; -- 赋值需要同步的数据库的查询权限GRANT SELECT ON your_database_name.* TO 'dp_user'@'%'; | 1、选表以及视图,读取数据 2、任务运行,读取权限 |
| BINLOG | 增量监听场景 | --赋值元数据库的查询权限GRANT SELECT ON information_schema.tables,information_schema.collation_character_set_applicability,information_schema.statistics,information_schema.schemata,information_schema.columns TO 'dp_user'@'%'; -- 赋值需要同步的数据库的查询权限GRANT SELECT ON your_database_name. TO 'user_name'@'%'; -- 增量同步数据复制权限; GRANT REPLICATION SLAVE, REPLICATION CLIENT ON .* TO 'user_name'@'%'; | 1、binlog 增量读取 2、任务运行,读取权限 |
| GoldenDB CDC | 增量监听场景 | --赋值元数据库的查询权限GRANT SELECT ON information_schema.tables,information_schema.collation_character_set_applicability,information_schema.statistics,information_schema.schemata,information_schema.columns TO 'dp_user'@'%'; -- 赋值需要同步的数据库的查询权限GRANT SELECT ON your_database_name. TO 'dp_user'@'%'; -- 增量同步数据复制权限; GRANT REPLICATION SLAVE, REPLICATION CLIENT ON .* TO 'user_name'@'%'; | 1、binlog 增量读取 2、任务运行,读取权限 |
| Datapipeline GoldenDB 采集代理读取 | 增量监听场景 | --用户权限要求:相关视图和表的 SELECT 权限,REPLICATION SLAVE,REPLICATION CLIENT,CREATE OBJECT,INSERT,UPDATE,DELETE,DROP | 1、采集代理增量读取 2、任务运行,读取权限 |
| 写入方式 | 场景 | 权限要求 | 对应功能 |
|---|---|---|---|
| JDBC | 全量、增量数据写入 | + SELECT ANY TABLE + INSERT ANY TABLE + UPDATE ANY TABL + DELETE ANY TABLE + ALTER ANY TABLE + CREATE ANY TABLE + CREATE ANY INDEX + DROP ANY TABLE | 1. 创建表 2. 写入数据 3. 增量 DDL 以及 DML 执行 |
节点特性
数据类型
说明
oracle模式下建表/结构变化针对varchar2类型实际数据库内建出来的是varbinary,为goldendb自身特性
| 序号 | 官网支持类型 | DP定义的类型 | 作为源支持情况 | 作为目的支持情况 |
|---|---|---|---|---|
| 1 | INT | INT(p) INT UNSIGNED(p) | ✔️ | ✔️ |
| 2 | SMALLINT | SMALLINT(p) SMALLINT UNSIGNED(p) | ✔️ | ✔️ |
| 3 | BIGINT | BIGINT(p) BIGINT UNSIGNED(p) | ✔️ | ✔️ |
| 4 | TINYINT | TINYINT(p) TINYINT UNSIGNED(p) | ✔️ | ✔️ |
| 5 | MEDIUMINT | MEDIUMINT(p) MEDIUMINT UNSIGNED(p) | ✔️ | ✔️ |
| 6 | INTEGER | INTEGER(p) INTEGER UNSIGNED(p) | ✔️ | ✔️ |
| 7 | FLOAT(5) | FLOAT(p, s) FLOAT UNSIGNED(p, s) | ✔️ | ✔️ |
| 8 | DOUBLE | DOUBLE(p, s) DOUBLE UNSIGNED(p, s) | ✔️ | ✔️ |
| 9 | DECIMAL(n,s) | DECIMAL(p, s) DECIMAL(p, s) UNSIGNED | ✔️ | ✔️ |
| 10 | NUMERIC(n,s) | NUMERIC(p, s) NUMERIC(p, s) UNSIGNED | ✔️ | ✔️ |
| 11 | NUMBER(n,s) | NUMBER(p, s) NUMBER(p, s) UNSIGNED | ✔️ | ✔️ |
| 12 | DEC(n,s) | DEC(p, s) DEC(p, s) UNSIGNED | ✔️ | ✔️ |
| 13 | DATE | DATE | ✔️ | ✔️ |
| 14 | DATETIME | DATETIME(p) | ✔️ | ✔️ |
| 15 | TIME | TIME(p) | ✔️ | ✔️ |
| 16 | TIMESTAMP | TIMESTAMP(p) | ✔️ | ✔️ |
| 17 | YEAR | YEAR(p) | ✔️ | ✔️ |
| 18 | VARCHAR(10) | VARCHAR(p) | ✔️ | ✔️ |
| 19 | CHAR(10) | CHAR(p) | ✔️ | ✔️ |
| 20 | BLOB | BLOB | ✔️ | ✔️ |
| 21 | LONGBLOB | LONGBLOB | ✔️ | ✔️ |
| 22 | TINYBLOB | TINYBLOB | ✔️ | ✔️ |
| 23 | MEDIUMBLOB | MEDIUMBLOB | ✔️ | ✔️ |
| 24 | CLOB | CLOB | ✔️ | ✔️ |
| 25 | BINARY | BINARY(p) | ✔️ | ✔️ |
| 26 | VARBINARY | VARBINARY(p) | ✔️ | ✔️ |
| 27 | LONGTEXT | LONGTEXT | ✔️ | ✔️ |
| 28 | TINYTEXT | TINYTEXT | ✔️ | ✔️ |
| 29 | MEDIUMTEXT | MEDIUMTEXT | ✔️ | ✔️ |
| 30 | ENUM | ENUM | ✔️ | ✔️ |
| 31 | TEXT | TEXT | ✔️ | ✔️ |
| 32 | SET | SET | ✔️ | ✔️ |
| 33 | VARCHAR2 | VARCHAR2 VARCHAR2(size CHAR) | ✔️ | ✔️ |
| 34 | JSON | JSON | ✔️ | ✔️ |
表
源
支持读取普通表、分区表、复制表
不支持多级分区表
不支持分库建库
不支持多级分片表
各类表不支持分区结构变化,不支持压缩属性、列加密属性
视图
源
不支持读取普通视图
索引
当前支持查看索引
| 索引类型 | 索引存储方式 | 排序 |
|---|---|---|
| 普通索引 | Btree | 支持配置 |
| 唯一索引 | Btree | 支持配置 |
| 主键索引 | Btree | 不支持配置,默认为升序 |
字符集
- 字符集支持:latin1、gbk、utf8、utf8mb4和gb18030。
- 字符序支持按照二进制值进行,即对应上述四种字符集的字符序分别为latin1_bin、gbk_bin、utf8_bin、utf8mb4_bin和gb18030_bin。
DML
读取
| 读取模式 | DML识别 | 捕获信息 | 限制 |
|---|---|---|---|
| JDBC | INSERT | 源端读取支持的所有字段类型 | 【限制】不支持列筛选 |
| BINLOG | INSERT | 源端读取支持的所有字段类型 | 【限制】不支持列筛选 |
| UPDATE | before:主键 after:支持的所有字段 | ||
| DELETE | before:主键 after:null | ||
| GoldenDB CDC | INSERT | 源端读取支持的所有字段类型 | 【限制】不支持列筛选 |
| UPDATE | before:主键 after:支持的所有字段 | ||
| DELETE | before:主键 after:null |
DDL
读取
- 对于JDBC的方式,实际上DDL是靠结构比对捕获的,因此,需要增量数据触发diff。
- 对于BINLOG的解析方式,可以在日志中获取到对应的DDL,并且支持连续DDL的处理。
- 处理过程中包含大量协调,因此不支持同时进行多个DDL操作,需要等一个DDL操作处理完毕后,再进行下一次操作
- 由于未接入DDL改造后逻辑,因此异常操作均不支持(仅支持增量过程中,增量暂停后再重启识别暂停过程内的结构变化)
- 不论是否包含并发分区,不支持在全量读写未完成时进行结构变化操作
- 不支持分区结构变化
| DDL类型 | 读取方式 | 是否支持获取 | 上游触发场景 | 支持处理的内容 |
|---|---|---|---|---|
| add column | JDBC | ✔️ | 1. 源端加列 2. 源端rename列–rename后的列识别为新增列 【限制】不支持移位DDL,即不支持after,first等 | 名称、类型、精度、标度、默认值、注释、not null |
| BINLOG/GoldenDB CDC | ✔️ | 【限制】不支持移位DDL,即当加列的DDL中有after,first等关键字后,该关键字会被过滤掉。 | 名称、类型、精度、标度、默认值、注释、not null | |
| drop column | JDBC | ✔️ | 1. 源端加列 2. 源端rename列–rename后的列识别为新增列 | |
| BINLOG/GoldenDB CDC | ✔️ | |||
| modify column | JDBC | ✔️ | 源端修改类型,精度,标度 | 类型、精度、标度、默认值、注释、not null |
| BINLOG/GoldenDB CDC | ✔️ | 源端修改类型,精度,标度 | 类型、精度、标度、默认值、注释、not null | |
| rename column | JDBC | ❌ | 【限制】不支持,会识别为删除列+新增列(风险❗️) | |
| BINLOG/GoldenDB CDC | ✔️ | |||
| drop table | JDBC | ✔️ | 源表被删除或者源表被rename 【说明】当JDBC读取的时候,会检测到待同步的表不存在。 | |
| BINLOG/GoldenDB CDC | ✔️ | |||
| truncate table | JDBC | ❌ | 不支持 | |
| BINLOG/GoldenDB CDC | ✔️ | |||
| create table | JDBC | ❌ | 当前不支持 | |
| BINLOG/GoldenDB CDC | ✔️ | **** | ||
| rename table | JDBC | ❌ | 不支持,会被识别为drop table | |
| BINLOG/GoldenDB CDC | ✔️ | 能识别,任务会暂停 |
添加GoldenDB 数据节点操作步骤
新建弹窗界面选择了 GoldenDB 节点类型之后,显示 GoldenDB 的基本信息配置模板:
- 版本:GoldenDB 5.2.01、GoldenDB 5.2.02、GoldenDB 5.2.03、GoldenDB 6.1.01、GoldenDB 6.1.02、GoldenDB 6.1.03。
- 部署模式:选择集群为分布式部署,或集中部署
- 服务器地址:输入计算节点地址 IP以及端口
- 数据库:
- 用户权限的所有库
- 输入指定数据库名称
- 用户名/密码:输入可访问该数据节点的用户名和密码
信息
GoldenDB 6.1.02版本
- CN节点地址:输入CN节点的 IP 地址以及端口。
- DN节点地址:如果需要实时日志解析,需要填写DN 节点的地址。
- 集中式:输入DN节点实例地址以及对应端口号。(此功能仅支持 V6.1.02 版本的 JDBC 和Binlog读取)
- 多DN配置:点击右侧按钮可添加多个DN节点
- 删除DN配置:当前节点配置中超过 一个DN节点时,则显示删除按钮
- 分片DN节点配置:该配置用于部署方式为分布式时,用户可以添加多个分片以及每根分片下的多个DN节点(配置方式如集中式)
- 集中式:输入DN节点实例地址以及对应端口号。(此功能仅支持 V6.1.02 版本的 JDBC 和Binlog读取)
- GoldenDB 6.1.02、GoldenDB 6.1.03节点支持使用GoldenDB CDC模式采集增量数据,当您输入此版本后,请在「CDC配置」中输入CDC连接信息。
- 服务器地址:输入CDC节点的域名或 IP 地址。
- 端口号:输入连接CDC节点的端口值。
- 用户名/密码:输入可访问该CDC节点的用户名和密码
GoldenDB 数据节点采集代理信息配置
在 创建节点 模块选择数据节点类型「GoldenDB」,节点版本 6.1.02 即可进行采集代理信息配置;或者在已创建好的 GoldenDB 节点中,点击「编辑」按钮即可进行 采集代理的配置。主要的配置步骤:
- 创建节点,选择数据节点类型「GoldenDB」,节点版本 6.1.02/进入 「GoldenDB」节点详情 - 基本配置,点击「编辑」按钮进行采集代理配置
- 进行采集代理信息配置:
- 采集代理名称:用户自定义当前采集代理连接名称
- 服务器地址:采集代理服务器地址
- 端口号:采集代理服务器端口
- 数据库地址:通过下拉框选择已配置的数据库连接地址,为采集代理连接并读取的数据库连接
- 添加多个采集代理配置:点击「添加连接配置」按钮,可进行多个采集代理的相关信息配置
警告
GoldenDB 采集代理使用注意事项
- 一台机器部署多个采集代理 但是要自行隔离,不能多个采集代理的数据目录一样
- 不允许手工修改白名单和采集代理内的位点数据
- 采集代理切换过程中会出现短暂的「采集代理异常状态」属于正常情况,websevice会定期获取采集代理的状态,旧master下线,新master还没上线是,那么当前系统获取不到状态。待新master上线,下一轮 getAgentStatus的请求请求过来时,会更新为「running」
- 当配置采集代理高可用时(采集代理1&采集代理2)当采集代理1不可用,会自动切换到采集代理2上,原有任务不受影响,但是新建任务会激活失败(激活时会校验两个采集代理的连通性),此时点击节点可用性校验,采集代理为失败状态
- 节点采集代理高可用只能在节点新建后跑任务前一次选好多个采集代理,不能由已跑过任务的单采集代理节点增加补充变成采集代理高可用
- 采集代理升级需要暂停采集代理 升级完成后再激活采集代理节点采集代理高可用(采集代理1,采集代理2,当前使用采集代理1采集)的情况下,不支持 暂停采集后,docker stop当前使用的采集代理1,然后给增量,然后开启采集,此时给的增量会丢失。必须要读到本地checkpoint,默认停止采集→激活采集的过程中采集代理节点必须处于running状态
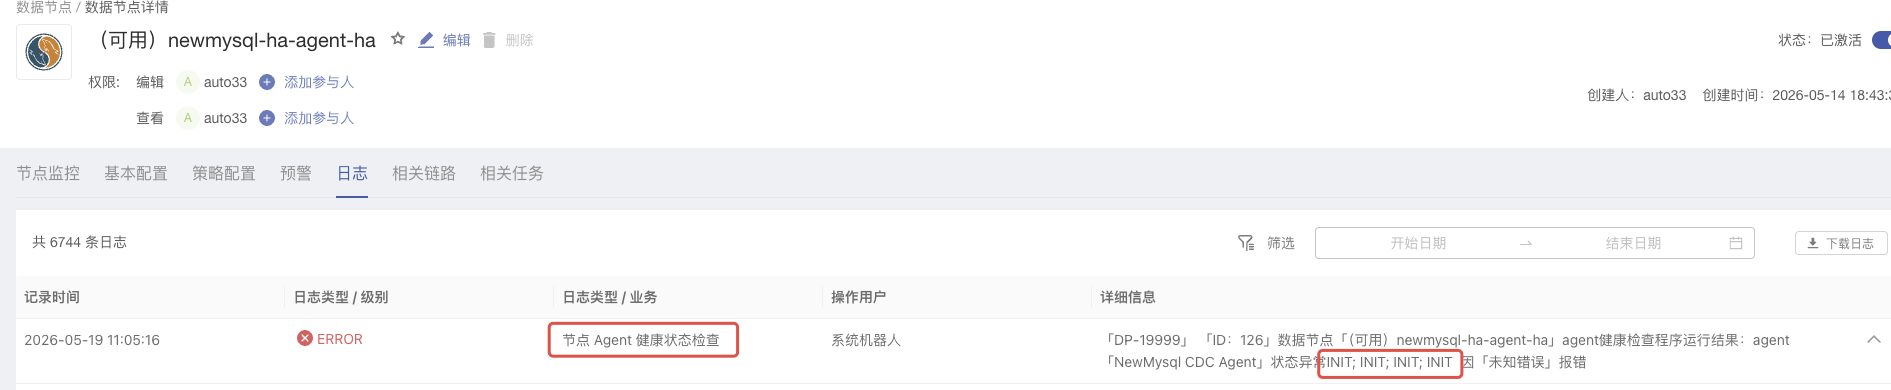
- 节点健康检查仅任务running状态为正常状态,当采集代理为init状态(采集代理激活但白名单为空时)仍然会有对应日志
- GoldenDB 6102(分布式)采集代理必须部署在DataPipeline机器上,不能部署在其他机器
- GoldenDB 高可用情况删节点无法切除所有采集代理和原节点的联系,需要手动初始化
- DDL 和 DML 混合的情况下,GoldenDB 的 采集代理读取 因为是半解析半刷表的实现方式所以会有未知问题 ,例如一次性执行相关 DDL+DML -- sql文件。如:https://doc.datapipeline.com/download/attachments/211388512/mixsql?version=1\&modificationDate=1778580053432\&api=v2
- 采集代理高可用切换过程中建议不执行 DDL,容易协调导致进程卡死
- DDL 协调过程中如果有其他行为干扰会导致 DDL 协调卡死:当大量新表被添加到白名单,每次添加都会触发协调拓扑更新,这些并发操作可能导致协调锁竞争或资源争用
注意事项
警告
- GoldenDB CDC采集模式下,不支持采集以下内容:
- 不支持MYISAM表的DDL;
- 不支持非ROW格式的BINLOG;
- 不支持串行化DDL。
- GoldenDB BinLog 采集模式下,不支持采集以下内容:
- 不支持串行化DDL。
- 当 GoldenDB 作为数据同步源节点,且 GoldenDB 的部署方式为分布式时,需要注意「无主键表的问题」:
- 问题:当源表不存在主键时,GoldenDB 分布式会自动添加隐藏列作为主键列,此时表中肯定存在唯一索引(分布式节点特性),因此在不做任何处理的情况下,直接进行新建目的地表的表和字段映射后, 执行创建表操作会导致DataPipeline 目的地表创建失败。
- 原因:DataPipeline 会识别到源表中的隐藏主键列并由此生成建表语句,而在字段映射中不存在该隐藏列,因此会出现建表失败的问题。
- 解决方式:用户可以通过 「语义映射设置」功能,在「索引映射」中设置 唯一索引 映射为 「主键」,当字段映射中存在主键字段的映射配置后,DataPipeline 则不会将源表的隐藏主键列写入建表语句中
- 多DN节点 DDL 协调说明:DDL 协调过程中如果所用DN心跳异常,不会立即选举,会等到协调超时后重新选举,协调超时默认15min。如果正好卡在表结构刷新时节点心跳异常,则会立即任务报错停止,重启任务后重新协调