版本说明
| 节点 | 读取模式 | 版本要求 |
|---|---|---|
| 数据源节点 | JDBC | MySQL官方版 5.5、5.6、5.7、8.0; |
| Binlog | MySQL 官方版 5.5、5.6、5.7、8.0; | |
| 采集代理 | MySQL 官方版 5.7、8.x(仅支持在DataPipeline中选择「My SQL(新)」节点类型) | |
| 目的地节点 | JDBC | MySQL 官方版 5.5、5.6、5.7、8.0 |
读取方式
数据库要求:
- 开启binlog: SHOW VARIABLES LIKE 'log_bin' ; 输出为 ON
- binlog模式为row模式:SHOW GLOBAL VARIABLES LIKE 'binlog_format' ; 输出为 ROW
- binlog为补全模式:show variables like 'binlog_row_image'; 确认修改binlog_row_image为FULL
- 5.7以上版本建议开启:SHOW VARIABLES LIKE 'gtid_mode';
- BINLOG 保留时间建议 >= 72 小时;
- 支持只读从库,只读从库需开启 REPLICATION CLIENT 和 REPLICATION SLAVE 权限
- 要求需要同步的表拥有增量识别字段,用于同步增量数据。选择的字段必须为可排序,例如数字或时间类型,推荐的字段类型一般为随数据更新而自增的字段,如:更新序列号(例:SequenceID,更新时间戳(例:UpdatedAt)
| 读取方式 | 场景 | 权限要求 | 对应功能 |
|---|---|---|---|
| JDBC | 批量同步场景,全量初始化 | --赋值元数据库的查询权限GRANT SELECT ON information_schema. TO 'user'@'%'; -- 赋值需要同步的数据库的查询权限GRANT SELECT ON your_database_name. TO 'user_name'@'%'; | 1、选表以及视图,读取数据 2、任务运行,读取权限 |
| binlog | 增量监听场景 | --赋值元数据库的查询权限GRANT SELECT ON information_schema. TO 'user'@'%'; -- 赋值需要同步的数据库的查询权限GRANT SELECT ON your_database_name. TO 'user_name'@'%'; -- 增量同步数据复制权限; GRANT REPLICATION SLAVE, REPLICATION CLIENT ON . TO 'user_name'@'%'; | 1、binlog 增量读取 2、任务运行,读取权限 |
| 采集代理读取 | 增量监听场景 | --赋值元数据库的查询权限GRANT SELECT ON information_schema. TO 'user'@'%'; -- 赋值需要同步的数据库的查询权限GRANT SELECT ON your_database_name. TO 'user_name'@'%'; -- 增量同步数据复制权限; GRANT REPLICATION SLAVE, REPLICATION CLIENT ON . TO 'user_name'@'%'; | 1、采集代理Agent 实时增量数据读取 2、任务运行,读取权限 |
写入方式
| 写入方式 | 场景 | 权限要求 | 对应功能说明 |
|---|---|---|---|
| JDBC | 写入 | -- 授予SELECT、INSERT、UPDATE、DELETE权限 GRANT SELECT, INSERT, UPDATE, DELETE ON your_database_name. TO 'user_name'@'%'; -- 授予DROP、INDEX、ALTER、CREATE权限(这些权限通常需要在数据库级别授予) GRANT DROP, INDEX, ALTER, CREATE ON your_database_name. TO 'user_name'@'%'; | 1、创建表 2、任务运行,读取写入权限 3、选表,写入数据 4、清空目的地表 5、删除重建表,结构变化 |
节点特性
数据类型
| 序号 | 官网支持类型 | DP定义的类型 | 作为源支持情况 | 作为目的地支持情况 |
|---|---|---|---|---|
| 1 | TINYINT BOOL,BOOLEAN = tinyint(1) | TINYINT(p) TINYINT UNSIGNED(p) BOOLEAN | ✔️ | ✔️ |
| 2 | SMALLINT | SMALLINT(p) SMALLINT UNSIGNED(p) | ✔️ | ✔️ |
| 3 | MEDIUMINT | MEDIUMINT(p) MEDIUMINT UNSIGNED(p) | ✔️ | ✔️ |
| 4 | INT | INT(p) INT UNSIGNED(p) | ✔️ | ✔️ |
| 5 | BIGINT | BIGINT(p) BIGINT UNSIGNED(p) | ✔️ | ✔️ |
| 6 | numeric [ (_p_, _s_) ]decimal [ ( _p_, _s_) ] | DECIMAL(p, s) DECIMAL(p, s) UNSIGNED | ✔️ | ✔️ |
| 7 | FLOAT(p) (0\<p<=23) | FLOAT(p, s) FLOAT UNSIGNED(p, s) | ✔️ | ✔️ |
| 8 | DOUBLE(p) (24\<p<=53) | DOUBLE(p, s) DOUBLE UNSIGNED(p, s) | ✔️ | ✔️ |
| 9 | BIT | BIT(p) | ✔️ | ✔️ |
| 10 | DATE | DATE | ✔️ | ✔️ |
| 11 | DATETIME | DATETIME(p) | ✔️ | ✔️ |
| 12 | TIMESTAMP | TIMESTAMP(p) | ✔️ | ✔️ |
| 13 | TIME | TIME(p) | ✔️ | ✔️ |
| 14 | YEAR | YEAR(p) | ✔️ | ✔️ |
| 15 | CHAR | CHAR(p) | ✔️ | ✔️ |
| 16 | VARCHAR | VARCHAR(p) | ✔️ | ✔️ |
| 17 | BINARY | BINARY(p) | ✔️ | ✔️ |
| 18 | VARBINARY | VARBINARY(p) | ✔️ | ✔️ |
| 19 | BLOB | BLOB | ✔️ | ✔️ |
| 20 | TEXT | TEXT | ✔️ | ✔️ |
| 21 | ENUM | ENUM | ✔️ | ✔️ |
| 22 | SET | SET | ✔️ | ✔️ |
| 23 | JSON | JSON | ✔️ | ✔️ |
| 24 | POINT | POINT | ✔️ | ❌ |
| 25 | LINESTRING | LINESTRING | ✔️ | ❌ |
| 26 | POLYGON | POLYGON | ✔️ | ❌ |
| 27 | MULTIPOINT | MULTIPOINT | ✔️ | ❌ |
| 28 | MULTILINESTRING | MULTILINESTRING | ✔️ | ❌ |
| 29 | MULTIPOLYGON | MULTIPOLYGON | ✔️ | ❌ |
| 30 | GEOMETRYCOLLECTION | GEOMETRYCOLLECTION | ✔️ | ❌ |
注意
- MySQL 的实时处理模式下,暂时无法读取字段类型为 geometry 的数据,如果存在对应类型的数据,请选择定时模式进行同步。
- point
- linestring
- polygon
- multipoint
- multilinestring
- multipolygon
- geometrycollection
- 目前 MySQL 数据节点编码类型支持UTF8MB3,GB18030,GB232,GBK,UTF8,UTF6,UTF6LE,UTF32,UTF8MB4,ARMSCII8,BINARY,同时支持在表和字段上分别进行设置。
- 注意未声明的字段类型不支持。
DML
读取
| 读取模式 | DML识别 | 捕获信息 | 限制 |
|---|---|---|---|
| JDBC | INSERT | 源端读取支持的所有字段类型 | 【限制】不支持列筛选 |
| binlog | INSERT | 源端读取支持的所有字段类型 | 【限制】不支持列筛选 |
| UPDATE | before:主键 after:支持的所有字段 | ||
| DELETE | before:主键 after:null |
写入
| 写入策略 | 写入SQL语法 | 限制 |
|---|---|---|
| INSERT | INSERT INTO 。。。 VALUES 。。。 | |
| UPDATE | UPDATE。。。 SET。。。 WHERE 。。。 | 需要在目的地指定逻辑主键,如果未指定逻辑主键,会使用映射上配置的主键作为逻辑主键。 【限制】当源端采集不完整,目的主键列 源端采集不到,会存在最终数据不一致情况,因为拿null去更新数据(不是因为真实值为null,是因为采集不完整) 当更新条件中存在值为null时,会做特殊处理。 更新条件的字段为空:update 表名 set 字段 value where 更新条件 is null; 更新条件的字段为空:update 表名 set 字段 value where 更新条件 in value; |
| DELETE | 需要在目的地指定逻辑主键,如果未指定逻辑主键,会使用映射上配置的主键作为逻辑主键。 原因同上: 当更新条件中存在值为null时,会做特殊处理。 1. 更新条件的字段为空:delete from 表名 where 更新条件 is null; 2. 更新条件的字段不为空:delete from 表名 where 更新条件的字段 in (value); | |
| MERGE | 1. 逻辑主键变更: Delete+Insert 2. 非逻辑主键变更: replace into 表名 value(字段名) values(字段值);{} | 需要在目的地指定逻辑主键,如果未指定逻辑主键,会使用映射上配置的主键作为逻辑主键。 |
| IGNORE |
DDL
读取
| 对比 | JDBC | Binlog解析 |
|---|---|---|
| DDL发现原理 | 靠不同数据之间的结构比对。 注意第一条数据是和页面的配置进行比对。 | 靠日志解析DDL事件,并且支持连续DDL处理 |
| 支持的范围 | 通过比对,可以发现加列,删列,以及字段属性变化,仅包括字段类型,精度,标度变化 | 加列,删列,重命名列以及字段其他属性变化,包括字段类型,字段精度,字段标度,字符集(charset),字段值是否允许为null,默认值,字段注释(comment) |
| 移位DDL,first,after等 | 仅能知道加列,不会对比位置 | 由于下游可能是异构数据库,因此会将first和after进行过滤 |
| DDL类型 | 读取方式 | 是否支持获取 | 上游触发场景 | 支持处理的内容 | 注意内容 |
|---|---|---|---|---|---|
| add column | JDBC | ✔️ | 1. 源端加列 2. 源端rename列–rename后的列识别为新增列 【限制】不支持移位DDL,即不支持after,first等 | 名称、类型、精度、标度 | 1)名称的开始和结束有多个边界符则会统一去掉,并且必须对称<br/>比如alter table A add column ```col_1``` varchar(128) defualt '默认值';可以解析<br/>比如alter table A add column ```col_1 varchar(128) defualt '默认值';由于```col_1`左右的边界符不对称,可能无法解析成功;2)名字不建议有汉字,否则可能解析异常; 3)名字不建议有特殊字符,包含但不限于@,#,¥,$,%,^, …,*,( , ),~, ·,?, /, <, 《,》,>, [ , { , } , ] , 、,, |
| binlog | ✔️ | 【限制】不支持移位DDL,即当加列的DDL中有after,first等关键字后,执行的时候,仅会将增加的字段,根据策略执行。 | 名称、类型、精度、标度、默认值、注释、not null | ||
| drop column | JDBC | ✔️ | 1. 源端加列 2. 源端rename列–rename前的列diff后识别为删除列 | ||
| binlog | ✔️ | 日志解析 | |||
| modify column | JDBC | ✔️ | 源端修改类型,精度,标度 | 类型、精度、标度 | 同add column 注意事项 |
| binlog | ✔️ | 源端修改类型,精度,标度 | 类型、精度、标度、默认值、注释、not null | ||
| change column | JDBC | ✔️ | 如果列名被修改。 【限制】不支持,会识别为删除列+新增列(风险❗️) 会按照加列和删列的ddl策略处理。如果结构变化策略不同,比如一个暂停,一个执行,先后顺序并不保障。但是会保障最终一致性,即最终两个策略都会被应用。 | 类型、精度、标度 | (风险❗️),新增列的类型,精度,标度都可以识别,但是如果有历史数据切记谨慎操作,否则将丢数据; |
| ✔️ | 如果列名未修改 等同于modify column | ||||
| binlog | ✔️ | 如果列名被修改。 识别为change column,将按照rename 的ddl执行 如果列名未修改 等同于modify column | 类型、精度、标度、默认值、注释、not null | ||
| rename column (MySQL 8.0以后支持语法) | JDBC | ❌ | 【限制】不支持,会识别为删除列+新增列(风险❗️) | (风险❗️),新增列的类型,精度,标度都可以识别,但是如果有历史数据切记谨慎操作,否则将丢数据; | |
| binlog | ✔️ | 日志解析 | |||
| drop table | JDBC | ✔️ | 源表被删除或者源表被rename 【说明】当JDBC读取的时候,会检测到待同步的表不存在。 | ||
| binlog | ✔️ | ||||
| truncate table | JDBC | ❌ | 不支持 | ||
| binlog | ✔️ | ||||
| create table | JDBC | ❌ | 当前不支持 | ||
| binlog | ✔️ | ||||
| rename table | JDBC | ❌ | 不支持,会被识别为drop table | ||
| binlog | ✔️ | 能识别,任务会暂停 |
注意
如果任务进入到增加阶段(binlog),此时将任务暂停,然后对任务进行了一系列的结构变化,并且在链路的映射里更新并且应用了这些变化,此时在激活任务的时候,建议使用全量初始化,不要直接使用暂停时进度。因为使用暂停时进度,根据进度点会推进对应的结构变化,但是实际上这些结构变化有可能在映射上的源表上已经被应用过了。这样如果结构无法兼容,可能会造成数据结构错误。
另外该部分内容仅对新MySQL生效。
写入
| DDL类型 | 是否支持 | 限制 |
|---|---|---|
| truncate table | ✔️ | |
| drop table | ✔️ | |
| create table | ✔️ | 在目标转转化为建表语句 1)表名要求相同列名要求相同; 2)每个列会识别 列名,列类型,精度,标度,是否允许为null,字符集,注释 3)可以识别表的字符集,注释 |
| rename table | ❌ | |
| add column | ✔️ | 【限制】不支持移位DDL,即不支持after,first等 |
| drop column | ✔️ | |
| modify column | ✔️ | 【限制】1、其他未支持的属性,结构变化后映射可能会有diff |
| rename column | ✔️ | 【限制】其他未支持的属性,结构变化后映射可能会有diff |
索引
MySQL 当前支持在创建目的表时,可以创建索引,目前支持的索引类型及配置
| 索引类型 | 索引存储方式 | 排序 |
|---|---|---|
| 普通索引 | Btree | 支持配置 |
| 唯一索引 | Btree | 支持配置 |
| 主键索引 | Btree | 不支持配置,默认为升序 |
字符集
由于MySQL对于字符集的支持非常灵活,支持库级别,表级别和字段级别的设置。当前节点支持的字符集类型如下:
GB18030,GB2312,GBK,UTF8,UTF16,UTF16LE,UTF32,UTF8MB4,ARMSCII8,BINARY,UTF8MB3
作为源时,会从元数据中直接读取,如果是不支持的,会识别为Unknown。有可能部分字段会处理为乱码。
作为目的地时,如果是选择已有表时,机制同源,可以从元数据中直接读取。如果是新建表,则仅能使用当前产品支持的字符集类型。
注意:
utf8mb3等同于MySQL中的utf8,但它们都不是完整的UTF-8实现如果需要完全支持UTF-8标准,应该使用utf8mb4在MySQL新版本中,推荐使用utf8mb4而非utf8或utf8mb3。如果使用utf8mb3,下游会默认计算为utf8会在字段环节识别为diff,此时可以手动选择应用diff或者无视;
和字符集相关的比较规则(COLLATE)目前暂不识别和处理;
注意:如果未设置,则使用Default,如果字段未设置,则继承表的字符集,如果表未设置,则继承数据库的。
添加 MySQL节点操作步骤
MySQL 数据节点连接信息配置
新建弹窗界面选择了 MySQL 节点类型之后,显示 MySQL 的基本信息配置模板:
- 版本:选择版本
- 连接地址名称
- 数据库服务器地址可以填写多个服务器的连接地址,作为一个“单机数据库”或“集群数据库”的连接地址
- 可以点击添加数据库服务器地址
- 可以点击删除
- 删除节点连接地址组的前置条件是没有数据任务在引用这个连接地址组;
- 当有任务引用时,不可删除,Hover删除按钮提示:“有数据任务引用,请切换连接地址后重试”
- 可以选择统一认证或不同连接地址分别认证,认证配置内容无变化
- 统一认证方式提示:打开统一认证方式,则认定使用「连接配置-1」的认证方式,\ 即在下方认证信息中代入「连接配置-1」的认证信息。
- 打开统一认证方式后,该连接地址的认证不允许修改
- 统一认证默认关闭
- 认证方式:
- 口令认证:填写数据库用户名密码
- SSL 认证
- 签发机构为“认证中心”时,需输入用户名密码
- 签发机构为“自签发”
- 证书类型为“CA 证书”时,需上传 CA 证书,填写数据库用户名密码
- 证书类型为“ CA-jks 证书”时,需上传 CA-jks 证书,填写证书密钥、数据库用户名密码
- 可以在数据节点详情页面修改连接优先级
同时该节点支持连接切换,即允许用户填写主备节点的连接地址。从而可以当节点发生故障后,可以切换到新的节点上,通过GTID继续读取,保障业务的连续性。
注意事项:
对于MySQL而言,当前DP支持5.5,5.6,5.7,8.0 四个版本,其中MySQL从5.6版本开始支持GTID的设置。在任务的起点设置中,支持通过设置Binlog Position 和 GTID两种方式指定起点。
对于5.5版本而言,仅能通过设置Binlog Position的方式指定起点。对于其他版本,两种方式二选一即可。如果都填写,会优先使用GTID作为起点恢复任务。当然如果需要使用GTID,需要首先开启GTID。
jdbc模式下同步视图时,如果视图比较复杂时由于mysql本身的问题会出现select xxx from 库名.视图名; 这种语句无法识别对应的库名从而报错No database selected,此时需要在页面的节点处配置,将"数据库"选项配置为对应的数据库;
增量阶段同步过程中严禁执行如下刷新清空日志文件的操作,否则将可能无法找到日志文件,同步将无法继续进行。如果误操作,只能重置位点用最新的位点同步(丢失的数据需自行补偿),或者选择完全重新同步;
 禁止执行

 FLUSH LOGS;

 FLUSH ERROR LOGS;

 FLUSH GENERAL LOGS;

 FLUSH SLOW LOGS;

 FLUSH RELAY LOGS;

 ALTER INSTANCE ROTATE BINLOG;

 ALTER INSTANCE ROTATE INNODB REDO LOGS;

 mysqladmin flush-logs等;
mysql5.6及之后的版本建议开启gtid同步;
高可用版本或者使用了主从切换的节点建议开启gtid同步,以防binlog,position在主从节点对应不上而导致无法同步;
MySQL 数据节点采集代理信息配置
在 创建节点 模块选择数据节点类型「MySQL(新)」,节点版本 5.7 或者 8.0 即可进行采集代理信息配置;或者在已创建好的 newmysql节点中,点击「编辑」按钮即可进行 采集代理的配置。主要的配置步骤:
- 创建节点,选择版本 5.7 或者 8.0 版本即可进行采集代理配置/进入 MySQL(新)节点详情 - 基本配置,点击「编辑」按钮进行采集代理配置
- 进行采集代理信息配置:
- 采集代理名称:用户自定义当前采集代理连接名称
- 服务器地址:采集代理服务器地址
- 端口号:采集代理服务器端口
- 数据库地址:通过下拉框选择已配置的数据库连接地址,为采集代理连接并读取的数据库连接
- 添加多个采集代理配置:点击「添加连接配置」按钮,可进行多个采集代理的相关信息配置
MySQL 采集代理使用注意事项
- 一台机器部署多个采集代理 但是要自行隔离,不能多个采集代理的数据目录一样
- 不允许手工修改白名单和采集代理内的位点数据
- 采集代理切换过程中会出现短暂的「采集代理异常状态」属于正常情况,websevice会定期获取采集代理的状态,旧master下线,新master还没上线是,那么当前系统获取不到状态。待新master上线,下一轮 getAgentStatus的请求请求过来时,会更新为「running」
- 当配置采集代理高可用时(采集代理1&采集代理2)当采集代理1不可用,会自动切换到采集代理2上,原有任务不受影响,但是新建任务会激活失败(激活时会校验两个采集代理的连通性),此时点击节点可用性校验,采集代理为失败状态
- 节点采集代理高可用只能在节点新建后跑任务前一次选好多个采集代理,不能由已跑过任务的单采集代理节点增加补充变成采集代理高可用
- 采集代理升级需要暂停采集代理 升级完成后再激活采集代理节点采集代理高可用(采集代理1,采集代理2,当前使用采集代理1采集)的情况下,不支持 暂停采集后,docker stop当前使用的采集代理1,然后给增量,然后开启采集,此时给的增量会丢失。必须要读到本地checkpoint,默认停止采集→激活采集的过程中采集代理节点必须处于running状态
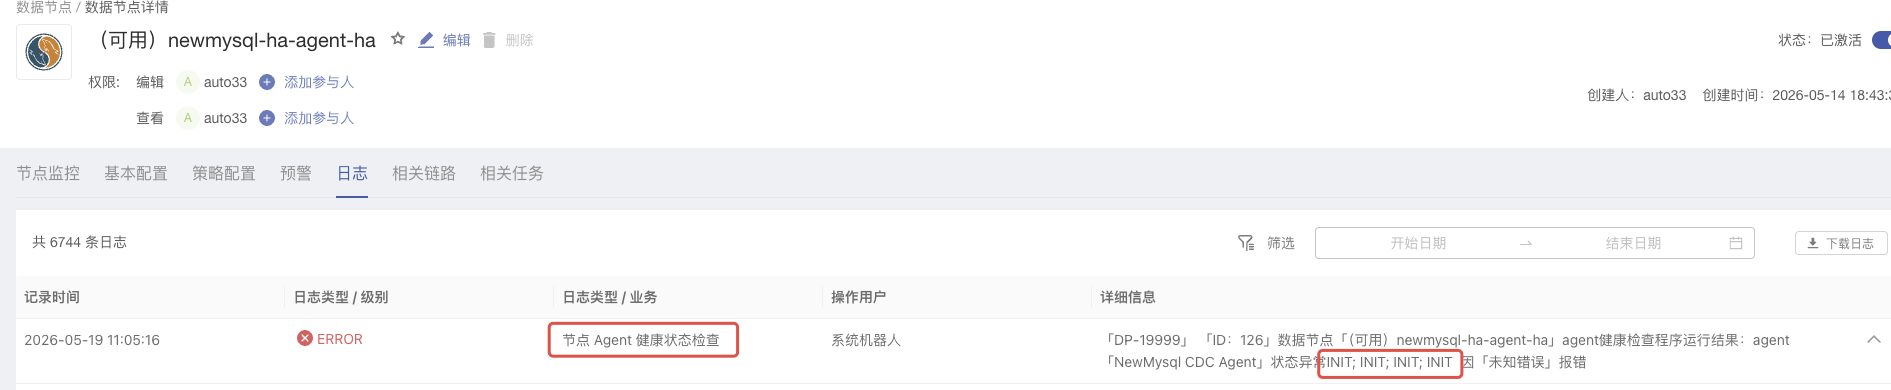
- 节点健康检查仅任务running状态为正常状态,当采集代理为init状态(采集代理激活但白名单为空时)仍然会有对应日志
- MySQL(新)-采集代理:如果主从的gtid结构不一致,当切换到slave节点处然后使用暂停指定位点启动后再切换到master,无法继续进行增量读取
MySQL性能调优
binlog增量读取性能调优
针对MySQL - binlog 增量数据读取性能调优,我们给出对宿主机配置调整示例:
设置为32MB
sudo sysctl -w net.core.rmem_max=33554432
sudo sysctl -w net.core.wmem_max=33554432
sudo sysctl -w net.core.rmem_default=33554432
sudo sysctl -w net.core.wmem_default=33554432
# 查看当前设置
sysctl net.core.rmem_max
sysctl net.core.wmem_max
sysctl net.core.rmem_default
sysctl net.core.wmem_default
# 永久生效
echo "net.core.rmem_max=33554432" | sudo tee -a /etc/sysctl.conf
echo "net.core.wmem_max=33554432" | sudo tee -a /etc/sysctl.conf
echo "net.core.rmem_default=33554432" | sudo tee -a /etc/sysctl.conf
echo "net.core.wmem_default=33554432" | sudo tee -a /etc/sysctl.conf
sudo sysctl -p
增量阶段采用binlog读取增量数据时底层采用的Socket通道与服务器进行数据交互,此Socke通道的Buffer值采用的宿主机默认的值一般只有几十K,建议根据宿主机配置参考执行上述指令,将其调大道16M的倍数,有助于提升增量同步性能。
MySQL 位点重构相关说明
旧 MySQL DBZ 逻辑问题
从5.6版本开始,我们对整个位点架构进行了重构,同时解决了很多之前位点逻辑混乱导致的遗留问题(详细内容可查看更新日志)。但同时发现 旧MySQL 节点 DBZ 相关逻辑(即mysql节点链路不包含并发分区设置)导致的问题,现对该问题进行说明:
分映射起点二次设置会有一些问题,若有相关操作建议使用new_mysql节点。例如:
- MySQL 节点DBZ --内存模式以分映射起点激活,配置为
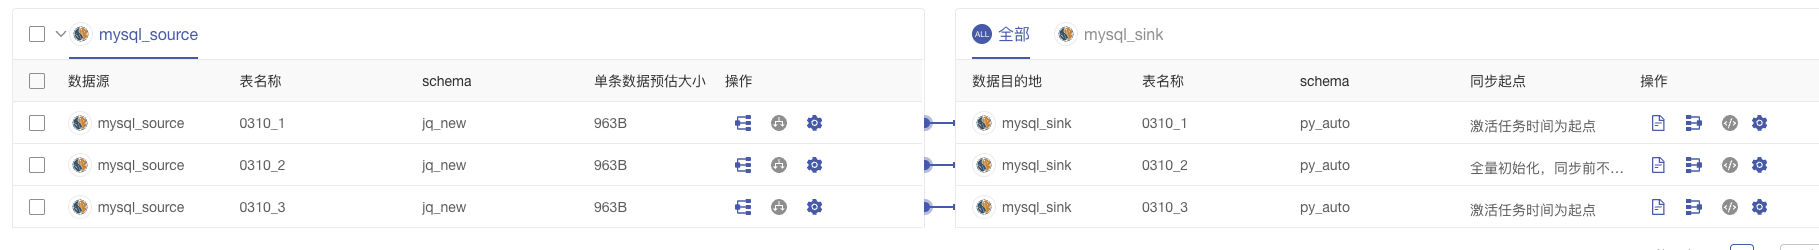
- 激活后读取正常
- 暂停给增量激活任务读取正常
- 暂停任务,二次设置分映射配置为:
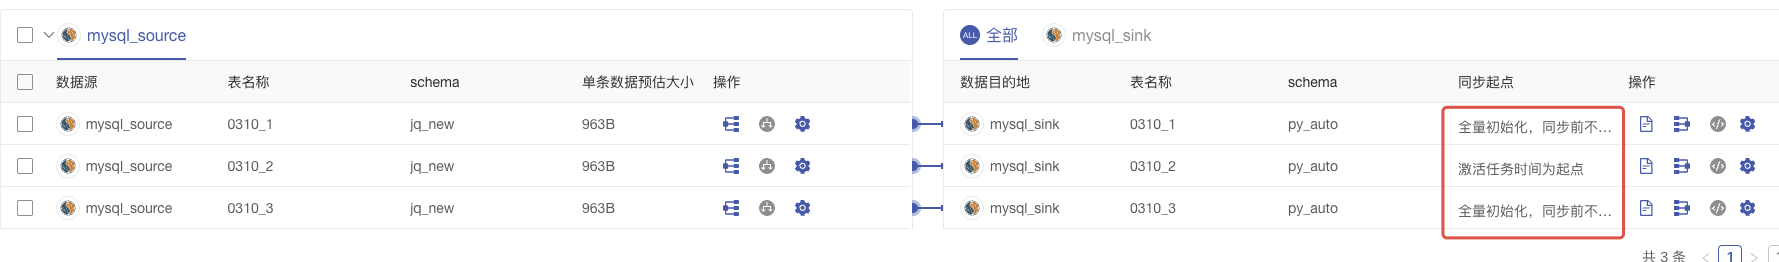
- 给增量id=119,激活后表二(二次分映射设置为激活时间)仍然读取了暂停时增量119,预期不读。暂停任务,二次设置三张表分映射为不同的起点,激活任务(结果看起来像都是用的表1的位点信息)
其他问题说明
- 指定位点需要指定同一个表结构内的数据 如果包含ddl前数据不支持(即指定位点前后表结构不一致则不支持);
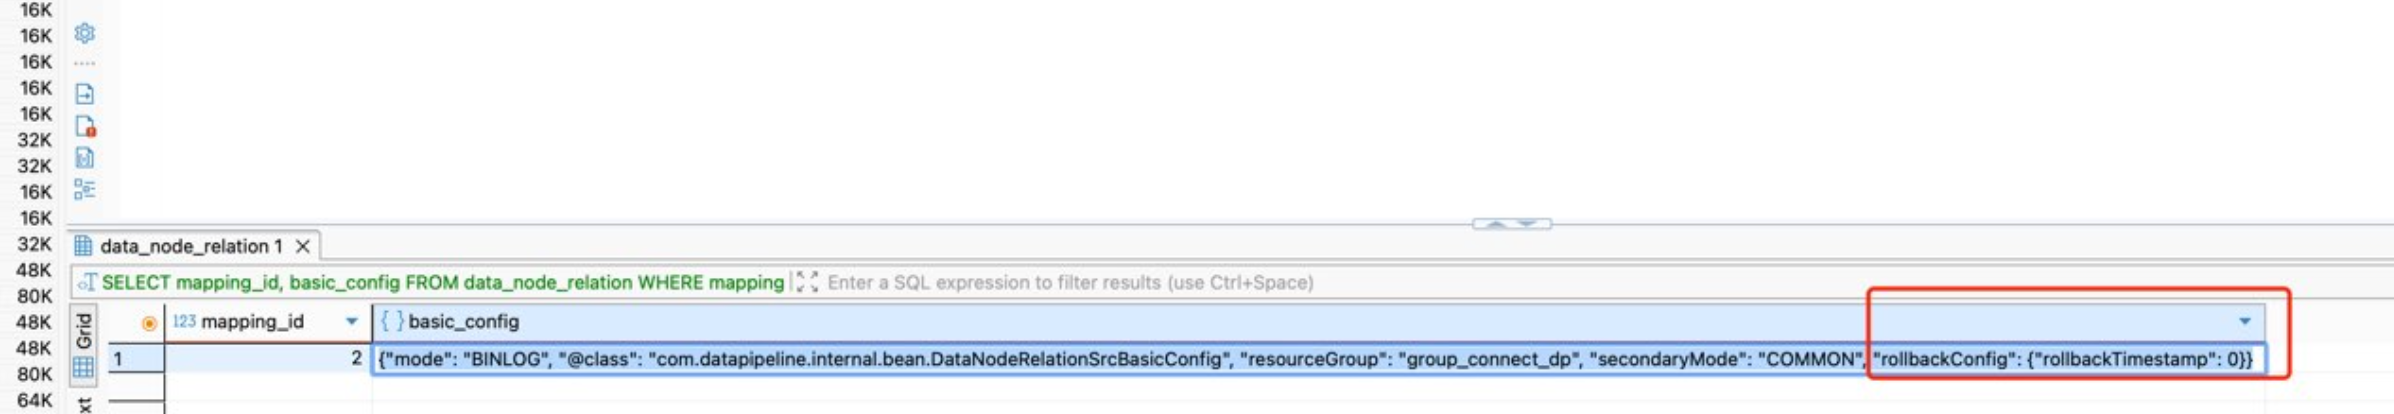
- 升级过程涉及webservie的相关表迁移,若升级后激活任务报错Caused by: java.lang.NullPointerException: Cannot invoke "com.datapipeline.internal.bean.RollbackConfig.getRollbackTimestamp()" because "rollbackConfig" is null。则可以使用下述语句检查对应配置库内容:
SELECT mapping_id, basic_config
FROM data_node_relation
WHERE mapping_id = 7 AND mapping_type = 'TASK' AND type = 'SRC'; 确认是否添加对应rollbackConfig