版本说明
- 数据源 JDBC 读取模式支持:2.x、3.2、4.2、4.4.2版本;
- 数据源 CDC 读取模式支持:2.x、3.2、4.2.5.2、4.4.2 版本;
- 数据源 CDC 读取一般情况下不支持云部署方式版本, 因为云上版本, 需要将 OBCDC 也部署到其上方, 需要特别注意网络通信;
- JDBC 写入模式支持 2.x、3.2、4.2、4.4.2 版本。
OceanBase 节点模型
节点层级
OceanBase 节点采用以下用户模型:
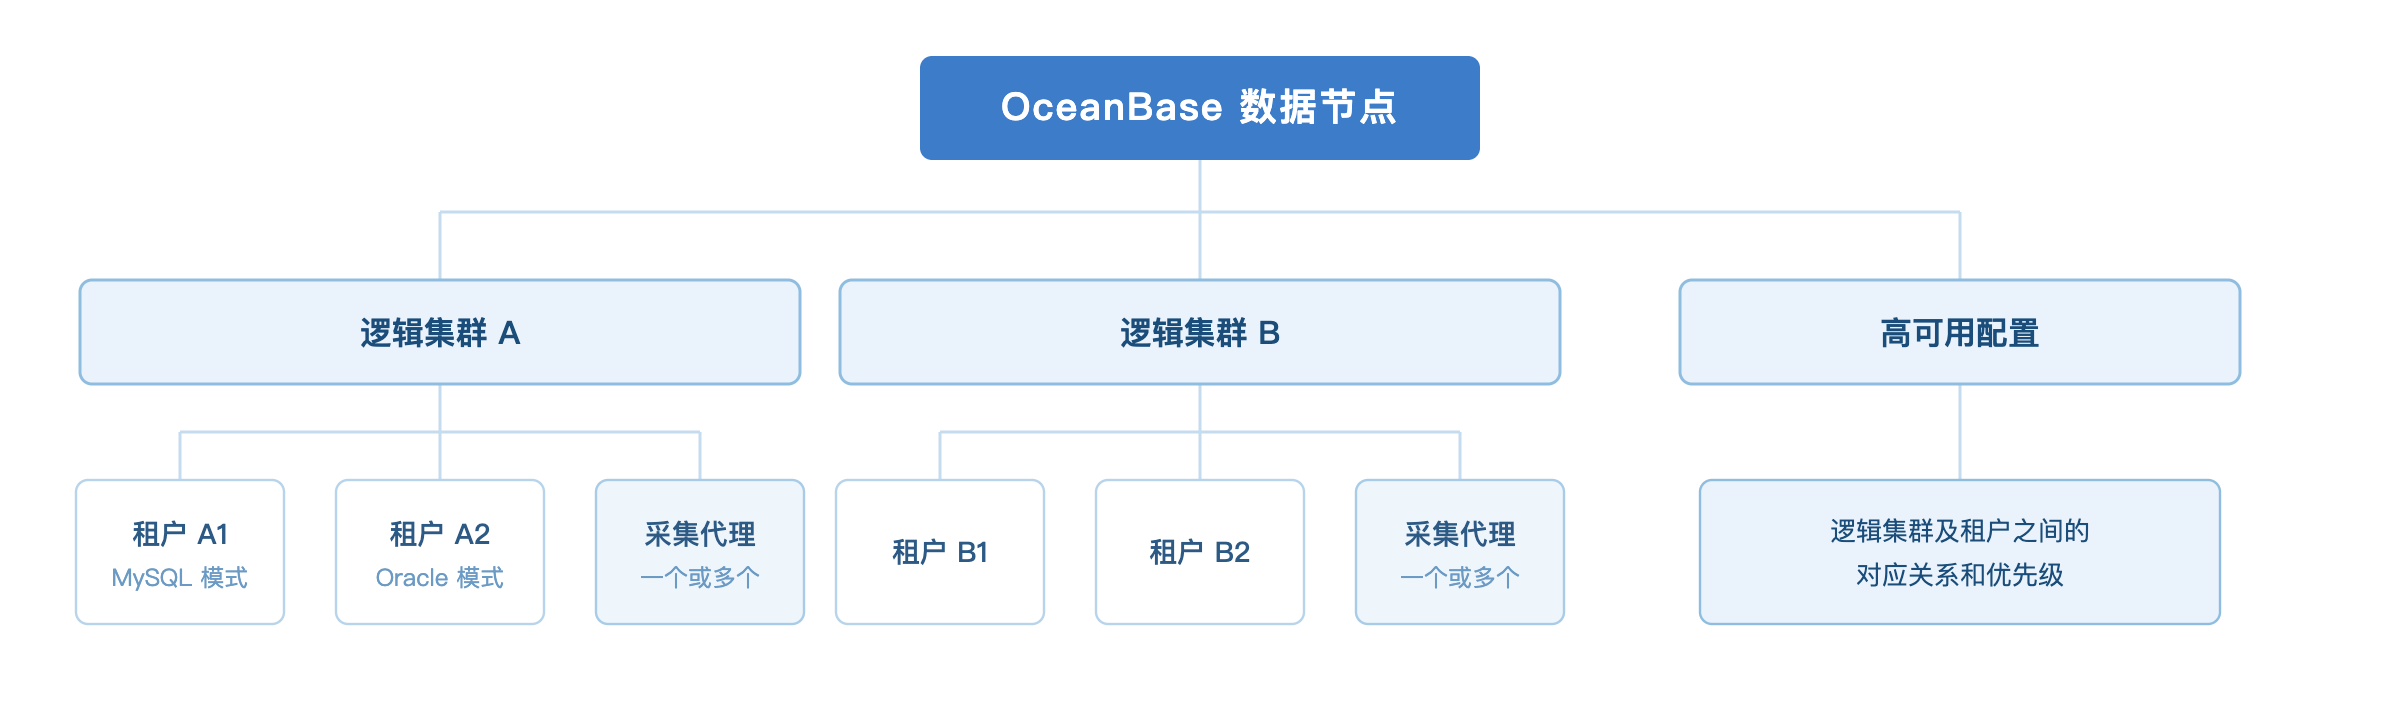
OceanBase MySQL 模式和 Oracle 模式不再要求分别创建顶层节点,兼容模式由每个租户自身配置决定。
管理边界
| 层级 | 管理内容 |
|---|---|
| 节点 | 名称、描述、版本、时区、协作人、策略、状态以及高可用关系。 |
| 逻辑集群 | 自定义集群名称、物理集群、Cluster URL、租户和采集代理。 |
| 租户 | 兼容模式、服务器地址、租户名、账号、密码、Database/Schema 和连接参数。 |
| 采集代理 | Agent 名称、地址、端口、账号、密码、状态和可用性。 |
| 高可用配置 | HA 组名称、成员集群、租户对应关系、优先级和当前活动集群。 |
读取方式
| 读取方式 | 场景 | 权限要求 | 对应功能 |
|---|---|---|---|
| JDBC | 批量同步场景,全量初始化 | 需要给用户授予相关视图和表的 SELECT 权限 | 1、选表,读取数据 2、任务运行,读取权限 |
| OB_Log_Reader | 增量监听场景 | + OB_Log_Reader(MySQL 模式) - 对源端业务数据库有 SELECT 权限。 GRANT SELECT ON \<database_name>. TO \<user_name>; - 对源端租户的 OceanBase、Information_schema 和 MySQL 数据库的 SELECT 权限。 - 在 OceanBase 数据库的 sys 租户下创建一个用户,并赋予其 select on oceanbase.* 权限GRANT SELECT ON oceanbase. TO \<user_name> ; + OB_Log_Reader(Oracle 模式) - 对于OceanBase V2.2.70 之前版本 GRANT SELECT ON . TO \<user_name>; - 对于OceanBase V2.2.70 之后版本,需要在 OceanBase 数据库的 sys 租户下创建一个用户,并赋予其 `select on oceanbase. `权限 GRANT SELECT ON oceanbase. TO \<user_name> ; + OB_Log_Reader 所需的用户与 JDBC 连接所需的用户可以不一致,OB_Log_Reader 的用户需要在 sys 租户下,并拥有 oceanbase 库的 select 权限 | 1、增量读取 2、任务运行,读取权限 |
采集代理运维
OceanBase 采集代理用于读取 OceanBase 的事务变更日志,向 DataPipeline 提供增量数据。节点重构后,一个 OceanBase 数据节点可管理多个逻辑集群;每个逻辑集群可配置多个租户和采集代理。采集代理归属逻辑集群,任务仍按所选租户及其数据运行组确定同步范围。多个租户可以共用同一采集运行上下文,系统按各租户的任务订阅将变更分发到各自的 Topic;这不意味着一个任务可以跨租户自由选择表。
采集代理承担增量日志读取。任务如包含全量阶段,业务表读取通过租户的 JDBC 连接完成。节点配置中保存 Agent 信息不会自动启动采集;需完成部署、连接校验并激活相关任务或 Agent 后,才会进入采集运行状态。
架构与工作原理
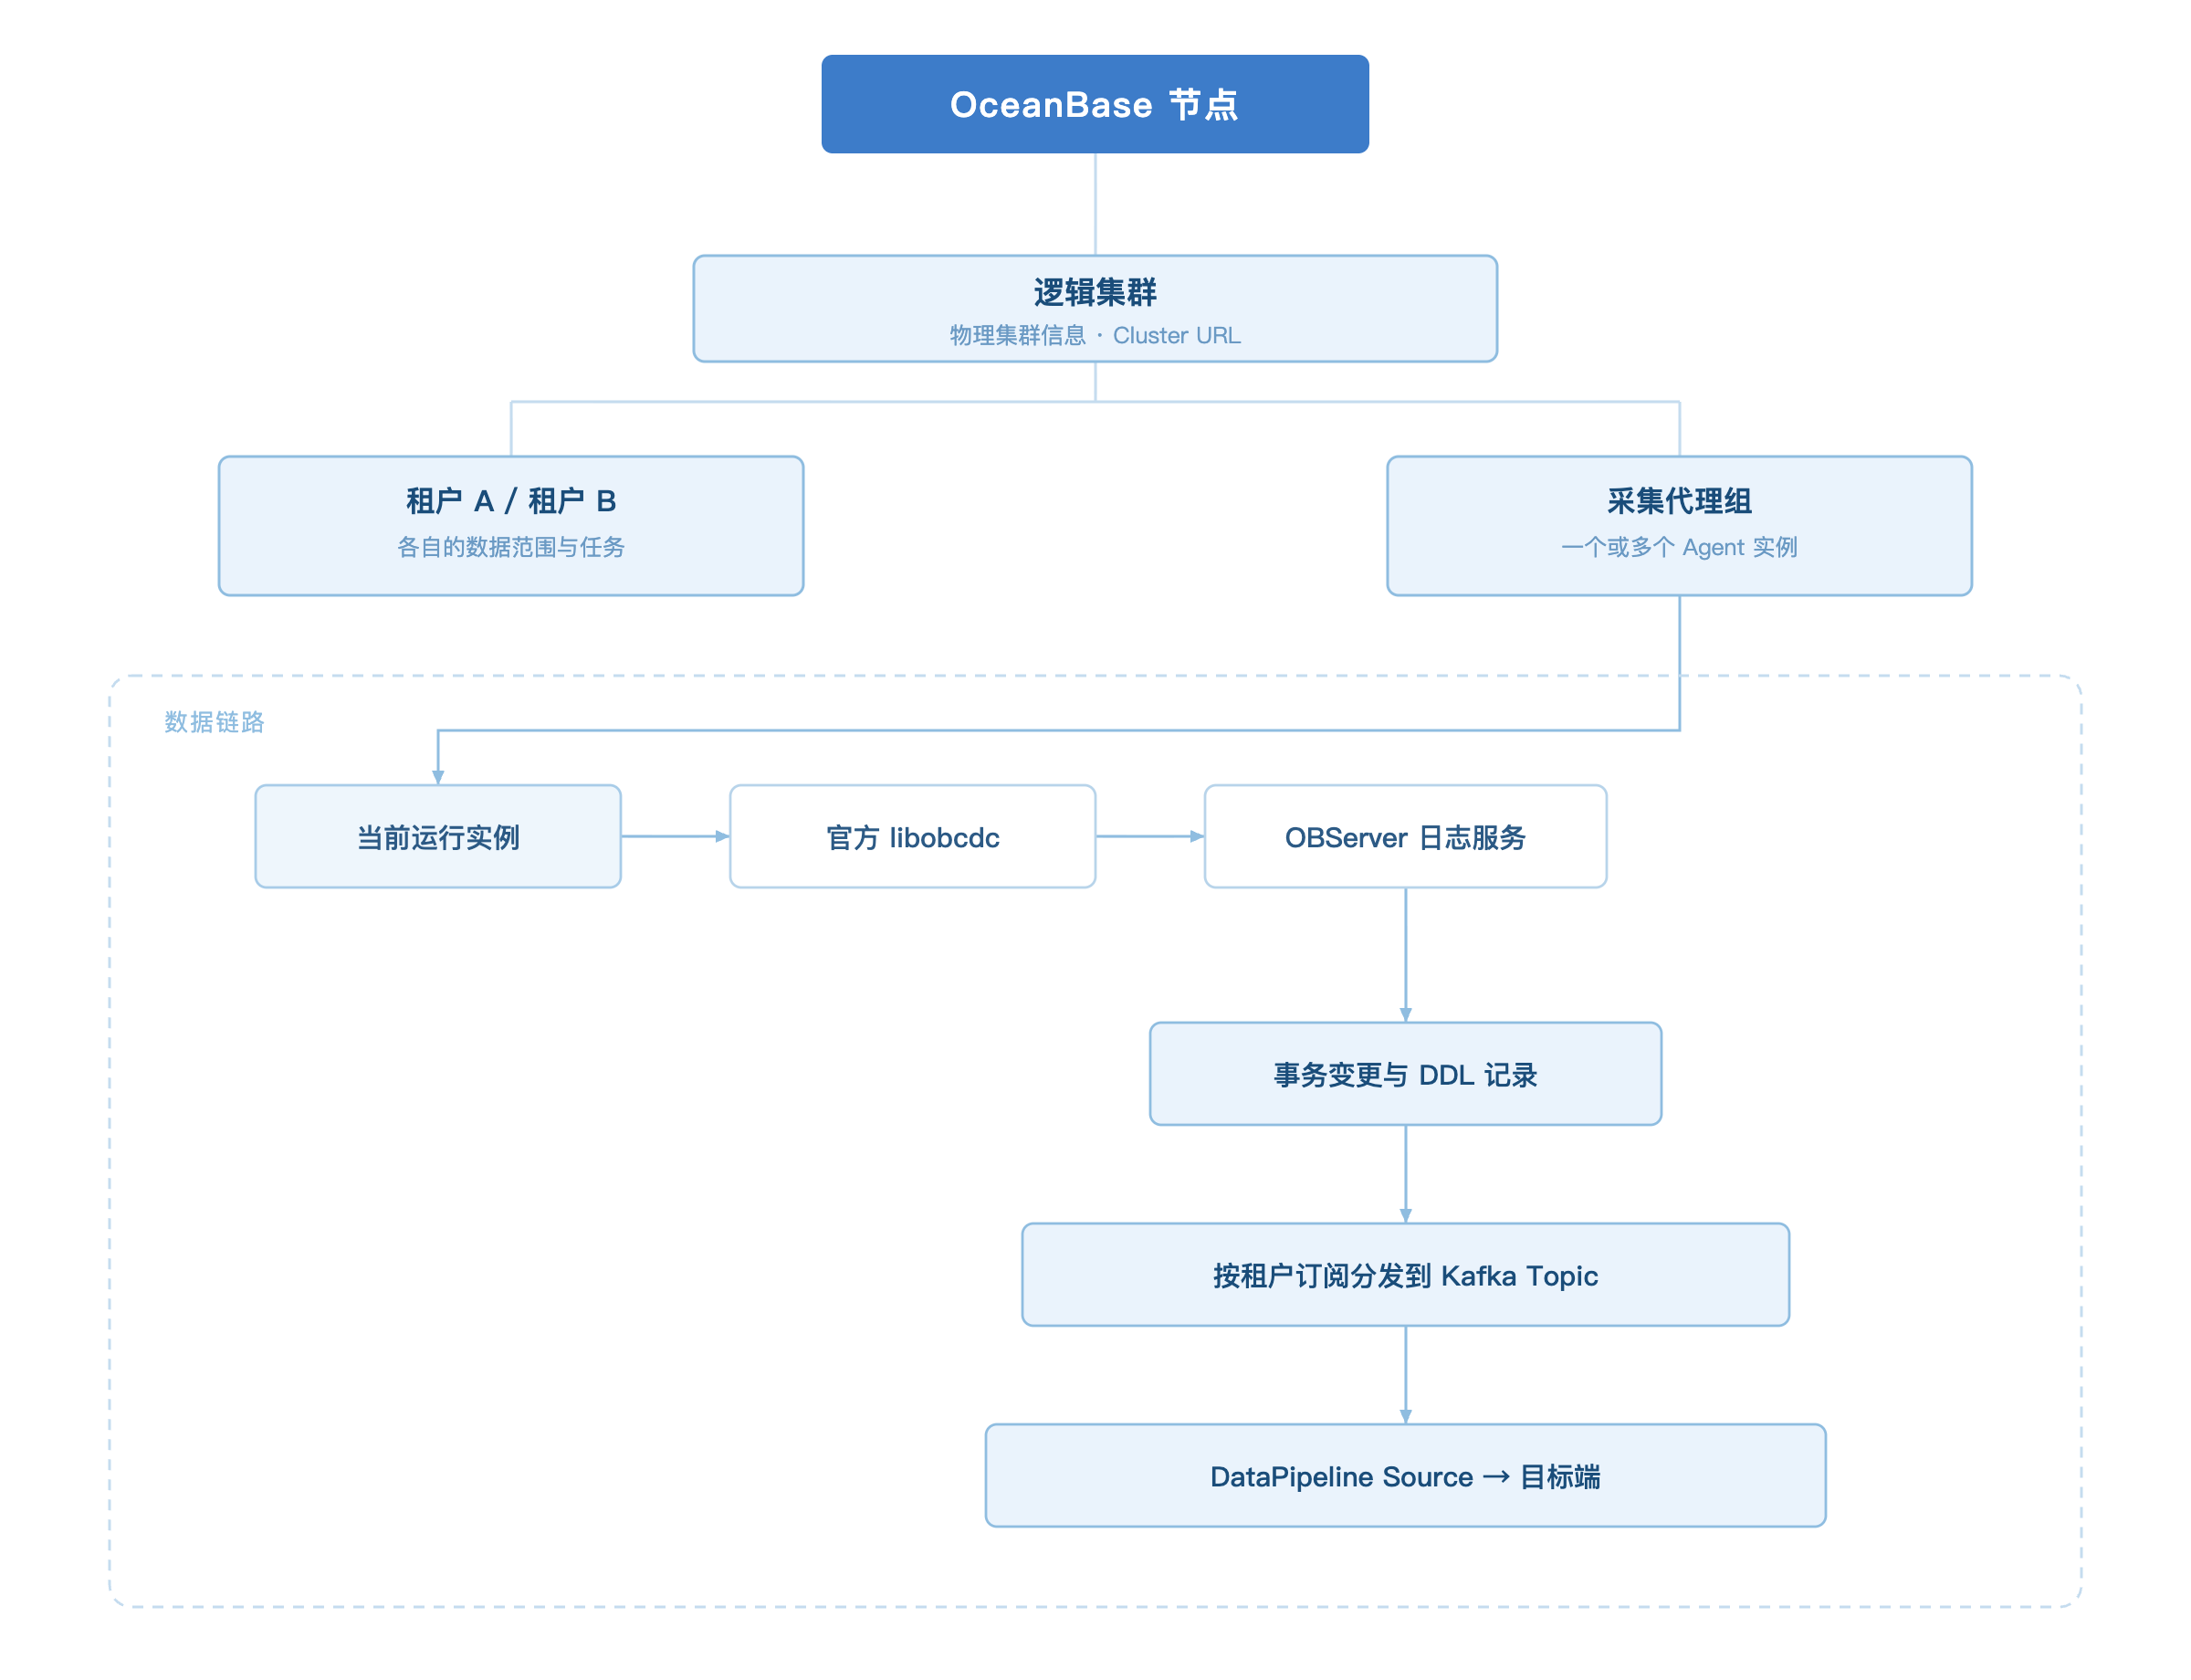
OceanBase 业务事务产生 Redo 和 Commit 日志。采集代理通过 OceanBase 官方 libobcdc 读取并还原已提交事务;默认 integrated 模式下,日志数据由 libobcdc 通过 RPC 从 OBServer 日志服务实时取得。Cluster URL 用于发现集群拓扑,不承载事务日志,也不是日志文件的下载地址。direct 模式读取归档日志,适用于另行配置的归档场景。
代理将原生变更记录转换为 DataPipeline 的统一事件,按当前有效任务的库表白名单过滤,再写入对应租户数据运行组的 Kafka Topic。DataPipeline Source 消费 Topic,完成类型、时区等转换后交给任务链路。多个租户共用采集 Reader 时,采集进度属于共享运行上下文;Topic、任务和数据实体仍按各自的数据运行组隔离。
运行关系与高可用
数据目标和采集代理分别管理高可用关系:
| 关系 | 切换对象 | 对任务的影响 |
|---|---|---|
| 数据节点高可用(Node HA) | 当前读取的逻辑集群或数据连接 | 目标数据源改变;系统需同步更新采集代理的源端、白名单和订阅。 |
| 采集代理高可用(Agent HA) | 同一候选组中的运行 Agent | 重新选择执行采集的实例;数据目标保持不变。 |
一个 Agent 组可包含多个物理实例,当前由一个实例承担采集。Agent 实例故障时,系统在该组的可用成员中重新选择运行实例;数据连接不会因此自行切换。发生 Node HA 切换时,系统根据新数据目标重新解析应使用的 Agent 组,并协调旧、新采集进程交接。若两组共用物理进程,交接会保留已有检查点和本地运行文件,避免把普通切换当作重新初始化。
节点详情中的“当前连接”和“当前 Agent”分别表示数据目标与采集执行实例。仅看到 Agent 进程处于运行状态不足以判定采集就绪;系统还要核对当前数据源、订阅配置、主实例及 Reader 状态。
断点续传与一致性边界
采集和任务消费各有独立进度:
| 层级 | 进度依据 | 恢复方式 |
|---|---|---|
| Agent 日志采集 | 官方引擎输出的安全位点及采集检查点 | Agent 重启或主备切换后,从已确认的检查点重新定位日志;HA 场景还使用协调服务保存运行检查点。 |
| DataPipeline Source | 每张表 Topic 的 Kafka 消费 offset | 任务重启后从已保存的 offset 继续消费。 |
故障恢复以最近确认安全的位点为准,边界上可能重读少量记录。应将该机制理解为优先避免漏采,而非承诺端到端“恰好一次”;目标端的幂等处理和最终一致性仍需结合具体任务配置验证。开始位点必须位于源库日志及所需数据字典的可用范围内,否则无法从该时间点恢复。
配置与启用
- 部署与 DataPipeline 版本配套的 OceanBase Agent,并确认 Agent 所在主机可以访问 OceanBase 发现入口、必要的 SQL/RPC 端口及 DataPipeline 内部 Kafka。使用非容器化安装包时,还需检查安装包内的运行环境及进程目录。
- 在 OceanBase 节点下创建逻辑集群,配置物理集群信息和
Cluster URL;为集群添加租户,填写兼容模式、连接账号及允许同步的 Database/Schema。 - 在对应逻辑集群下添加一个或多个采集代理,填写 Agent 地址、端口和登录信息。需要代理高可用时,配置多个候选成员及其优先级。
- 对租户连接、读写权限和 Agent 可用性分别校验。校验通过后,创建映射与任务,选择对应租户及数据范围,再激活采集。一个集群的校验结果不能代替其他集群或租户的校验结果。
- 在节点详情查看当前活动连接、当前 Agent、关联任务、监控与日志;首次激活后确认 Kafka Topic 和任务增量读取状态。
接入前提。 Agent 需要用于集群发现和日志读取的系统租户集群账号;业务租户账号用于表结构查询及全量读取。授权范围须按 OceanBase 版本、租户兼容模式和实际同步对象确认。Cluster URL 返回的 OBServer 地址也必须能从 Agent 主机访问;只验证入口 URL 可达不足以保证日志采集可用。[5]
日常运维
| 场景 | 建议操作 |
|---|---|
| 查看运行状态 | 在节点详情按逻辑集群查看 Agent 状态、当前运行成员、关联任务及采集监控;结合任务状态、日志和预警判断采集是否正常。 |
| 增减同步表 | 调整对应租户的任务或映射后,检查当前订阅白名单。多个租户共用 Reader 时,白名单是当前有效任务的并集,但 Topic 仍按租户数据运行组隔离。 |
| 暂停任务 | 暂停的任务从当前运行订阅中移除;Topic 不因任务暂停立即删除。普通停止保留采集检查点。 |
| 切换 Agent | 先确认候选 Agent 可用,再查看主实例是否完成切换,并核对 Reader、任务与监控状态。Agent 切换不会自动改变数据库目标。 |
| 切换数据目标 | 确认目标逻辑集群及对应租户、Agent 可用,执行 Node HA 切换后检查当前连接、当前 Agent、任务状态和增量进度。相关租户应按 HA 关系整体切换。 |
| 修改或删除 Agent | 先检查关联任务。运行中的关联任务会限制 Agent 编辑或删除;暂停相关任务后再维护,并重新校验。 |
在非容器化部署中,Agent 采用常驻 Master 管理进程与独立 Worker 采集进程:Master 提供 API、状态及 Worker 管理,Worker 加载 libobcdc 执行采集。Master 启动后,Worker 通常要等采集激活才启动。Worker 异常时,Master 根据期望运行状态、进程和心跳执行有限重试。
常见故障排查
| 现象 | 优先检查 |
|---|---|
| Agent 校验失败或无法启动 | Agent 地址、端口和账号;Agent 到 Cluster URL、OBServer SQL/RPC 端口及 Kafka 的连通性;系统租户账号权限。 |
| 已连接但没有增量数据 | 任务是否激活、库表是否进入当前白名单、当前 Agent 是否就绪、源端日志/数据字典是否覆盖起始位点、对应 Topic 和任务 offset 是否推进。 |
| Agent 切换后仍显示旧成员 | 等待切换流程结束并刷新节点详情,核对主实例、Reader、任务状态及切换日志。 |
| Worker 反复重启 | 查看 Master/Worker/JVM/原生库日志及重试状态;确认资源、网络和源端日志可用性。仅适用于采用 Master/Worker 架构的非容器化部署。 |
| 数据目标切换后采集异常 | 对照当前数据连接、Agent 候选组、租户订阅和检查点,确认目标 Agent 已完成交接且任务读取的是同一目标。 |
可用性校验反映校验时刻的状态;运行期间仍应持续观察采集延迟、任务状态和日志。强制重置会清理共享运行资源,影响同一采集上下文中的租户;应由运维人员核对全部有效任务及检查点后执行,不作为常规故障恢复操作。
启停采集代理
操作入口:<数据节点><详情><基本配置><采集代理状态>\<OBLog-Reader 状态>
功能说明:停止 OB_Log_Reader 需要依赖于 OB_Log_Reader 的增量监听数据任务为已暂停状态;
当OBLog-Reader 状态为:Agent 异常!时无法启动OB_Log_Reader,需要修复后并刷新页面后才能操作。
修改采集代理同步白名单
操作入口:<数据节点><详情><基本配置><采集代理状态>
白名单配置参考文档:
功能说明:
格式:租户名.库名.表名(例如:mytenant1.db1.tb1|mytenant2.db2.*)
这里只支持全量更新,因此每次配置的时候,需要在原有的基础上新增,暂不支持append。
采集代理自动重启
生效逻辑:采集代理遇到报错会自动重启,继续当前进度位点采集数据。
配置方法:在配置文件中进行修改,新增参数
| 参数名称 | 参数说明 | 默认值 | 单位 |
|---|---|---|---|
| CDC_ERROR_RESTART_INTERVAL | Agent错误拉启时间间隔(Schedule 文件60S内没更新且Agent状态是 Down则拉起) | 60 | 秒 |
| CDC_MONITOR_JOB_INTERVAL | Agent定时监控任务 | 10 | 秒 |
采集代理接口
cdc-controller
POST 添加channel
POST /agent/add-chan/{type}
- 请求参数
| 名称 | 位置 | 类型 | 必选 | 说明 |
|---|---|---|---|---|
| type | path | string | 是 | channel 类型 |
- 枚举值
| 属性 | 值 |
|---|---|
| type | KAFKA_STR |
| type | KAFKA_AVRO |
| type | CONSOLE |
| type | FILE |
- 返回样例
{
 "data": {},
 "msg": "string",
 "state": 0
}
- 返回结果
| 状态码 | 状态码含义 | 说明 | 数据模型 |
|---|---|---|---|
| 200 | OK | OK | com.datapipeline.obcdc.obcdc4.bean.CdcResponseJava.lang.Void |
GET 获取同步表
GET /agent/entity/{nodeId}
- 请求参数
| 名称 | 位置 | 类型 | 必选 | 说明 |
|---|---|---|---|---|
| nodeId | path | integer(int32) | 是 | none |
- 返回样例
{
  "data": {
    "tables": [
      "string"
    ]
  },
  "msg": "string",
  "state": 0
}
- 返回结果
| 状态码 | 状态码含义 | 说明 | 数据模型 |
|---|---|---|---|
| 200 | OK | OK | com.datapipeline.obcdc.obcdc4.bean.CdcResponseEntityResponse |
POST 更新同步表
POST /agent/entity/{nodeId}
- 请求参数
| 名称 | 位置 | 类型 | 必选 | 中文名 | 说明 |
|---|---|---|---|---|---|
| nodeId | path | integer(int32) | 是 | 节点id | |
| body | body | com.datapipeline.obcdc.obcdc4.bean.UpdateEntityRequest | 否 | 更新同步表请求 | none |
- 返回示例
{
  "data": {},
  "msg": "string",
  "state": 0
}
- 返回结果
| 状态码 | 状态码含义 | 说明 | 数据模型 |
|---|---|---|---|
| 200 | OK | OK | com.datapipeline.obcdc.obcdc4.bean.CdcResponseJava.lang.Void |
GET 获取当前位点
GET /agent/point/{nodeId}
- 请求参数
| 名称 | 位置 | 类型 | 必选 | 中文名 | 说明 |
|---|---|---|---|---|---|
| nodeId | path | integer(int32) | 是 | 节点id |
- 返回示例
{
  "data": "string",
  "msg": "string",
  "state": 0
}
- 返回结果
| 状态码 | 状态码含义 | 说明 | 数据模型 |
|---|---|---|---|
| 200 | OK | OK | com.datapipeline.obcdc.obcdc4.bean.CdcResponseJava.lang.String |
POST 移除channel
POST /agent/rm-chan/{type}
- 请求参数
| 名称 | 位置 | 类型 | 必选 | 中文名 | 说明 |
|---|---|---|---|---|---|
| type | path | string | 是 | channel 类型 |
- 枚举值
| 属性 | 值 |
|---|---|
| type | KAFKA_STR |
| type | KAFKA_AVRO |
| type | CONSOLE |
| type | FILE |
- 返回示例
{
  "data": {},
  "msg": "string",
  "state": 0
}
- 返回结果
| 状态码 | 状态码含义 | 说明 | 数据模型 |
|---|---|---|---|
| 200 | OK | OK | com.datapipeline.obcdc.obcdc4.bean.CdcResponseJava.lang.Void |
POST 激活
POST /agent/start/{nodeId}
- Body请求参数
{
  "clusterName": "string",
  "database": "string",
  "host": "string",
  "oceanBaseAgentConfig": {
    "password": "string",
    "user": "string"
  },
  "password": "string",
  "port": 0,
  "schema": "string",
  "username": "string"
}
- 请求参数
| 名称 | 位置 | 类型 | 必选 | 中文名 | 说明 |
|---|---|---|---|---|---|
| nodeId | path | integer(int32) | 是 | 节点id | |
| startTimestamp | query | integer(int64) | 否 | 启动时间戳 | |
| body | body | com.datapipeline.obcdc.obcdc4.bean.OceanBaseConfig | 否 | oceanbase节点配置 | none |
- 返回示例
{
 "data": {},
 "msg": "string",
 "state": 0
}
- 返回结果
| 状态码 | 状态码含义 | 说明 | 数据模型 |
|---|---|---|---|
| 200 | OK | OK | com.datapipeline.obcdc.obcdc4.bean.CdcResponseJava.lang.Void |
GET 获取状态
GET /agent/status/{nodeId}
- 请求参数
| 名称 | 位置 | 类型 | 必选 | 中文名 | 说明 |
|---|---|---|---|---|---|
| nodeId | path | integer(int32) | 是 | 节点id |
- 返回示例
{
 "data": "RUN",
 "msg": "string",
 "state": 0
}
- 返回结果
| 状态码 | 状态码含义 | 说明 | 数据模型 |
|---|---|---|---|
| 200 | OK | OK | com.datapipeline.obcdc.obcdc4.bean.CdcResponseCom.datapipeline.obcdc.obcdc4.service.cdc.module.State |
POST 停止
POST /agent/stop/{nodeId}
- 请求参数
| 名称 | 位置 | 类型 | 必选 | 中文名 | 说明 |
|---|---|---|---|---|---|
| nodeId | path | integer(int32) | 是 | 节点id |
- 返回示例
{
 "data": {},
 "msg": "string",
 "state": 0
}
- 返回结果
| 状态码 | 状态码含义 | 说明 | 数据模型 |
|---|---|---|---|
| 200 | OK | OK | com.datapipeline.obcdc.obcdc4.bean.CdcResponseJava.lang.Void |
POST 校验
POST /agent/validate/{nodeId}
- Body 请求参数
{
 "clusterName": "string",
 "database": "string",
 "host": "string",
 "oceanBaseAgentConfig": {
   "password": "string",
   "user": "string"
},
 "password": "string",
 "port": 0,
 "schema": "string",
 "username": "string"
}
- 请求参数
| 名称 | 位置 | 类型 | 必选 | 中文名 | 说明 |
|---|---|---|---|---|---|
| nodeId | path | integer(int32) | 是 | 节点id | |
| body | body | com.datapipeline.obcdc.obcdc4.bean.OceanBaseConfig | 否 | oceanbase节点配置 | none |
- 返回示例
{
 "data": {},
 "msg": "string",
 "state": 0
}
- 返回结果
| 状态码 | 状态码含义 | 说明 | 数据模型 |
|---|---|---|---|
| 200 | OK | OK | com.datapipeline.obcdc.obcdc4.bean.CdcResponseJava.lang.Void |
health-controller
GET 健康运行状态
GET /health
- 返回示例
{
 "data": {
   "currentScn": 0,
   "nodeId": 0,
   "password": "string",
   "state": "string",
   "timestamp": 0,
   "url": "string",
   "user": "string"
},
 "msg": "string",
 "state": 0
}
- 返回结果
| 状态码 | 状态码含义 | 说明 | 数据模型 |
|---|---|---|---|
| 200 | OK | OK | RunInfoEntity |
sys-controller
GET 心跳
GET /ping
- 返回结果
| 状态码 | 状态码含义 | 说明 | 数据模型 |
|---|---|---|---|
| 200 | OK | OK | string |
数据模型
RunInfoEntity
 {
 "currentScn": 0,
 "nodeId": 0,
 "password": "string",
 "state": "string",
 "timestamp": 0,
 "url": "string",
 "user": "string"
}
- 属性
| 名称 | 类型 | 必选 | 约束 | 中文名 | 说明 |
|---|---|---|---|---|---|
| currentScn | integer(int64) | false | none | none | |
| nodeId | integer(int32) | false | none | none | |
| password | string | false | none | none | |
| state | string | false | none | none | |
| timestamp | integer(int64) | false | none | none | |
| url | string | false | none | none | |
| user | string | false | none | none |
UpdateEntityRequest
 {
 "tables": [
   "string"
]
}
- 属性
| 名称 | 类型 | 必选 | 约束 | 中文名 | 说明 |
|---|---|---|---|---|---|
| tables | [string] | false | none | 待同步的表(array of database.schema.table) |
OceanBaseConfig$CdcConfig
{
 "password": "string",
 "user": "string"
}
- 属性
| 名称 | 类型 | 必选 | 约束 | 中文名 | 说明 |
|---|---|---|---|---|---|
| password | string | false | none | sys 租户用户密码 | |
| user | string | false | none | sys 租户用户名 |
OceanBaseConfig
{
 "clusterName": "string",
 "database": "string",
 "host": "string",
 "oceanBaseAgentConfig": {
   "password": "string",
   "user": "string"
},
 "password": "string",
 "port": 0,
 "schema": "string",
 "username": "string"
}
- 属性
| 名称 | 类型 | 必选 | 约束 | 中文名 | 说明 |
|---|---|---|---|---|---|
| clusterName | string | false | none | 集群名称 | |
| database | string | false | none | 数据库 | |
| host | string | false | none | 地址 | |
| oceanBaseAgentConfig | OceanBaseConfig$CdcConfig | false | none | none | |
| password | string | false | none | 密码 | |
| port | integer(int32) | false | none | 端口 | |
| schema | string | false | none | 架构 | |
| username | string | false | none | 用户 |
EntityResponse
{
 "tables": [
   "string"
]
}
- 属性
| 名称 | 类型 | 必选 | 约束 | 中文名 | 说明 |
|---|---|---|---|---|---|
| tables | [string] | false | none | 同步的表(array of database.schema.table) |
CdcResponse
{
 "data": {},
 "msg": "string",
 "state": 0
}
- 属性
| 名称 | 类型 | 必选 | 约束 | 中文名 | 说明 |
|---|---|---|---|---|---|
| data | object | false | none | 数据 | |
| msg | string | false | none | 信息 | |
| state | integer(int32) | false | none | 状态码 |
CdcResponse & String
{
 "data": "string",
 "msg": "string",
 "state": 0
}
- 属性
| 名称 | 类型 | 必选 | 约束 | 中文名 | 说明 |
|---|---|---|---|---|---|
| data | string | false | none | 数据 | |
| msg | string | false | none | 信息 | |
| state | integer(int32) | false | none | 状态码 |
CdcResponse & RunInfoEntity
{
 "data": {
   "currentScn": 0,
   "nodeId": 0,
   "password": "string",
   "state": "string",
   "timestamp": 0,
   "url": "string",
   "user": "string"
},
 "msg": "string",
 "state": 0
}
- 属性
| 名称 | 类型 | 必选 | 约束 | 中文名 | 说明 |
|---|---|---|---|---|---|
| data | RunInfoEntity | false | none | 数据 | |
| msg | string | false | none | 信息 | |
| state | integer(int32) | false | none | 状态码 |
CdcResponse & State
{
 "data": "RUN",
 "msg": "string",
 "state": 0
}
- 属性
| 名称 | 类型 | 必选 | 约束 | 中文名 | 说明 |
|---|---|---|---|---|---|
| data | string | false | none | 数据 | |
| msg | string | false | none | 信息 | |
| state | integer(int32) | false | none | 状态码 |
- 枚举值
| 属性 | 值 |
|---|---|
| data | RUN |
| data | STOP |
| data | ERROR |
CdcResponseEntityResponse
{
 "data": {
   "tables": [
     "string"
  ]
},
 "msg": "string",
 "state": 0
}
- 属性
| 名称 | 类型 | 必选 | 约束 | 中文名 | 说明 |
|---|---|---|---|---|---|
| data | EntityResponse | false | none | 数据 | |
| msg | string | false | none | 信息 | |
| state | integer(int32) | false | none | 状态码 |
采集代理监控
OceanBase 采集代理监控提供采集代理程序的状态、速率、延迟等关键监控指标。
关于此功能
- 采集代理基本信息
- 采集代理状态
- 运行中
- 已暂停
- 错误
- 监控指标列表
| 指标 | 指标说明 |
|---|---|
| 已解析日志量 | 累计值,指采集代理自上次启动以来解析的日志量,单位kb |
| 日志解析速率 | 速率值,指随时间变化的采集代理解析日志的速率,单位kb/s 因日志中不是所有数据都会同步,不代表同步速率/传输速率 |
| 解析进程积压时间 | 时间值,指采集代理当前处理到的日志时点与最新日志时间的时间差值,单位ms |
| 系统处理延时-P95 | 时间值,指采集代理自身的处理延迟,在采样时间段内P95置信区间内的延时表现,可以理解为统计意义平均值,单位ms |
| 系统处理延时-MAX | 时间值,指采集代理自身的处理延迟,在采样时间段内的最大值,单位ms |
| 系统处理延时-MIN | 时间值,指采集代理自身的处理延迟,在采样时间段内的最小值,单位ms |
| 采集代理延迟(数据库事务提交时间-数据写入缓存时间) | 时间值,指采集代理数据处理的整体延迟,计算方式为数据库事务提交时间-数据写入缓存时间的差值,单位ms |
操作步骤
- 在 OceanBase 数据节点中,点击采集代理监控TAB
- 选择时间区间
- 查看监控数据
注意事项
- 采集代理监控数据默认保存最近15天
写入方式
| 写入方式 | 场景 | 权限要求 | 对应功能说明 |
|---|---|---|---|
| JDBC | 写入 | + MYSQL 模式 - 需要给用户授予 CREATE、SELECT、INSERT、UPDATE、DELETE、DROP、INDEX、ALTER 权限 GRANT CREATE、SELECT、INSERT、UPDATE、DELETE、DROP、INDEX、ALTER ON \<database_name>. TO \<user_name>; + ORACLE 模式 - 需要给用户授予业务库的 CREATE_SESSION、CREATE Y ANTABLE、ALTER ANY TABLE、DELETE ANY TABLE、DROP ANY TABLE、COMMENT ANY TABLE、INSERT ANY TABLE、SELECT ANY TABLE、UPDATE ANY TABLE、CREATE ANY INDEX 权限 * GRANT CREATE_SESSION、CREATE ANY TABLE、ALTER ANY TABLE、DELETE ANY TABLE、DROP ANY TABLE、COMMENT ANY TABLE、INSERT ANY TABLE、SELECT ANY TABLE、UPDATE ANY TABLE、CREATE ANY INDEX TO \<user_name>; | 1、创建表 2、任务运行,读取写入权限 3、选表,写入数据 4、清空目的地表 5、删除重建表,结构变化 |
创建 OceanBase 节点
创建流程
- 进入数据节点列表,选择创建节点。
- 选择 OceanBase 节点类型和版本。
- 填写节点基本信息。
- 在 OceanBase 集群配置中添加至少一个逻辑集群。
- 为每个逻辑集群配置至少一个租户。
- 按需为逻辑集群添加采集代理。
- 保存节点。
- 进入节点详情,对租户和采集代理执行可用性校验。
- 存在多个可互相切换的集群时,再配置高可用关系。
创建页面中的 OceanBase 配置用于保存集群、租户和 Agent 信息,不会自动激活 Agent,也不会自动刷新数据库元数据。
节点基本信息
节点基本信息包括名称、描述、版本、时区、协作人以及节点级策略或限制。节点创建完成后,节点级编辑主要用于修改这些全局信息;集群、租户和 Agent 应在相应层级分别维护。
逻辑集群配置
| 字段 | 是否必填 | 说明 |
|---|---|---|
| 逻辑集群名称 | 是 | 用户自定义名称,同一 OceanBase 节点内必须唯一。 |
| 物理集群 | 是 | 实际 OceanBase 物理集群名称。 |
| Cluster URL | 条件必填 | 是否需要填写取决于日志拉取模式和后端校验。 |
默认至少保留一组逻辑集群配置,不允许删除最后一组。添加多组集群后,可以删除新增集群;删除集群会同时删除其下的租户和 Agent 配置,需要二次确认。
日志拉取模式说明:
- integrated:默认模式,通过 OBServer RPC 拉取日志,需要 OBServer 地址以及系统租户账号信息;
- direct:直接消费归档日志,不向 OBServer 发送 RPC,但 obcdc 所在主机必须能访问归档目的端。
创建阶段 Cluster URL 可能不被前端强制要求,但配置增量采集、执行 Agent 校验或保存时,仍可能根据服务端提示要求补充。
租户配置
每个逻辑集群至少配置一个租户。租户字段包括:
| 字段 | 说明 |
|---|---|
| 服务器地址 | 使用 IP:PORT或 HOST:PORT 格式。 |
| 租户类型 | 选择 MySQL 模式或 Oracle 模式。创建后不允许直接修改。 |
| 租户名 | 同一逻辑集群下不可重复。 |
| 用户名、密码 | 用于连接当前租户。 |
| Schema/Database | 指定该账号允许同步的数据范围,页面名称根据租户模式显示。 |
| 连接参数 | OceanBase JDBC 扩展连接参数。 |
只有一个租户时,不允许删除最后一个租户。单击添加按钮可以继续增加租户配置。
产品设计材料中对 MySQL/Oracle 模式的
Schema/Database显示名称存在个别表述差异。实际使用应以当前页面字段名和该租户的 OceanBase 兼容模式为准。
采集代理配置
采集代理按逻辑集群管理,一个集群可以配置多个 Agent,并形成 Agent HA。主要字段包括:
- 采集代理名称;
- 服务器地址;
- 服务器端口;
- 用户名和密码;
- 所属采集集群。
创建时保存 Agent 配置,但不会自动激活。完成部署和连接配置后,需要在节点详情中校验并激活。
OceanBase 节点详情
连接配置
连接配置按逻辑集群展示租户和采集代理:
- 未加入 HA 的逻辑集群以单机集群卡片展示;
- 已加入 HA 的逻辑集群按 HA 配置聚合展示;
- 当前活动集群显示连接标识;
- 集群优先级决定自动切换顺序;
- 集群、租户和 Agent 各自提供相应的查看、校验和管理入口。
在 v5.12.0 实际页面中,进入 基本配置 可查看“基础配置”和“连接配置”。页面提供 添加集群、高可用配置 和编辑入口;每个集群展示单机或 HA 属性、优先级及物理集群信息,租户配置按集群归属集中展示。
租户卡片
租户卡片展示:
- 租户名称和兼容模式;
- 服务器地址;
- 用户名;
- Database/Schema 范围;
- JDBC 连接状态;
- JDBC 读取权限;
- JDBC 写入权限;
- 关联任务数;
- 校验、编辑和删除操作。
可用性校验分别检查 JDBC 连通性、读取权限和写入权限。失败时应根据页面提示补充权限或修正连接信息。
租户类型创建后不可修改。存在运行中关联任务时,租户编辑和删除会被限制,应先暂停所有相关任务。
采集代理卡片
采集代理卡片通常展示:
- Agent 名称;
- 服务器地址和端口;
- 登录用户;
- 当前状态;
- 可用性校验结果;
- 关联任务数;
- 校验、编辑和删除操作。
Agent 存在运行中关联任务时,不允许编辑或删除。一个逻辑集群包含多个 Agent 时,系统在可用成员中进行选举。
监控与 Topic
监控页组织
| 区域 | 选择方式 | 展示内容 |
|---|---|---|
| 节点统计与并行数 | 先选逻辑集群,再选该集群下的租户;默认第一个集群及其第一个租户 | 所选租户的并行数及节点读写统计、趋势。不同租户的数据应分别查看。 |
| 采集代理监控 | 选择逻辑集群;默认第一个集群。再点击该集群下的 Agent 名称标签 | 当前 Agent 的基本信息、状态、采集指标及可用的运维入口。切换 Agent 标签可比较同集群的候选实例。 |
| Topic | 按逻辑集群和租户联动筛选;默认全部 | Topic 列表、数量及占用情况,并通过“集群”“租户”字段识别归属;支持按名称查询和刷新。 |
采集代理监控
选择集群后,页面列出该集群的 Agent 名称标签。点击标签查看相应实例;未配置 Agent 的集群不会产生采集代理监控数据,应先在 基本配置 → 连接配置 中核对 Agent 配置。
Agent 可观测页设计将信息分为以下几类:
| 类别 | 主要信息 | 使用场景 |
|---|---|---|
| 基本信息 | 服务器地址、端口、采集数据库地址、用户名;高可用时标识当前主实例 | 确认监控对象及实际执行采集的 Agent。 |
| 运行状态 | 采集代理状态、启动时间、版本、节点/任务标识、CPU、内存、磁盘和延迟 | 判断实例是否在线及资源是否异常。Agent 暂停后,部分实时状态可能无法取得。 |
| 数据处理 | 日志解析量和解析速率、解析积压时间、重启事件、处理延迟、Kafka 写入速率及事务处理量等趋势 | 观察采集积压、处理能力及进度变化。可按时间范围查看。 |
| 订阅与日志 | 同步表白名单、运行日志 | 核对实际监听表并定位启动、采集和切换问题。 |
OceanBase 监控按集群和租户查看:
- 并行数统计支持选择逻辑集群和租户;
- 采集代理监控支持先选择集群,再查看该集群的 Agent;
- Topic 列表支持按集群和租户筛选;
- Topic 列表增加集群和租户字段,用于识别 Topic 所属范围。
节点详情默认进入 节点监控。页面显示并行数、读取速率、写入速率及最近 24 小时趋势;采集代理监控支持查看同步表白名单。未配置采集代理时,页面会明确提示当前集群未配置采集代理。Topic 区域展示 Topic 数量、所属集群、所属租户和占用大小,并支持按 Topic 名称查询及手动刷新。
策略、成员和审计信息
OceanBase 节点详情还提供以下管理页签:
| 页签 | 功能说明 |
|---|---|
| 策略配置 | 管理语义映射策略、连接自动切换、检查点、运行预警、日志保留与日志文件输出。语义映射策略可按源租户类型匹配目标节点类型和版本。 |
| 成员配置 | 按开发者、只读者分配节点协作权限。开发者可管理配置及其他成员;只读者仅可查看。 |
| 预警 | 按集群、租户、预警级别、预警指标和时间范围查看节点预警。 |
| 日志 | 按集群、租户、时间和日志属性筛选操作及状态日志,并支持下载。节点可用性校验日志会记录所属集群、租户及支持的读写模式。 |
| 相关映射 | 按映射名称、集群和租户查询当前节点关联的数据映射。 |
| 相关任务 | 按任务名称、集群和租户查询当前节点关联的数据任务。 |
节点头部始终显示节点名称、启用状态、创建人和创建时间,并根据权限提供编辑、删除入口。执行删除、连接调整或策略变更前,应先通过“相关映射”和“相关任务”确认影响范围。
节点特性
部署架构
支持单机和集群架构,OB Server 的集群模式有多种, 并且每个版本都不同, 比较常见的就是\ 3.x 的 主备集群, 该模式需要DBA手动切换使用,4.x 的 主备租户DataPipeline都是支持的
表
| 表类型 | 支持读取 | 支持写入 |
|---|---|---|
| 普通表 | ✅ | ✅ |
| 分区表 | ✅ | ✅ |
| 索引表 (基础表的基础上创建索引) | ✅ | ✅ |
| 系统表 | ❌ | ❌ |
视图
| 视图类型 | 支持读取 | 支持写入 |
|---|---|---|
| 普通视图 | ✅ | ❌ |
索引
当前支持在创建目的表时,可以创建索引,目前支持的索引类型及配置
| 索引类型 | 索引存储方式 | 排序 |
|---|---|---|
| 普通索引 | Btree | 支持配置 |
| 唯一索引 | Btree | 支持配置 |
| 主键索引 | Btree | 不支持配置,默认为升序 |
数据类型
MySQL模式
| 数据类型分类 | 官方类型 | DP定义类型 | 作为源支持情况 | 作为目的地支持情况 | 备注 |
|---|---|---|---|---|---|
| 数值类型 | INT/INTEGER | INT | ✔️ | ✔️ | INT等价于INTEGER。 |
| INT_UNSIGNED | ✔️ | ✔️ | 所有数据类型都可以同时使用UNSIGNED关键字声明为无符号类型,这会导致值域发生变化。 | ||
| TINYINT | TINYINT | ✔️ | ✔️ | BOOL等价于BOOLEAN,这两个类型又等价于TINYINT(1)。 | |
| TINYINT_UNSIGNED | ✔️ | ✔️ | |||
| BIGINT | BIGINT | ✔️ | ✔️ | ||
| BIGINT_UNSIGNED | ✔️ | ✔️ | |||
| SMALLINT | SMALLINT | ✔️ | ✔️ | ||
| SMALLINT_UNSIGNED | ✔️ | ✔️ | |||
| MEDIUMINT | MEDIUMINT | ✔️ | ✔️ | ||
| MEDIUMINT_UNSIGNED | ✔️ | ✔️ | |||
| DECIMAL/NUMERIC | DECIMAL | ✔️ | ✔️ | DECIMAL等价于NUMERIC | |
| DOUBLE | DOUBLE | ✔️ | ✔️ | ||
| FLOAT | FLOAT | ✔️ | ✔️ | ||
| BIT | BIT | ✔️ | ✔️ | ||
| 字符类型 | VARCHAR | VARCHAR | ✔️ | ✔️ | |
| JSON | JSON | ✔️ | ✔️ | OceanBase 4.x 及以上版本支持的字段类型。 | |
| CHAR | CHAR | ✔️ | ✔️ | ||
| VARBINARY | VARBINARY | ✔️ | ✔️ | ||
| BINARY | BINARY | ✔️ | ✔️ | ||
| enum | ENUM | ✔️ | ✔️ | ||
| set | SET | ✔️ | ✔️ | ||
| 日期和时间类型 | DATETIME | DATETIME | ✔️ | ✔️ | |
| TIMESTAMP | TIMESTAMP | ✔️ | ✔️ | ||
| DATE | DATE | ✔️ | ✔️ | ||
| TIME | TIME | ✔️ | ✔️ | ||
| YEAR | YEAR | ✔️ | ✔️ | ||
| 大对象类型 | TINYTEXT | TINYTEXT | ✔️ | ✔️ | |
| TINYBLOB | TINYBLOB | ✔️ | ✔️ | ||
| TEXT | TEXT | ✔️ | ✔️ | ||
| BLOB | BLOB | ✔️ | ✔️ | ||
| MEDIUMTEXT | MEDIUMTEXT | ✔️ | ✔️ | ||
| MEDIUMBLOB | MEDIUMBLOB | ✔️ | ✔️ | ||
| LONGTEXT | LONGTEXT | ✔️ | ✔️ | ||
| LONGBLOB | LONGBLOB | ✔️ | ✔️ | ||
| 空间数据类型 | GEOMETRY | ❌ | ❌ | ❌ | 空间数据类型均不支持 |
| POINT | ❌ | ❌ | ❌ | ||
| LINESTRING | ❌ | ❌ | ❌ | ||
| POLYGON | ❌ | ❌ | ❌ | ||
| MULTIPOINT | ❌ | ❌ | ❌ | ||
| MULTILINESTRING | ❌ | ❌ | ❌ | ||
| MULTIPOLYGON | ❌ | ❌ | ❌ | ||
| GEOMETRYCOLLECTION | ❌ | ❌ | ❌ |
Oracle 模式
| 数据类型分类 | 官方类型 | DP定义类型 | 作为源支持情况 | 作为目的地支持情况 | 备注 |
|---|---|---|---|---|---|
| 数值类型 | NUMBER | NUMBER | ✔️ | ✔️ | |
| BINARY_DOUBLE | BINARY_DOUBLE | ✔️ | ✔️ | ||
| FLOAT | FLOAT | ✔️ | ✔️ | ||
| BINARY_FLOAT | BINARY_FLOAT | ✔️ | ✔️ | ||
| 字符类型 | CHAR(n [char | byte]) | CHAR | ✔️ | ✔️ |
| NCHAR[(size)] | NCHAR | ✔️ | ✔️ | ||
| NVARCHAR2(size) | NVARCHAR2 | ✔️ | ✔️ | ||
| VARCHAR2(n [char | byte]) | VARCHAR2 | ✔️ | ✔️ | |
| VARCHAR(n [char | byte]) | VARCHAR2 | ✔️ | ❌ | |
| 日期和时间类型 | DATE | DATE | ✔️ | ✔️ | |
| TIMESTAMP [(scale)] | TIMESTAMP | ✔️ | ✔️ | ||
| TIMESTAMP [(scale)] WITH TIME ZONE | TIMESTAMP WITH TIME ZONE | ✔️ | ✔️ | ||
| TIMESTAMP [(scale)] WITH LOCAL TIME ZONE | TIMESTAMP WITH LOCAL TIME ZONE | ✔️ | ✔️ | ||
| INTERVAL YEAR TO MONTH | INTERVAL DAY TO SECOND | ✔️ | ✔️ | ||
| INTERVAL DAY TO SECOND | INTERVAL YEAR TO MONTH | ✔️ | ✔️ | ||
| 大对象类型 | BLOB | BLOB | ✔️ | ✔️ | |
| CLOB | CLOB | ✔️ | ✔️ | ||
| RAW数据类型 | RAW | RAW | ✔️ | ✔️ | |
| JSON数据类型 | JSON | JSON | ✔️ | ✔️ | OceanBase 4.x 及以上版本支持的字段类型。 |
| XML数据类型 | XMLTYPE | XMLTYPE | ✔️ | ✔️ | OceanBase 4.x 及以上版本支持的字段类型。 |
| Rowid数据类型 | ROWID | ❌ | ❌ | ❌ | |
| UROWID | ❌ | ❌ | ❌ | ||
| 空间数据类型 | SDO_GEOMETRY | ❌ | ❌ | ❌ |
DML
ORACLE模式
读取
| 读取模式 | DML识别 | 捕获信息 | 限制 |
|---|---|---|---|
| JDBC | INSERT | 源端读取支持的所有字段类型 | 【限制】不支持列筛选 |
| CDC | INSERT | 源端读取支持的所有字段类型 | |
| UPDATE | before:支持的所有字段 after:支持的所有字段 | ||
| UPSERT | before:支持的所有字段 after:支持的所有字段 | ||
| DELETE | before:支持的所有字段 after:null |
写入
| 写入策略 | 写入SQL语法 | 限制 |
|---|---|---|
| INSERT | INSERT %s INTO %s (%s) VALUES (%s) | |
| UPDATE | UPDATE %s SET %s WHERE %s | |
| DELETE | DELETE FROM %s WHERE (%s) in (%s) | |
| MERGE | INSERT INTO %s (%s) VALUES %s on duplicate key update %s | |
| IGNORE | 忽略,不做写入 |
MYSQL模式
读取
| 读取模式 | DML识别 | 捕获信息 | 限制 |
|---|---|---|---|
| JDBC | INSERT | 源端读取支持的所有字段类型 | 【限制】不支持列筛选 |
| CDC | INSERT | 源端读取支持的所有字段类型 | |
| UPDATE | before:支持的所有字段 after:支持的所有字段 | ||
| UPSERT | before:支持的所有字段 after:支持的所有字段 | ||
| DELETE | before:支持的所有字段 after:null |
写入
| 写入策略 | 写入SQL语法 | 限制 |
|---|---|---|
| INSERT | INSERT %s INTO %s (%s) VALUES (%s) | 无 |
| UPDATE | UPDATE %s SET %s WHERE %s | 无 |
| DELETE | DELETE FROM %s WHERE (%s) in (%s) | 无 |
| MERGE | MERGE INTO %s D USING %s S ON (%s) WHEN NOT MATCHED " + "THEN INSERT (%s) VALUES (%s) %s | 无 |
| IGNORE | 忽略,不做写入 | 无 |
DDL
| SQL类型 | SQL示例 | 作用 | 支持解析 | 支持写入 | 备注 |
|---|---|---|---|---|---|
| Alter Table | alter table A12 change c1 c2 VARCHAR(50) default 'default_value_1' null; | 修改字段 | ✔️ | ✔️ | |
| alter\n \t table A12 add new_column int default 2 not null; | 新加字段 | ✔️ | ✔️ | 带有转义字符 | |
| alter table A12 drop column new_column26; | 删除字段 | ✔️ | ✔️ | ||
| alter table A12 modify c2 VARCHAR(51) default 'default_value_1' null; | 修改字段 | ✔️ | ✔️ | modify写法 | |
| alter table A12 rename column c1 to c11 | 修改字段 | ✔️ | ✔️ | ||
ALTER TABLE test.111jq2 MODIFY COLUMN col2 decimal(10, 6) NULL; | 修改字段 | ✔️ | ✔️ | 带有符号的表名 | |
| ALTER TABLE A12 RENAME TO C12; | 重命名表 | ✔️ | ✔️ | 大写处理 | |
ALTER TABLE test.111jr MODIFY COLUMN username varchar(50) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci NULL | 修改字段 | ✔️ | ✔️ | 复杂的带有符号包裹的表名 | |
| ALTER TABLE A12 ADD COLUMN (C10 INT GENERATED ALWAYS AS (id + 1) STORED) | 修改字段 | ✔️ | ✔️ | 带有函数的Alter语句 | |
| / ApplicationName=DataGrip 2021.3.1 / alter table suhj.A12 add new_column113 int | 修改字段 | ✔️ | ✔️ | 带有注释的语句 | |
| Create Table | create table A12123(column_1 int null); | 创建表 | ✔️ | ✔️ | |
| create table 123A12123(column_1 int null); | 创建表 | ✔️ | ✔️ | 创建表带有多个空格 | |
| create table "start_A12" ( column_1 int, column_2 int ) | 创建表 | ✔️ | ✔️ | 带有转义符号的建表语句 | |
plain create table "src_alltype_0_240604144318541" ( id NUMBER GENERATED BY DEFAULT ON NULL AS IDENTITY, colu1 NUMBER(10,5) null, colu3 NUMBER(5,6) null, colu4 FLOAT(126) null, colu5 FLOAT(63) null, colu6 CHAR(2000) null, colu7 VARCHAR2(3000) null, colu8 NCHAR(1000) null, colu9 NVARCHAR2(2000) null, colu10 DATE null, colu11 CLOB null, colu13 CLOB null, colu14 BINARY_DOUBLE null, colu15 BINARY_FLOAT null, colu16 VARCHAR2(1000) null, colu17 CHAR(500) null, colu18 VARCHAR2(1000) null, colu19 NUMBER null, colu20 FLOAT(126) null, colu22 NCHAR(1) null, colu23 NVARCHAR2(1000) null, colu24 NVARCHAR2(1000) null, colu25 NUMBER null, colu26 FLOAT(63) null, colu27 NUMBER null, colu28 TIMESTAMP (9) null, colu29 TIMESTAMP (6) WITH LOCAL TIME ZONE null, colu30 TIMESTAMP (6) WITH TIME ZONE null, colu31 NCHAR(1000) null, colu32 NVARCHAR2(1000) null, colu33 NUMBER null, colu34 NUMBER null, colu36 BLOB null, test VARCHAR2(110) null, time DATE default SYSDATE null, colu37 INTERVAL HOUR TO MINUTE, colu21 INTERVAL DAY (2) TO SECOND (9) null, colu35 RAW(2000) null, constraint src_alltype_0_240604144318541_pk primary key (id) ) | 创建表 | ✔️ | ✔️ | 复杂的超长的建表语句 | |
| Truncate | truncate table A12; | 截断表 | ✔️ | ✔️ | |
| truncate A12; | 截断表 | ✔️ | ✔️ | 截断表(不带 table关键字) | |
| truncate table suhj. A12; | 截断表 | ✔️ | ✔️ | 截断表(带有多个空格) | |
truncate table suhj.asss23; | 截断表 | ✔️ | ✔️ | 带有符号包裹的表名 | |
| Rename Table | RENAME TABLE suhi .cs12 TO suhj.A12 | 重命名表 | ✔️ | ❌ | 带有空格的重命名表 |
| rename table A12 to A12_temp | 重命名表 | ✔️ | ❌ | 带有字符串重复的表名 | |
| RENAME A12_temp TO A12 | 重命名表 | ✔️ | ❌ | 大写的带有字段重复的表名 |
OceanBase 高可用配置
配置前提
创建 HA 组前,应先完成全部逻辑集群、租户和 Agent 配置,并满足以下约束:
- 一个 HA 组至少包含两个逻辑集群;
- 只能选择尚未加入其他 HA 组的单机集群;
- HA 集群之间的租户数量必须一致;
- 对应租户的兼容模式必须一致;
- 每个租户必须存在一一对应关系;
- 同一 HA 组中不允许一部分租户参与 HA、另一部分租户独立运行。
配置 HA 组
- 单击 高可用配置。
- 输入 HA 配置名称。
- 选择至少两个逻辑集群。
- 调整集群顺序,列表首位优先级最高。
- 进入租户关系确认步骤。
- 核对各集群的租户数量和类型。
- 通过拖拽调整租户卡片顺序,建立一一对应关系。
- 确认并保存。
系统优先按租户名称自动匹配;名称不一致时会结合租户类型和配置顺序生成候选对应关系。自动匹配结果仍需人工确认。
HA 展示与 Agent 激活
HA 组以独立模块展示,包含:
- HA 配置名称;
- 各逻辑集群及优先级;
- 当前活动集群;
- 集群下租户及关联任务;
- HA 组整体采集代理状态;
- 编辑、切换、删除以及展开/收起操作。
HA 模块内的 Agent 依旧以集群为单位去执行激活操作。
手动切换
- 在 HA 组中单击切换。
- 选择目标逻辑集群。
- 查看本次切换影响的任务范围。
- 确认后执行切换。
- 查看执行日志并等待切换完成。
- 刷新节点详情,确认活动集群和 Agent 标识已更新。
若切换时出现启动 obcdc 超时,测试报告指出该状态判断不一定会中断切换流程;仍应等待流程结束,并通过 Agent 状态、任务状态和日志确认实际结果。手动切换日志可能延迟显示。
注意事项
数据节点与数据链路中获取到的元数据信息均由 OceanBase JDBC 连接配置中的用户与密码获得,JDBC 连接配置中的用户与 OB_Log_Reader 中配置的用户权限可能不同,会导致缺少您需要同步的数据表或在 OB_Log_Reader 中选择同步列表失败,针对如上情况,您需要:
- 检查 JDBC 连接配置中的用户与 OB_Log_Reader 中配置的用户权限
- 修改权限后在 OB_Log_Reader 选表弹窗内刷新元数据
- 选择需要的数据表并保存
OB_Log_Reader 作为一个独立的日志采集组件,可以独立部署于 DataPipeline 集群之外,或随 DataPipeline 集群部署,详情参见《DataPipeline 部署安装指南》中章节: 3.7 安装 OB_Log_Reader