版本说明
- 数据源 JDBC 模式支持 PostgreSQL 9.4.26、9.5.25、9.6.24、10.23、11.22、12.20、13.23、14.20、16.10版本;
- 数据源 wal2json 模式支持 PostgreSQL 9.4.26、9.5.25、9.6.24、10.23、11.22、12.20、13.23、14.20、16.10 版本,不支持 PostgreSQL 只读库;
- 数据源 PostgreSQL WAL Agent 模式支持 PostgreSQL 9.4.26、9.5.25、9.6.24、10.23、11.22、12.20、13.23、14.20、16.10 版本,不支持 PostgreSQL 只读库;
- 目的地 JDBC 写入模式支持 9.4.26、9.5.25、9.6.24、10.23、11.22、12.20、13.23、14.20、16.10 版本
读取方式
| 读取方式 | 场景 | 权限要求 | 对应功能 |
|---|---|---|---|
| JDBC | 批量同步场景,全量初始化 | 1、赋予查询权限: GRANT SELECT ON dp_schema.dp_src_table to dp_heh; 2、赋予schema的使用权限: GRANT USAGE ON SCHEMA dp_schema TO dp_heh; | 1、选表,读取数据 2、任务运行,读取权限 |
| Wal2json | 增量监听场景 | 1、赋予复制权限(wal2json读取):ALTER USER dp_heh REPLICATION; 2、赋予schema的使用权限: GRANT USAGE ON SCHEMA dp_schema TO dp_heh; 3、同步表的查询权限 GRANT SELECT ON dp_schema.dp_src_table to dp_heh; | 1、wal2json 增量读取 2、任务运行,读取权限 |
| pgoutput | 增量监听场景 | 1)赋予复制权限 ALTER USER 用户名 REPLICATION; 2)publication需要权限 GRANT CREATE ON database 数据库名 to 用户名;3)必须是增量监听表的owner权限 | 1、pgoutput增量读取 2、任务运行,读取权限 |
| PostgreSQL WAL Agent | 增量监听场景 | 1. NOSUPERUSER + REPLICATION,可登录并连接目标库 2. 从 Agent 地址认证,执行 IDENTIFY_SYSTEM 并读取所需连续物理 WAL 3. 查询 pg_control_system()、pg_control_checkpoint()、pg_roles、pg_database、系统目录、pg_locks 及初始化需要的事务/主备/WAL 信息。 4. 目标 schema 的 USAGE、所选表的 SELECT,以及目标数据库 CONNECT。 5. full_page_writes 开启且 checkpoint/WAL 证据有效;所需原生日志连续且保留充分。这些是数据库运行条件,不是账号提权要求。未知格式、缺页/缺日志和不一致证据应阻断。 | 1. 物理日志采集 2. 支持全量与增量衔接 3. 任务起点配置及故障续传等关键能力 4. 完整支持已有的 DML与DDL读取,确保数据变更与结构变更均可正常捕获同步 |
物理复制槽、WAL 保留与 Agent checkpoint 相关说明
一句话理解
物理复制槽是源库侧可选的 WAL 保留手段,用来降低 Agent 断线、停机或落后时所需 WAL 被过早清理的风险;它不是物理解析的必要条件,也不能替代 Agent 自己的 checkpoint、本地 WAL spool 和恢复状态。
Agent 自行解析原始 WAL、页、目录和事务,不依赖
pgoutput、wal2json或每任务逻辑复制槽。说明:原生 PostgreSQL 物理取流命令允许省略
SLOT,例如START_REPLICATION PHYSICAL <LSN> TIMELINE <timeline>或START_REPLICATION SLOT <slot_name> PHYSICAL <LSN> TIMELINE <timeline>。这些写法仅用于说明原生 PG 协议;GaussDB/openGauss、TDSQL、GBase8c 等商业内核须由对应客户端适配器生成命令,不能手工套用同一语法。
复制槽、本地 spool 与 checkpoint 的职责分工
| 组件 | 作用 | 不能替代什么 |
|---|---|---|
| 源库物理复制槽 | 在源库维护 WAL 保留进度。restart_lsn表示仍可能被消费者需要的最早 WAL 位置。 | 不保存 Agent 的页面底稿、历史结构、活动事务、outbox 或 Kafka 投递确认;不能当作任务消费 offset 或完整 Agent 恢复点。 |
| Agent 本地 WAL spool | 保存已接收并可靠落盘的原始 WAL,供本地连续重放。 | 不能接收 Agent 停机期间尚未传来的 WAL,不能代替源端保留。 |
| Agent checkpoint 与本地持久状态 | 保存源身份、timeline、精确记录起止位置、解析所需页和目录状态、未完成事务,以及输出与确认状态;分布式场景还保存各 DN 位置向量及协调状态。 | 不要求源库自动替 Agent 保留全部需要的 WAL。 |
| 源数据库自己的 CHECKPOINT | 数据库刷页及崩溃恢复所需,也是建立初始 WAL 恢复边界的证据之一。 | 不是 Agent 的解析与业务投递 checkpoint。 |
需要注意:pg_replication_slots 中物理槽的 confirmed_flush_lsn 为空,该字段属于逻辑槽;不能用逻辑槽字段判断物理 Agent 是否处理完成。
使用与不使用物理复制槽的取舍
| 对比项 | 不使用物理复制槽 | 使用物理复制槽 |
|---|---|---|
| 断线期间 WAL | 依赖源库日志保留窗口,或 Agent 可访问、可识别的归档;超出窗口可能缺失日志。 | 按槽进度保留仍需接收的 WAL,增强断线和落后后的续读保障,但仍受实际保留上限约束。 |
| 源库磁盘 | 没有该 Agent 的槽持续钉住旧 WAL;仍有正常 WAL、归档等空间开销。 | Agent 长期落后、停机或槽遗留时,可能持续占用 pg_wal。 |
| 运维 | 需要规划中断和追赶期间的日志覆盖范围。 | 还需管理槽的监控、保留上限、生命周期,以及数据库切换后的可用性。 |
| Agent 本地恢复 | 仍要保存 checkpoint、spool 和恢复依赖。 | 同样要保存;槽不会替 Agent 保存解析或投递状态。 |
| 能解决什么 | 不引入槽占用;适合日志保留窗口可控、断线时间可控的场景。 | 降低源库过早回收所需 WAL 的风险。 |
| 不能解决什么 | 超出日志保留窗口后仍可能无法续读。 | 不能保证任意时长断线都能续传,不能替代本地状态,不能恢复已被回收的历史 WAL。 |
PostgreSQL 的 wal_keep_size、归档和复制槽都可参与日志保留,但保障方式不同。max_slot_wal_keep_size 可以限制槽造成的 WAL 保留量;达到限制后,所需日志仍可能被清理。因此不能同时承诺“磁盘严格有界”和“任意时长断线均可续传”。
如何选择
- 不使用复制槽:适用于源库日志保留窗口和归档可覆盖预期断线时长、运维可接受日志缺口风险的场景。必须监控日志保留覆盖范围。
- 使用复制槽:适用于希望增强断线、停机、落后后的续读保障的场景。必须同时监控槽状态、
restart_lsn、WAL 保留量和生命周期。 - 无论是否使用复制槽:Agent 都必须保存 checkpoint、本地 WAL spool 和恢复依赖。复制槽只影响源端 WAL 保留,不影响 Agent 本地解析与投递状态的完整性。
示例:Agent 在某位置停止后,源库继续产生 WAL。如果重启所需区间既不在本地 spool,也已不在源库或可读取归档中,即使 checkpoint 完整也不能续读。此时应保留恢复状态并报告日志缺口,不能静默跳到 latest。后来新建物理槽也不能恢复已经被回收的历史 WAL。
写入方式
| 写入方式 | 场景 | 权限要求 | 对应功能说明 |
|---|---|---|---|
| JDBC | 写入 | 1、赋予在该schema下创建表的权限: GRANT CREATE ON SCHEMA dp_schema TO dp_heh; 2、赋予schema的使用权限: GRANT USAGE ON SCHEMA dp_schema TO dp_heh; 3、赋予写入权限: GRANT SELECT,INSERT,UPDATE,DELETE ON dp_schema.dp_sink_table to dp_heh; 4、赋予清空权限: GRANT TRUNCATE ON dp_schema.dp_sink_table to dp_heh; 5、修改表的owner ALTER TABLE dp_schema.dp_sink_table OWNER TO dp_heh; | 1、创建表 2、任务运行,读取写入权限 3、选表,写入数据 4、清空目的地表 5、删除重建表,结构变化 |
节点特性
数据类型
| 序号 | 官网支持类型 | DP定义的类型 | 作为源支持情况 | 作为目的地支持情况 |
|---|---|---|---|---|
| 1 | bigserial | BIGSERIAL | ✔️ | ❌ |
| 2 | smallint | INT2 | ✔️ | ✔️ |
| 3 | int2vector | INT2VECTOR | ✔️ | ❌ |
| 4 | integer | INT4 | ✔️ | ✔️ |
| 5 | int4range | INT4RANGE | ✔️ | ❌ |
| 6 | bigint | INT8 | ✔️ | ✔️ |
| 7 | int8range | INT8RANGE | ✔️ | ❌ |
| 8 | money | MONEY | ✔️ | ❌ |
| 9 | name | NAME | ✔️ | ❌ |
| 10 | numeric [ (_p_, _s_) ] | NUMERIC | ✔️ | ✔️ |
| 11 | numrange | NUMRANGE | ✔️ | ❌ |
| 12 | text | TEXT | ✔️ | ✔️ |
| 13 | time [ (_p_) ] [ without time zone ] | TIME | ✔️ | ✔️ |
| 14 | timestamp [ (_p_) ] [ without time zone ] | TIMESTAMP | ✔️ | ✔️ |
| 15 | time [ (_p_) ] with time zone | TIMETZ | ✔️ | ✔️ |
| 16 | timestamp [ (_p_) ] with time zone | TIMESTAMPTZ | ✔️ | ✔️ |
| 17 | uuid | UUID | ✔️ | ❌ |
| 18 | character varying [ (_n_) ] | VARCHAR | ✔️ | ✔️ |
| 19 | xml | xml | ✔️ | ❌ |
| 20 | bit [ (_n_) ] | BIT | ✔️ | ❌ |
| 21 | boolean | BOOL | ✔️ | ✔️ |
| 22 | bytea | BYTEA | ✔️ | ✔️ |
| 23 | character [ (_n_) ] | BPCHAR | ✔️ | ✔️ |
| 24 | date | DATE | ✔️ | ✔️ |
| 25 | daterange | DATERANGE | ✔️ | ❌ |
| 26 | real | FLOAT4 | ✔️ | ✔️ |
| 27 | double precision | FLOAT8 | ✔️ | ✔️ |
| 28 | json | JSON | ✔️ | ❌ |
| 29 | jsonb | JSONB | ✔️ | ❌ |
| 30 | line | LINE | ✔️ | ❌ |
| 31 | lseg | LSEG | ✔️ | ❌ |
| 32 | oid | OID | ✔️ | ❌ |
| 33 | oidvector | OIDVECTOR | ✔️ | ❌ |
| 34 | path | PATH | ✔️ | ❌ |
| 35 | pg_lsn | PG_LSN | ✔️ | ❌ |
| 36 | pg_node_tree | PG_NODE_TREE | ✔️ | ❌ |
| 37 | point | POINT | ✔️ | ❌ |
| 38 | polygon | POLYGON | ✔️ | ❌ |
| 39 | refcursor | REFCURSOR | ✔️ | ❌ |
| 40 | regclass | REGCLASS | ✔️ | ❌ |
| 41 | regconfig | REGCONFIG | ✔️ | ❌ |
| 42 | regdictionary | REGDICTIONARY | ✔️ | ❌ |
| 43 | regnamespace | REGNAMESPACE | ✔️ | ❌ |
| 44 | regoper | REGOPER | ✔️ | ❌ |
| 45 | macaddr | MACADDR | ✔️ | ❌ |
| 46 | regoperator | REGOPERATOR | ✔️ | ❌ |
| 47 | regproc | REGPROC | ✔️ | ❌ |
| 48 | regprocedure | REGPROCEDURE | ✔️ | ❌ |
| 49 | regrole | REGROLE | ✔️ | ❌ |
| 50 | regtype | REGTYPE | ✔️ | ❌ |
| 51 | RELTIME | ✔️ | ❌ | |
| 52 | SMGR | ✔️ | ❌ | |
| 53 | tid | TID | ✔️ | ❌ |
| 54 | TINTERVAL | ✔️ | ❌ | |
| 55 | interval [ _fields_] [ (_p_) ] | INTERVAL | ✔️ | ❌ |
| 56 | cidr | CIDR | ✔️ | ❌ |
| 57 | inet | INET | ✔️ | ❌ |
| 58 | tsquery | TSQUERY | ✔️ | ❌ |
| 59 | tsrange | TSRANGE | ✔️ | ❌ |
| 60 | tstzrange | TSTZRANGE | ✔️ | ❌ |
| 61 | tsvector | TSVECTOR | ✔️ | ❌ |
| 62 | bit varying [ (_n_) ] | VARBIT | ✔️ | ✔️ |
| 63 | txid_snapshot | TXID_SNAPSHOT | ✔️ | ❌ |
| 64 | UNKNOWN | ✔️ | ❌ | |
| 65 | ABSTIME | ✔️ | ❌ | |
| 66 | aclitem | ACLITEM | ✔️ | ❌ |
| 67 | box | BOX | ✔️ | ❌ |
| 68 | cid | CID | ✔️ | ❌ |
| 69 | xid | XID | ✔️ | ❌ |
| 70 | gtsvector | GTSVECTOR | ✔️ | ❌ |
| 71 | circle | CIRCLE | ✔️ | ❌ |
| 72 | float4 | REAL | ✔️ | ✔️ |
| 73 | bpchar | CHARACTER | ✔️ | ✔️ |
| 74 | GEOMETRY | ✔️ | ❌ | |
| 75 | character varying [ (_n_) ] | CHARACTER VARYING | ✔️ | ❌ |
| 76 | vector | vector | ✔️ | ✔️ |
说明:由于pg类型的数据库较为灵活,因此有部分字段类型官网没有,但是通过JDBC驱动查询时,可以查询出来。因此DP支持的字段类型会有部分在官网上没有更新。
DML
读取
| 读取模式 | DML识别 | 捕获信息 | 限制 |
|---|---|---|---|
| JDBC | INSERT | 源端读取支持的所有字段类型 | 【限制】不支持列筛选 |
| 逻辑复制 | INSERT | 源端读取支持的所有字段类型 | 【限制】1、不支持列筛选 【限制】2、无法捕获到TOAST字段 在 PostgreSQL 中, toast 其实是 PostgreSQL 用来存储大数据字段的机制。TOAST 是 PostgreSQL 在存储大型字段(如 TEXT、BYTEA 和 JSONB 等大对象)时的一种技术,允许将过大的数据分割为块并压缩,以便更高效地存储和访问。简单来说,TOAST 字段就是超过某个阈值的字段数据,它们在数据库内部经过分块和压缩处理【限制】3、无主键的表,捕获不到D类型的记录;U类型捕获只有after有值,before都是null(有些时候U也捕获不到,是复制槽的限制,可以消费复制槽验证) 想要捕获全部信息,需要REPLICA IDENTITY属性设置为FULL(同样适用于有主键表想捕获全部列) -- 查级别,查出来的可能是缩写,只有首字母 SELECT n.nspname,c.relname,relreplident FROM pg_catalog.pg_class c LEFT JOIN pg_catalog.pg_namespace n ON c.relnamespace=n.oid where c.relname = 'heh_0714' -- 修改级别 ALTER TABLE heh_0714 REPLICA IDENTITY FULL 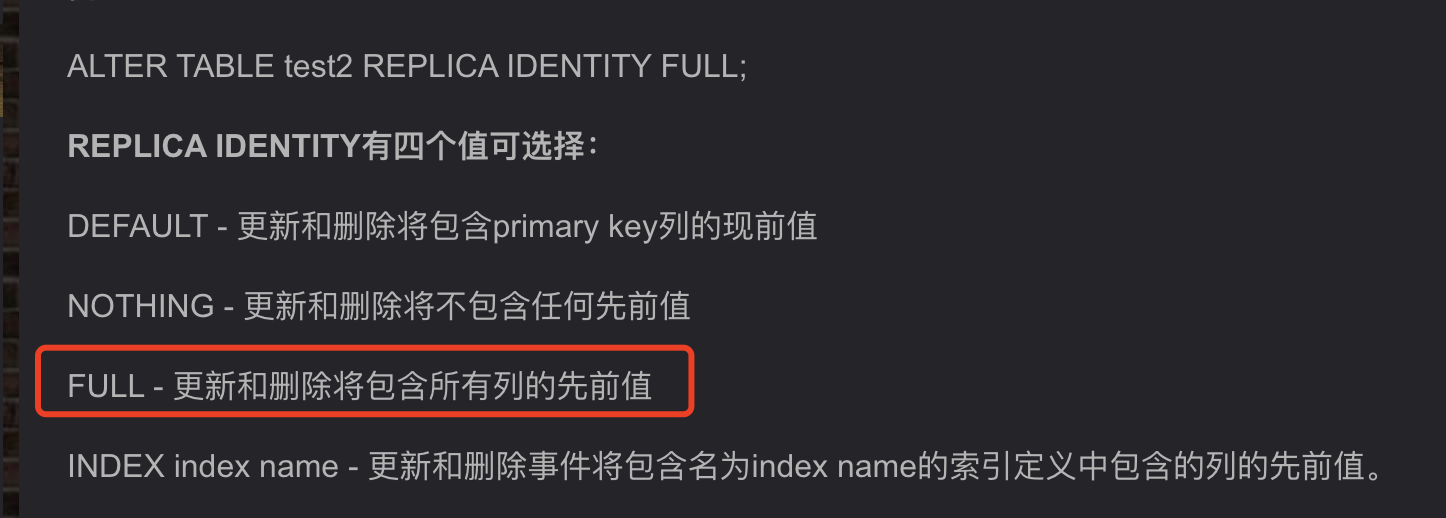 |
| UPDATE | before:主键(可通过配置捕获全部字段) after:支持的所有字段 | ||
| DELETE | before:主键(可通过配置捕获全部字段) after:null |
写入
| 写入策略 | 写入SQL语法 | 限制 |
|---|---|---|
| INSERT | INSERT INTO 。。。 VALUES 。。。 | |
| UPDATE | UPDATE。。。 SET。。。 WHERE 。。。 | 需要在目的地指定逻辑主键,如果未指定逻辑主键,会使用映射上配置的主键作为逻辑主键。 【限制】当源端采集不完整,目的主键列 源端采集不到,会存在最终数据不一致情况,因为拿null去更新数据(不是因为真实值为null,是因为采集不完整) 当更新条件中存在值为null时,会做特殊处理。 更新条件的字段为空:update 表名 set 字段 value where 更新条件 is null; 更新条件的字段为空:update 表名 set 字段 value where 更新条件 in value; 示例: plain UPDATE "postgres"."public"."t1" SET "col1"=?,"col2"=? WHERE "id1" IS NULL AND "id"=? |
| DELETE | set enable_indexscan = on; set enable_seqscan = off; DELETE FROM。。。 WHERE 。。。 | 需要在目的地指定逻辑主键,如果未指定逻辑主键,会使用映射上配置的主键作为逻辑主键。 原因同上: 当更新条件中存在值为null时,会做特殊处理。 1. 更新条件的字段为空:delete from 表名 where 更新条件 is null; 2. 更新条件的字段不为空:delete from 表名 where 更新条件的字段 in (value); plain DELETE FROM "postgres"."public"."t1" WHERE "id1" IS NULL AND ("id") in (('1')) |
| MERGE | pg 9.4: delete+ insert | 需要在目的地指定逻辑主键,如果未指定逻辑主键,会使用映射上配置的主键作为逻辑主键。 |
| 其他版本+ 部分更新(oracle未开启补全),update | ||
| 其他版本 1)逻辑主键变更: delete+ insert 2)非逻辑主键变更: INSERT INTO 。。。VALUES 。。。 ON CONFLICT 。。。 DO UPDATE SET。。。 | ||
| IGNORE |
DDL
读取
由于解析是通过pgoutput/wal2json,而pgoutput/wal2json中没有DDL信息,因此,实际上DDL是靠结构比对捕获的,因此,需要增量数据触发diff,才能获取到DDL的事件。因此也无法处理连续DDL场景,会根据结构比对产生
| DDL类型 | 读取方式 | 是否支持获取 | 上游触发场景 | 支持处理的内容 |
|---|---|---|---|---|
| add column | pgoutput/wal2json / JDBC | ✔️ | 1. 源端加列 2. 源端rename列–rename后的列识别为新增列 【限制】不支持移位DDL,即不支持after,first等 | 名称、类型、精度、标度、默认值、注释、not null |
| drop column | pgoutput/wal2json / JDBC | ✔️ | 1. 源端加列 2. 源端rename列–rename后的列识别为新增列 | |
| modify column | pgoutput/wal2json / JDBC | ✔️ | 源端修改类型,精度,标度 | 类型、精度、标度、默认值、注释、not null |
| rename column | pgoutput/wal2json / JDBC | ❌ | 【限制】不支持,会识别为删除列+新增列(风险❗️) | |
| drop table | pgoutput/wal2json | ❌ | 不支持 | 如果在同步时,发生了删表的情况。可以手动暂停任务删掉该映射即可。 如果不删除,未来加入源端有了一张新的同名表,会订阅该表的信息,假如schema不同,会触发结构变化。 |
| JDBC | ✔️ | 源表被删除或者源表被rename 【说明】当JDBC读取的时候,会检测到待同步的表不存在。 | ||
| truncate table | wal2json / JDBC | ❌ | 不支持 | |
| pgoutput | ✔️ | 支持 | ||
| create table | pgoutput/wal2json | ❌ | 不支持 | |
| JDBC | ❌ | 当前不支持 | ||
| rename table | pgoutput/wal2json | ❌ | 不支持 | |
| JDBC | ❌ | 不支持,会被识别为drop table |
写入
| DDL类型 | 是否支持 | 限制 |
|---|---|---|
| truncate table | ✔️ | |
| drop table | ✔️ | |
| truncate partition | ❌ | |
| drop partition | ❌ | |
| add column | ✔️ | 【限制】不支持移位DDL,即不支持after,first等 |
| drop column | ✔️ | |
| modify column | ✔️ | 【限制】1、其他未支持的属性,结构变化后映射可能会有diff 【限制】2、修改列的数据类型,并且新类型与旧类型不兼容时,需要使用 USING 子句,此种场景暂不支持 |
| rename column | ✔️ | 【限制】其他未支持的属性,结构变化后映射可能会有diff |
索引
PostgreSQL 当前支持在创建目的表时,可以创建索引,目前支持的索引类型及配置
| 索引类型 | 索引存储方式 | 排序 |
|---|---|---|
| 普通索引 | Hash 、Btree | 支持配置 |
| 唯一索引 | Btree | 支持配置 |
| 主键索引 | Btree | 不支持配置,默认为升序 |
添加 PostgreSQL 节点操作步骤
新建弹窗界面选择了 PostgreSQL 节点类型之后,显示 PostgreSQL 的基本信息配置模板:
- 版本:选择版本
- 服务器地址:输入连接数据节点的域名或 IP 地址。例如 192.168.2.11 或datapipeline.com
- 端口:输入连接数据节点的端口值
- 数据库名称:要求连接数据库的名称
- Schema 目录:要求输入数据节点读取目录地址
- 选项一:public(默认)
- 选项二:用户可输入自定义选项
- 允许输入多个 Schema,多个 Schema 可用英文逗号分隔
- 用户名和密码:输入可访问该数据节点的用户名和密码
其他说明,PostgreSQL当前产品支持了两种节点类型, 一种是PostgreSQL,一种是PostgreSQL(新),两者的区别在于对于DDL的处理,第一种是依赖于Debezium的实现机制,这种机制主要在目的地端触发并处理。而PostgreSQL(新),则采用事件消息模型,在源端进行处理,并产生对应的事件,由下游根据策略配置,执行动作,这种模型会更好的处理快速的DDL的事件。
节点限制:
wal2json的实现机制,是开启了复制槽后,会定期的flush lsn ,通知数据库,这一批已经处理完了。这个时候,数据库会根据返回的信息,定期处理和回收日志,因此pg系的对于wal2json的同步方式,指定LSN的预期将很难确定,无法确认数据库回收了多少,举例,复制槽开始时是100,系统复制到了10000,这个时候可能日志回收被处理的是100-10000之间的一个值,然后如果指定了一个小于10000的数,如果启动时没有被回收则从该点继续读,如果回收了,则从最小的开始读,因此这个功能对于用户而言预期和实际有很大的偏差,对于该节点,只能提供暂停时进度,激活时间为起点,这两个起点设置,暂不支持指定起点的功能。