配置Oracle数据源
配置Oracle数据源
在进行配置之前,请务必检查您的Oracle数据源是否符合平台要求,参考如下:
| 数据源类型 | 版本要求 | 用户权限要求 | 其他要求 | ||
|---|---|---|---|---|---|
| Oracle(实时)-Logminer | LOGMINER模式下支持 ORACLE 11.2.0.4单实例非只读数据库、12C的 NON CDB单实例非只读数据库; |
| select any transaction,
logmining,
execute on dbms_logmnr_d,
execute on dbms_logmnr,
execute on dbms_flashback,
create session,
resource,
select any dictionary,
flashck any table,
execute_catalog_role,
以及相关视图和表的select权限 | | 1、提供Oracle Logminer;
2、12c以下版本不需要logmining权限;
3、日志补全至少需要开启primary key、all、unique级别的日志级别;
4、Archive LOG保留时间建议>=72小时;
5、不支持Oracle只读实例;
查看 LOGMINER配置手册 | |
| Oracle(实时)-Agent | 支持 Oracle 12c Non CDB单实例非只读数据库、 Oracle 11g单实例非只读数据库。ADG模式下,只支 持基于归档的解析(时延较大);
| create role FZS_role,
grant connect to FZS_role,
grant lock any table to FZS_role,
grant select any table to FZS_role,
grant select any dictionary to FZS_role,
grant alter system to FZS_role,
grant execute on dbms_flashback to FZS_role,
grant FZS_role to FZS | | 以上授权可在FZS配置页面上进行。数据库日志 redo log、achieve log 单个文件最大不超过4G。 | |
| Oracle(定时) | ORACLE 10G、11G、12C版本的 NON CDB数据库 | 相关视图和表的 select 权限 | | 要求需要同步的表拥有增量识别字段,用于同步增量数据。
选择的字段必须为可排序,例如数字或时间类型,推荐的字段类型一般为随数据更新而自增的字段,
如:
更新序列号 (例:SequenceID),更新时间戳 (例: UpdatedAt) | |
确认完毕后,点击「新建数据源」,选择「Oracle」进行新建操作: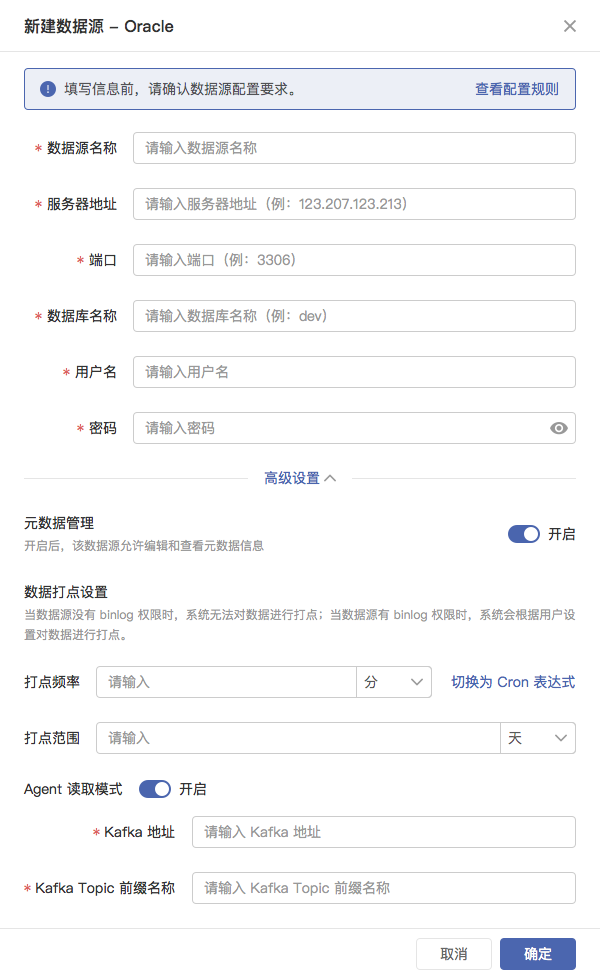
参数介绍
- 数据源名称:是该数据源在DataPipeline的唯一标识。
- 服务器地址:输入连接数据源的域名或IP地址。IP地址如192.168.2.11;域名如 data-pipeline.cye55uthbqll.cn-north-1.redshift.amazonaws.com.cn。
- 端口:输入连接数据源的端口值。
- 数据库名称:要求连接数据库的名称。
- 用户名和密码:输入可访问该数据源的用户名和密码。
注:用户在使用oracle的创建用户的时候系统会自动将用户名命名为大写。
- 高级设置
- 元数据管理:开关控制开启和关闭,默认为开启
- 开启后,该数据源允许编辑和查看元数据信息
- 数据打点设置
- 当数据源没有LogMiner权限时,系统无法对数据进行打点;当数据源有LogMiner权限时,系统会根据用户设置对数据进行打点
- 打点频率,系统会根据用户设置的打点频率对数据进行打点,用户可以设置分钟、小时频率,默认为10分钟,支持cron表达式。
- 打点范围,系统会根据用户设置的打点范围保留数据日志情况,用户可以设置小时、天,默认为3天。
- 当数据源没有LogMiner权限时,系统无法对数据进行打点;当数据源有LogMiner权限时,系统会根据用户设置对数据进行打点
- Agent读取模式
- 点击「开启」Agent读取模式后,立即显示两个输入项:Kafka地址、Kafka Topic前缀名称
- Kafka地址:代表通过Kafka获取Oracle数据源数据
- 允许只写主节点
- 允许写多个节点(主、从),若主节点访问失败,可自动切换从节点访问。
- Kafka Topic前缀:需要用户输入Topic前缀以区分不同的数据源下的同名表。
- 元数据管理:开关控制开启和关闭,默认为开启
- 点击连接后将验证数据源连接配置并同时检验数据源版本、权限等信息;
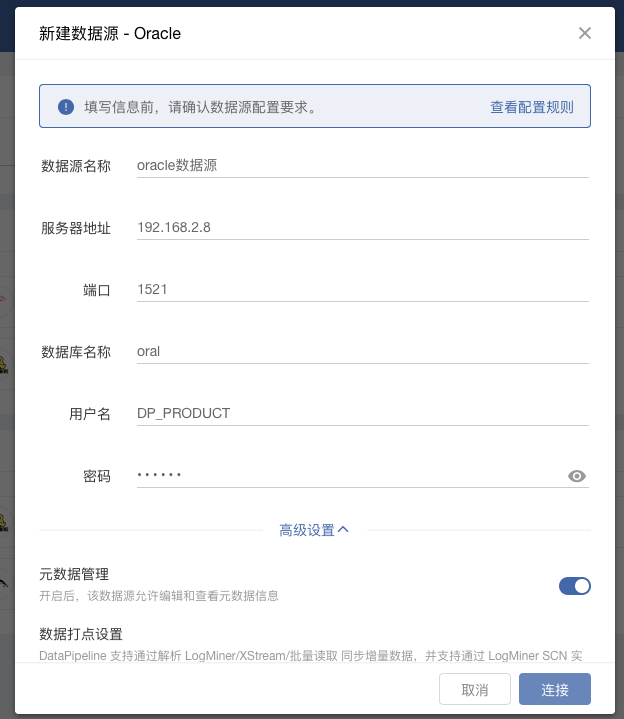
- 成功连接后将会自动打开该数据源的详情页:
- 详情页将展示该数据源的版本、权限信息以及支持的读取模式、元数据管理、打点频率和打点范围等信息;
- 点击重新连接,系统将重新按照配置内容重新连接数据源检测各个信息。

Q1:创建oracle数据源时,用户名为什么要用大写而不能用小写?
oracle用户名和密码区分大小写,创建用户时如果用户名不加双引号则会被oracle以大写的形式保存在系统的字典表中;如果创建用户名的时候在用户名上加上双引号,那么则会把双引号内的用户名直接保存在数据库字典表中。但是DataPipeline程序在使用JDBC在处理输入的用户名的时候会将Oracle小写的用户名改写成大写,oracle接收到用户名之后会以大写用户名为条件在系统的字典表中进行查找,这种时候便无法查找到用户,因此我们建议用户在使用oracle的创建用户的时候尽量将用户名命名为大写。