版本:v2.7
配置Kafka数据源
配置Kafka数据源
在进行配置之前,请务必检查您的Kafka数据源是否符合平台要求,参考如下:
| 数据源类型 | 版本要求 | 用户权限要求 | 其他要求 |
|---|---|---|---|
| Kafka数据源 | 0.10.x、0.11.x、1.x.y、2.0.x、2.1.x、2.2.x;0.9.x 只支持JSON和String格式 | 无 | 无 |
点击「新建数据源」,选择「Kafka数据源」进行新建操作:
参数介绍
- 数据源名称:是该数据源在DataPipeline的唯一标识
- 服务器地址:输入连接数据源的域名或IP地址及端口值,允许输入多个地址,使用","分隔。
- 注意:填写前需要检查kafka集群是否有别名,若有别名则需要联系DataPipeline运维人员,添加kafka别名的映射关系,并填写别名。
- ZooKeeper地址:输入连接Zookeeper的域名或IP地址及端口值,允许输入多个地址,使用","分隔。
- 数据格式: JSON(默认)、AVRO、STRING
- 当数据格式为avro时,需要用户输入 Schema Register地址
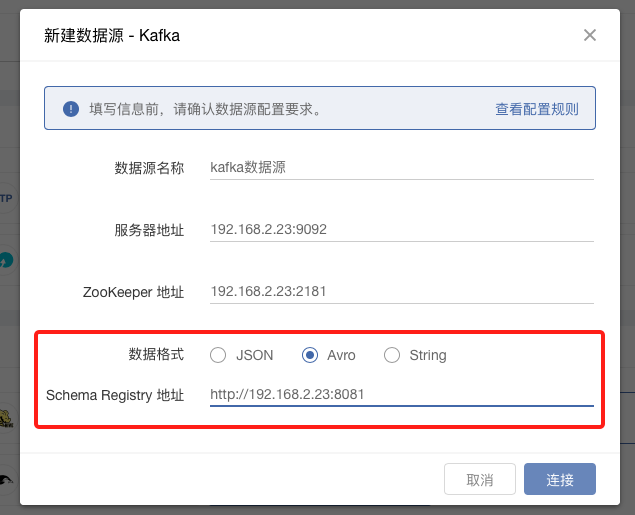
- 点击连接后将验证数据源连接配置并同时检验数据源版本、权限等信息;
- 成功连接后将会自动打开该数据源的详情页
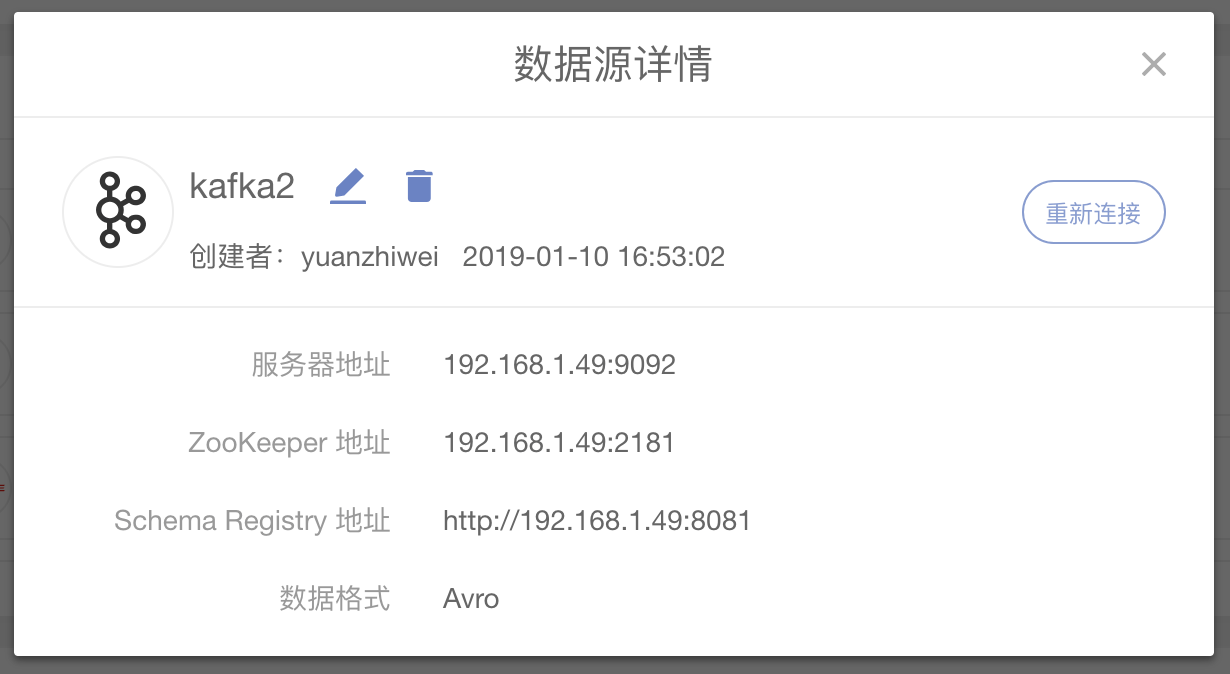
注:
- 当用户选择JSON、STRING数据格式时,必须在目的写入设置界面手动添加目的地字段和设置清洗脚本解析数据,写出映射关系,才能保证数据的正常同步。
- 点击清洗脚本,进入清洗脚本界面,可编辑Kafka队列中的record信息,并对record进行操作,按照指定的列名称和类型保存到数据库。
- 目的地字段中也需添加相应字段
- 通过解析获取到目的地字段,从而填充到目的地表结构中
- 配置完成后,可立即激活任务