版本:v2.7
配置Redshift数据目的地
配置Redshift数据目的地
在进行配置之前,请务必检查您的Redshift数据目的地是否符合平台要求,参考如下:
| 目的地类型 | 版本要求 | 用户权限要求 | 其他要求 |
|---|---|---|---|
| Redshift | 无 | 无 | 无 |
确认完毕后,点击「新建数据目的地」,选择「Redshift」进行新建操作: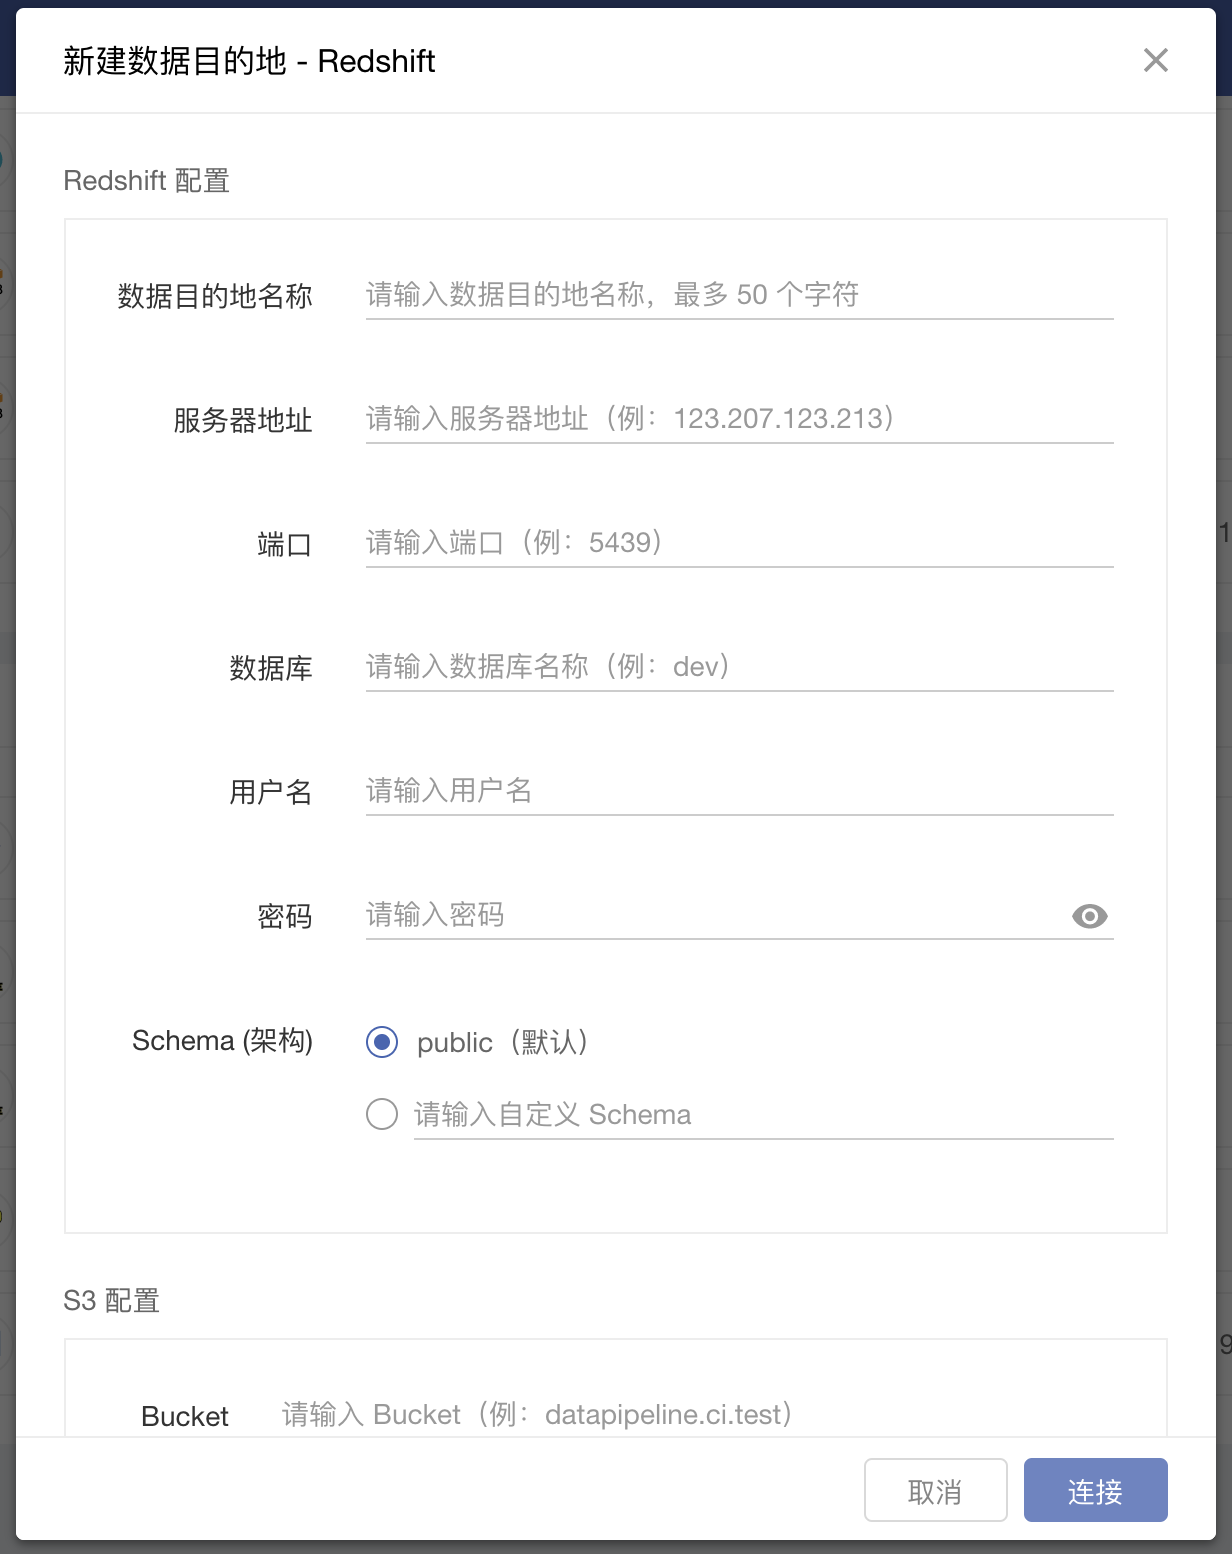
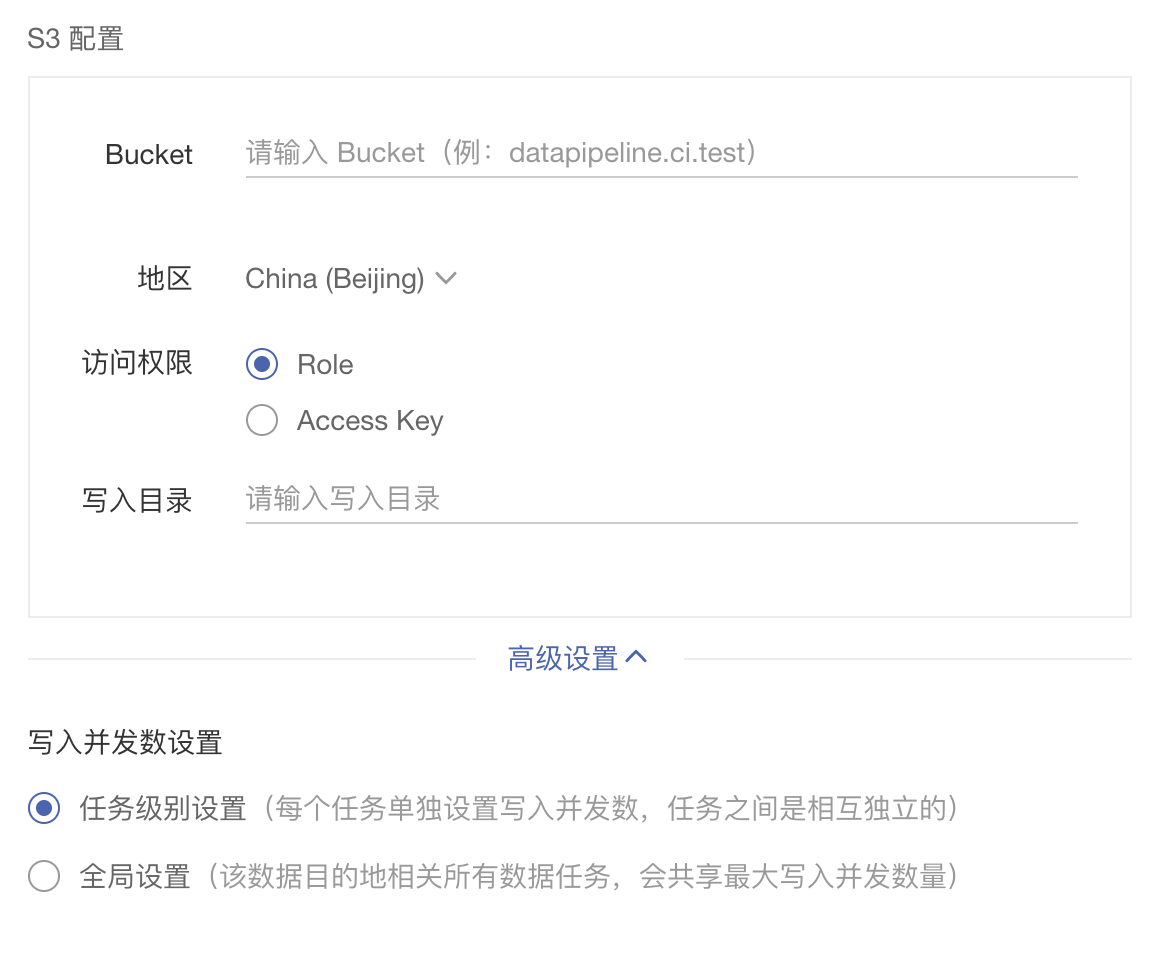
配置Redshift数据目的地需要同时配置S3。
Redshift:
- 数据目的地名称:是DataPipeline对该数据目的地的唯一标识。
- 服务器地址:输入连接数据目的地的域名或IP地址。IP地址如192.168.2.11;域名如 data-pipeline.cye55uthbqll.cn-north-1.redshift.amazonaws.com.cn。
- 端口:输入连接数据目的地的端口值。
- 数据库:要求连接数据库的名称。
- 用户名和密码:输入可访问该数据目的地的用户名和密码。
- Schema名称:要求输入目的地写入目录地址。
S3:
- Bucket:输入用户使用的Bucket。
- 地区:选择用户的S3服务器位置。
- 访问权限:您可以选择获取访问S3权限的方式,其中有
- Role:使用AWS角色委托授权以获取S3权限。
- Access Key:需要输入Access Key ID 和 Access Key。
- 写入目录:要求输入写入目录
- 写入目录允许为空。
- 高级设置
- 写入并发数设置:支持任务级别设置和全局设置两种方式
- 任务级别设置:表示每个任务单独设置写入并发数,任务之间是相互独立的。
- 全局设置(该数据目的地相关所有数据任务,会共享最大写入并发数量。
- 选择任务级别设置:需要用户在任务设置页面进行单个任务的写入并发数量设置。
- 选择全局设置:需要用户输入全局级别的写入并发数量,所有使用该数据源的任务都会共享该写入并发数量。
- 写入并发数设置:支持任务级别设置和全局设置两种方式
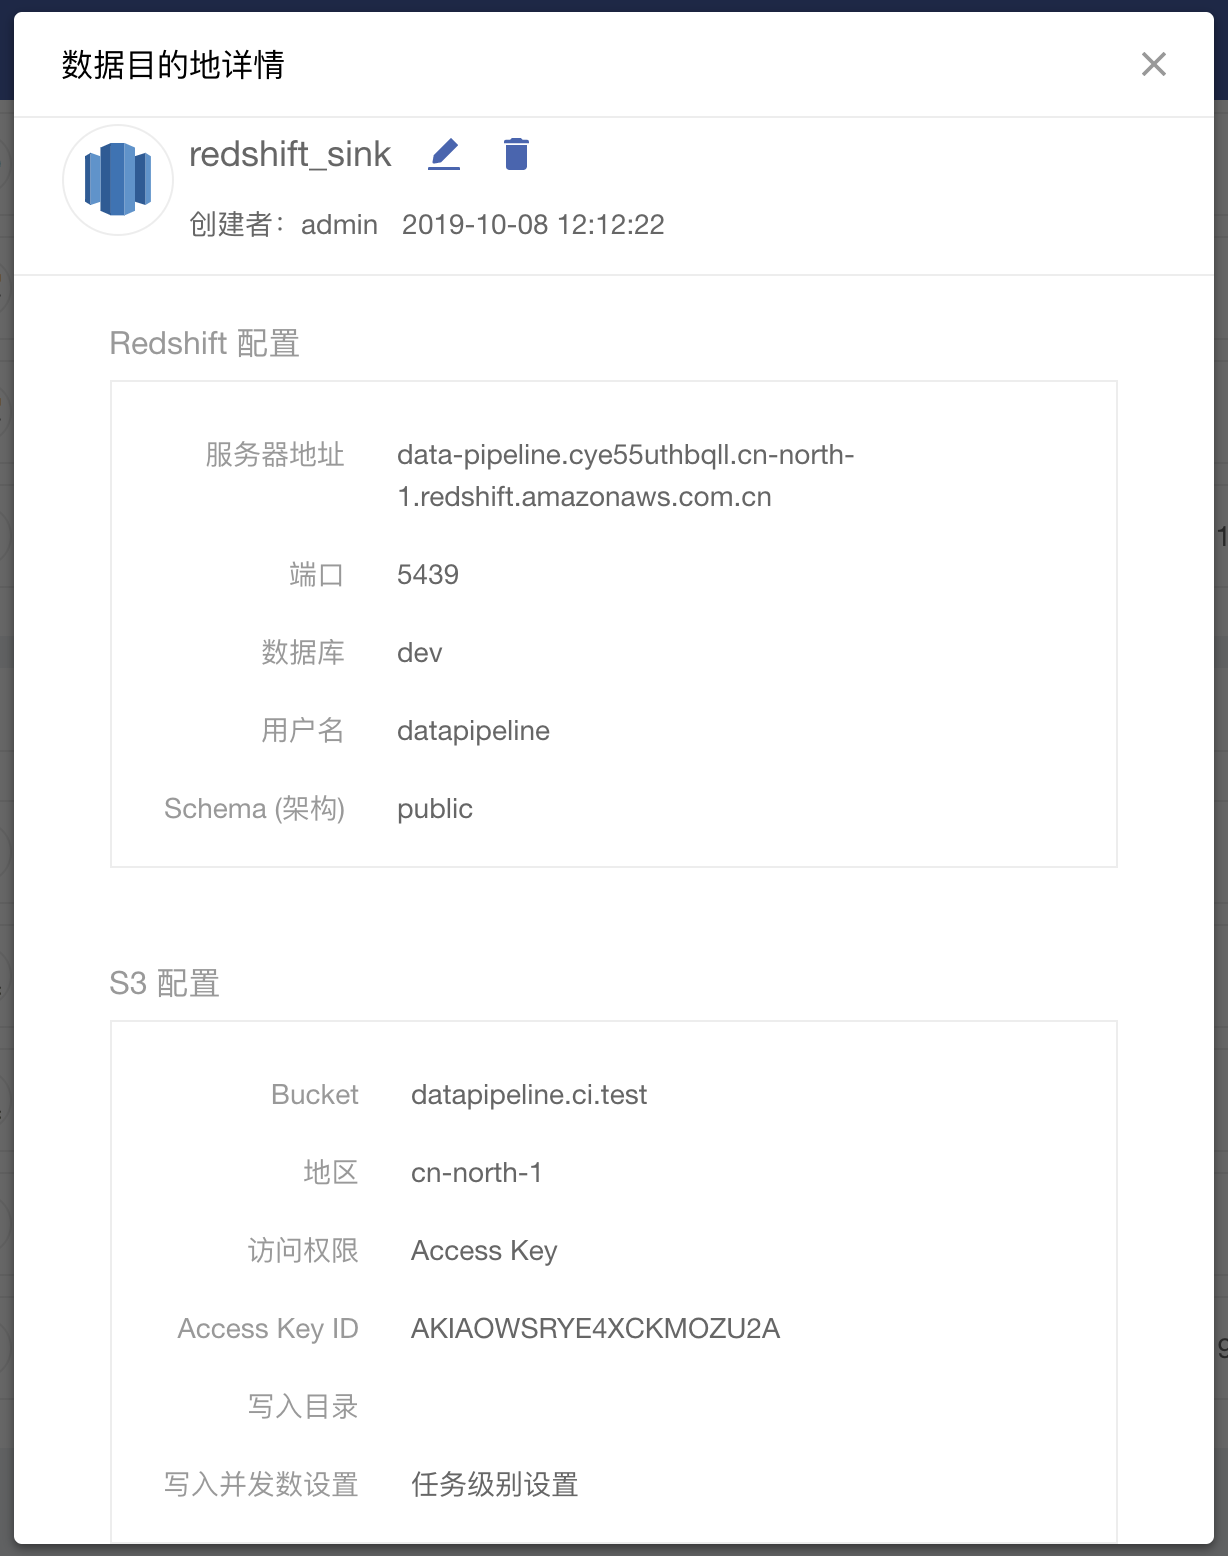
- 成功连接后将会自动打开该数据目的地的详情页。
Q1:连接RedShift为什么需要配置S3?
- 提高同步性能