版本说明
支持的 Oracle 的版本如下:
| 节点 | 版本要求 | 权限要求 | 其他要求 |
|---|---|---|---|
| 数据源节点 | + 数据源节点JDBC读取模式支持 10G、11G、12C、19C + 数据源节点采集代理读取模式支持 11G、12C、19C + LogMiner 读取模式支持 11.2.0.4、12C、19C | + CREATE SESSION、RESOURCE 以及相关表和视图的 select 权限 + 支持Logminer数据读取方式 + 支持 Datapipeline Oracle 采集代理 数据读取方式 + 12c 以下版本不需要 LOGMINING 权限 + 日志补全至少需要开启 PRIMARY KEY、ALL、UNIQUE 级别的日志级别 + Archive LOG 保留时间建议 >= 72 小时 + 授予 SELECT ON V_$SESSION 权限用于处理死锁导致的任务中断 | + 采集代理模式:支持 Oracle RAC,支持 ASM 远程读取、本地读取,支持 19C PDB,灾备架构只支持 Oracle ADG,不支持只读库 + LogMiner读取模式:不支持 Oracle RAC,不支持灾备架构从库 |
| 目的地节点 | + 数据目的地节点支持 Oracle 10G 、11G、12C、19C | select、insert、delete、create、update、alter、drop、index | + 不支持 Oracle 只读库 |
约束及限制
- Oracle 用户名和密码区分大小写,创建用户时如果用户名不加双引号会被 Oracle 以大写的形式保存在系统的字典表中;如果创建用户名的时候在用户名上加上双引号,那么则会把双引号内的用户名直接保存在数据库字典表中。DataPipeline 实时数据融合产品在使用 JDBC 处理输入的用户名时会遵循 Oracle 的处理原则将小写的用户名改写成大写,Oracle 接收到用户名之后会以大写用户名为条件在系统的字典表中进行查找,这时便无法查找到使用小写的用户名,因此我们建议用户在使用 Oracle 创建用户时使用大写用户名。
- Archive LOG 保留时间建议 >= 72 小时;
- JDBC 增量数据同步要求需要同步的表拥有增量识别字段;
- 选择的字段必须为可排序,例如数字或时间类型,推荐的字段类型一般为随数据更新而自增的字段如:更新序列号(例:SequenceID),更新时间戳(例:UpdatedAt);
- 授予 SELECT ON V_$SESSION 权限用于处理死锁导致的任务中断;
读取方式
Datapipeline 读取oracle数据库支持三种读取方式:JDBC、 Datapipeline Oracle采集代理和Logminer
特殊说明
- 采集代理其他配置详见采集代理说明文档,请联系DataPipeline技术支持获取。
JDBC 读取方式
- 要求需要同步的表拥有增量识别字段,用于同步增量数据。
- 选择的字段必须为可排序,例如数字或时间类型,推荐的字段类型一般为随数据更新而自增的字段
- 如:更新序列号 (例:SequenceID),更新时间戳 (例:UpdatedAt)
权限要求
- CREATE SESSION、RESOURCE 以及相关表和视图的 select 权限
- 支持Logminer数据读取方式
- 支持 Datapipeline Oracle 采集代理 数据读取方式
Datapipeline Oracle 采集代理读取方式
使用 Datapipeline Oracle 采集代理读取方式,redo log、achieve log 的单文件 log size 最大不超过 4G;
DP 将支持非ASM架构的远程采集。通过RFA(Remote-File-Accessor) 实现对远程文件的访问操作,配合Oracle采集代理可实现跨网段文件访问。详细配置说明请参考《Oracle agent运维手册》
权限要求
- 开启日志补全:
ALTER DATABASE FORCE LOGGING;
ALTER DATABASE ADD SUPPLEMENTAL LOG DATA;
ALTER DATABASE ADD SUPPLEMENTAL LOG DATA (ALL, PRIMARY KEY, UNIQUE) COLUMNS ; - 创建视图、用户并赋权:
CREATE OR REPLACE VIEW XKCCLE AS SELECT FROM sys.x$kccle;
CREATE OR REPLACE VIEW XKCCCP AS SELECT FROM sys.x$kcccp;
CREATE OR REPLACE VIEW DPXKSPPI AS SELECT FROM X$KSPPI;
CREATE OR REPLACE VIEW DP_XKSPPSV AS SELECT FROM X$KSPPSV;
CREATE OR REPLACE VIEW DP_KSPPCV AS SELECT * FROM X$KSPPCV;
create user agent1 identified by agent1 account unlock; --密码强度可按照要求修改。
grant CONNECT,SELECT ANY TABLE,SELECT ANY DICTIONARY to agent1;
grant select on sys.fzs_pdbs to agent1;
grant select on sys.ts$ to agent1;
grant select on sys.tabsubpart$ to agent1;
grant select on sys.obj$ to agent1;
grant select on sys.seg$ to agent1;
grant select on sys.coltype$ to agent1;
grant select on sys.xkccle to agent1;
grant select on sys.xkcccp to agent1;
grant select on sys.DP_XKSPPI to agent1;
grant select on sys.DP_XKSPPSV to agent1;
grant select on sys.DP_KSPPCV to agent1;
grant select on sys.seq$ to agent1;
grant select on sys.user$ to agent1;
grant select on sys.col$ to agent1;
grant select on sys.ind$ to agent1;
grant select on sys.tab$ to agent1;
grant select on sys.lob$ to agent1;
grant select on sys.indpart$ to agent1;
grant select on sys.lobfrag$ to agent1;
grant select on sys.user$ to agent1;
grant select on sys.source$ to agent1;
grant select on sys.view$ to agent1;
grant select on sys.ts$ to agent1;
grant select on sys.profname$ to agent1;
grant select on sys.profile$ to agent1;
grant select on sys.sysauth$ to agent1;
grant select on sys.props$ to agent1;
grant select on sys.idl_ub1$ to agent1;
grant select on sys.user$ to agent1;
grant select on sys.ntab$ to agent1;
grant select on sys.sum$ to agent1;
grant select on sys.com$ to agent1;
grant select on sys.partlob$ to agent1;
grant select on sys.attrcol$ to agent1;
grant select on sys.ccol$ to agent1;
grant select on sys.subpartcol$ to agent1;
grant select on sys.tabpart$ to agent1;
grant select on sys.indpart$ to agent1;
grant select on sys.indcompart$ to agent1;
grant select on sys.defrole$ to agent1;
grant select on sys.v$instance to agent1;
grant select on SYS.v$database to agent1;
grant select on sys.v$datafile to agent1;
grant select on sys.V$SESSION to agent1;
grant select on sys.v$log to agent1;
grant select on sys.v$logfile to agent1;
grant select on sys.gv$logfile to agent1;
3. ASM实例要求:
ASM 的用户
-- 创建用户名/密码
create user agentasm identified by agentasm;
-- ASM 用户须有 SYSDBA 角色
grant sysdba to agentasm;
采集代理运维
DataPipeline oracle 采集代理是DataPipeline 自研的在线解析 oracle 日志的工具,后简称“采集代理”。采集代理可以独立部署和运维,采集任务依托于采集代理的进程运行。\ 功能范围为 激活采集任务、暂停采集任务、重启采集进程、版本升级、版本回退、采集代理参数管理、采集代理运行日志查看。其中采集代理参数管理、采集代理运行日志查看、版本升级和版本回退四个功能只能在采集代理的 3.0.13 及以上版本使用。下面将对几个功能详细介绍。
需要注意的是,采集代理运维和监控相关的信息,只有在配置了数据任务之后才会展示详细信息,配置数据任务之前,采集代理的状态为已暂停状态。
概念介绍
- 采集代理进程
部署采集代理软件后,启动采集代理软件,采集代理进程就开始运行了,每个采集代理进程有一个 web 端口。添加或修改节点的采集代理配置页面中的端口号就是这个端口号,每个采集代理有独立的参数和运行日志。一个或多个采集代理进程可以组成一个采集代理集群。
- 采集代理任务
采集代理任务在采集代理进程中运行,集群中有多个采集代理进程时,采集代理任务同一时间点只能运行在一个采集代理进程中。正在运行采集任务的采集代理进程的状态为“运行中”;未运行采集任务的采集代理进程的状态为“已暂停”。\ 采集代理状态说明\ 在采集代理监控页面中可以看到每个采集代理的状态,采集代理有如下三种状态。
| 采集代理状态 | 采集代理进程 | 采集任务 |
|---|---|---|
| 运行中 | 运行中 | 运行中 |
| 已暂停 | 运行中 | 已暂停 |
| 故障 | 已暂停 | 已暂停 |
激活采集任务
操作入口:<数据节点><详情><节点监控><采集代理管理><激活采集任务>\ 功能说明:当所有采集代理的状态为“已暂停”时,<激活采集任务>按钮才可以点击,点击后可以选择采集任务的日志解析的起点。\ 1以上次停止时的解析进度为起点,若无则以最新的数据库日志为解析起点。\ 2指定时间点\ 3以保留的最早数据库日志为解析起点\ 4以最新的数据库日志为解析起点
暂停采集任务
操作入口:<数据节点><详情><节点监控><采集代理管理><暂停采集任务>\ 功能说明:当任意一个采集代理的状态为“运行中”时,<暂停采集任务> 按钮才可以点击,点击后会进行二次确认提示。此操作会停止采集服务请慎重操作。
重启集群所有的采集进程
操作入口:<数据节点><详情><节点监控><采集代理管理><重启采集进程>\ 功能说明:重启集群中所有的采集进程,点击后会进行二次确认提示。重启采集进程期间会中断该进程上正在进行的采集任务,请慎重操作。
版本升级
操作入口:<数据节点><详情><节点监控><采集代理管理><版本升级>\ 功能说明:将集群中的采集进程升级至指定版本\ 升级步骤如下\ 1升级版本前请 联系我们 获得匹配的版本。\ 2通过<系统设置><文件上传><软件包上传><上传>将软件包上传至DataPipeline的产品页面,上传过程中需要保证包的准确性,同时选择数据节点类型和软件包的增量或全量类型。\ 3点击 <数据节点><详情><节点监控><采集代理管理>页面的<版本升级>按钮,选择软件包,点击确认。\ 升级过程中会依次重启集群中所有的采集进程,期间会中断该进程上正在进行的采集任务,请慎重操作。如果升级失败可能会导致集群中不同采集进程因版本不一致,导致<采集代理参数管理>、<采集代理运行日志查看>、<版本升级>和<版本回退>四个功能不可用。建议升级前 联系我们 获得技术支持。
版本回退
操作入口:<数据节点><详情><节点监控><采集代理管理><版本回退>\ 功能说明:将集群中的采集进程的版本回退至上一个版本。未做过升级的采集代理集群,无法执行版本回退。\ 版本回退过程中会依次重启集群中所有的采集进程,期间会中断该进程上正在进行的采集任务,请慎重操作。
参数管理
操作入口:<数据节点><详情><节点监控><采集代理监控><采集代理名称><参数管理>\ 功能说明:每个采集代理进程有独立的参数,根据不同功能将参数划分为如下几类
- 数据输出参数
- 运行环境参数
- 资源限制参数
- 异常处理参数
- 性能相关参数
- 其他参数
根据是否需要重启生效,参数分为两类,一类参数不要重启即可生效;一类参数需要重启才能生效。可以修改多个需要重启的参数后,在“包含需要重启生效的参数,是否立即重启采集进程”的提示框中选择“否”。后续点击<数据节点><详情><节点监控><采集代理监控><采集代理>页面中的<重启采集进程>一并重启生效。
参数列表
- 数据输出参数
| 参数名 | 参数含义 | 参数值类型 | 默认值 | 值域范围 | 是否重启生效 |
|---|---|---|---|---|---|
| param.channel | 输出通道 | 列表 | kafka | file、kafka、console、null | 是 |
| kafka.bootstrap.servers | kafka配置 | 文本 | 无 | 地址+端口号参考kafka参数配置 | 是 |
| kafka.schema.registry.url | kafka配置 | 文本 | 无 | url 参考kafka参数配置 | 是 |
| kafka.acks | kafka配置 | 文本 | 无 | 数值 参考kafka参数配置 | 是 |
- 日志输出参数
| 参数名 | 参数含义 | 参数值类型 | 默认值 | 值域范围 | 是否重启生效 |
|---|---|---|---|---|---|
| logger.session.loglevel | 当前进程日志打应级别 | 列表 | info | INFO WARN ERROR DEBUG TRACE | 否 |
| param.print_cost | 打印处理耗时 | 开关 | 关闭 | 开、关 | 否 |
| param.print_objno | 打印某些 obj 的处理过程 | 文本 | 无 | 支持输入多个值,以逗号分隔 | 否 |
| param.print_level | 打印级别 | 列表 | 1 | 1、2 | 否 |
| param.print_merge | 打印整合详情 | 开关 | 关闭 | 开、关 | 否 |
| param.print_detail_cooldown_ms | 打印详情冷却时间 | 文本 | 3000 | 数值 | 否 |
| param.print_large_tx_threshold | 打印大事务大小阈值 | 文本 | 10m | 带单位,单位不区分大小写 | 否 |
| log4j.appender.console.layout.conversionPattern | log4j参数 | 文本 | 无 | 无 | 是 |
| log4j.appender.file.MaxRollFileCount | log4j参数 | 文本 | 无 | 数值 | 是 |
| log4j.appender.file | log4j参数 | 文本 | 无 | 无 | 是 |
| log4j.appender.file.Encoding | log4j参数 | 文本 | 无 | 无 | 是 |
| log4j.appender.file.MaxFileSize | log4j参数 | 文本 | 无 | 无 | 是 |
| log4j.appender.console.encoding | log4j参数 | 文本 | 无 | 无 | 是 |
| log4j.appender.console.target | log4j参数 | 文本 | 无 | 无 | 是 |
| log4j.appender.file.DatePattern | log4j参数 | 文本 | 无 | 无 | 是 |
| log4j.appender.console | log4j参数 | 文本 | 无 | 无 | 是 |
| log4j.appender.file.layout | log4j参数 | 文本 | 无 | 无 | 是 |
| log4j.appender.console.layout | log4j参数 | 文本 | 无 | 无 | 是 |
| log4j.appender.console.immediateFlush | log4j参数 | 文本 | 无 | 无 | 是 |
| log4j.appender.file.layout.ConversionPattern | log4j参数 | 文本 | 无 | 无 | 是 |
| log4j.rootLogger | log4j参数 | 文本 | 无 | 无 | 是 |
| log4j.appender.file.file | log4j参数 | 文本 | 无 | 无 | 是 |
- 运行环境参数
| 参数名 | 参数含义 | 参数值类型 | 默认值 | 值域范围 | 是否重启生效 |
|---|---|---|---|---|---|
| param.host | 本机 HOST 地址,默认取本地主机 IP 地址 | 文本 | 无 | IP地址 | 是 |
| param.port | WEB HTTP 端口 | 文本 | 无 | 端口号 | 是 |
| param.zookeeper | ZOOKEEPER 地址,当需要高可用功能时必须配置 | 文本 | 无 | 地址+端口号 | 是 |
| param.charset1 | NLS_CHARACTERSET | 列表 | 无 | utf-8、gbk、utf-16 | 是 |
| param.charset2 | NLS_NCHAR_CHARACTERSET | 列表 | 无 | utf-8、gbk、utf-16 | 是 |
| param.charset_clob | CLOB 编码 | 列表 | 无 | utf-8、gbk、utf-16 | 是 |
| jvm.opts | JVM 参数 | 文本 | 无 | 无 | 是 |
| ojdbc.path | Oracle JDBC 驱动路径 | 文本 | 无 | 无 | 是 |
- 资源看值参数
| 参数名 | 参数含义 | 参数值类型 | 默认值 | 值域范围 | 是否重启生效 |
|---|---|---|---|---|---|
| param.min_diskspace | 最小磁盘空间 | 文本 | 无 | 数值+单位,单位不区分大小写 | 否 |
- 异常处理参数
| 参数名 | 参数含义 | 参数值类型 | 默认值 | 值域范围 | 是否重启生效 |
|---|---|---|---|---|---|
| param.WorkerSpec.maxBlockingSec | 最大工作线程阻塞时间 | 文本 | 无 | 数值 | 否 |
| param.retry_backoff_ms | 发生错误后自动重启间隔 | 文本 | 无 | 数值 | 否 |
| param.recovery_mode | 当发生日志过期后的恢复模式: reset | none | 列表 | none | none、reset |
| param.auto_reset_policy | 当日志被回收时自动策略:earliest/latest/none | 列表 | none | none、reset | 否 |
| param.ignore_kafka_exception | 忽略 Kafka Producer 报错 | 开关 | 关 | 开、关 | 否 |
| param.err_files_max | 最大的错误文件缓存数量 | 文本 | 无 | 数值 | 否 |
- 性能相关参数
| 参数名 | 参数含义 | 参数值类型 | 默认值 | 值域范围 | 是否重启生效 |
|---|---|---|---|---|---|
| param.read_mb | 一次性读取大小 | 文本 | 无 | 数值 | 否 |
| param.out_mb | 一次性输出大小 | 文本 | 无 | 数值 | 否 |
| param.read_parallelism | 读取并发数 | 文本 | 无 | 数值 | 是 |
| param.deal_parallelism | 解析并发数 | 文本 | 无 | 数值 | 是 |
| param.conv_parallelism | 转换并发数 | 文本 | 无 | 数值 | 是 |
| param.read_byte_rate | 读取限速 | 文本 | 无 | 数值 | 否 |
| param.deal_byte_rate | 解析限速 | 文本 | 无 | 数值 | 否 |
| param.conv_byte_rate | 转换限速 | 文本 | 无 | 数值 | 否 |
| param.max_record_pool | 对象池大小 | 文本 | 无 | 数值 | 是 |
- 其他参数
| 参数名 | 参数含义 | 参数值类型 | 默认值 | 值域范围 | 是否重启生效 |
|---|---|---|---|---|---|
| param.change_interval_sec | 日志进度查询间隔 | 文本 | 无 | 数值 | 否 |
| param.map_update_timeout_sec | 监听表刷新超时时间 | 文本 | 无 | 数值 | 否 |
| param.lag_barrier | 与数据库延迟最小值 | 文本 | 无 | 数值 | 否 |
| param.local_arch | 优先使用本地归档文件 | 开关 | 关 | 开、关 | 否 |
| param.lesql | 自定义查询日志进度SQL | 文本 | 无 | 文本 | 否 |
| param.local_src_login | 允许本地编辑的 login 信息不被覆盖 | 开关 | 关 | 开、关 | 否 |
| param.enable_partition_validation | 验证分区合法性 | 开关 | 开 | 开、关 | 否 |
| param.mute_rac | 屏蔽RAC某节点 | 文本 | 无 | 支持输入多个值,以逗号分隔 | 是 |
| param.tx_scn_sub | 是否使用 scn sub 作为缓存文件名的组成部分 | 开关 | 关 | 开、关 | 是 |
运行日志
操作入口:<数据节点><详情><节点监控><采集代理监控><采集代理名称><运行日志>\ 功能说明:查看指定采集进程的日志,支持下载。
重启集群的某个采集进程
操作入口:<数据节点><详情><节点监控><采集代理监控><采集代理名称><重启采集进程>\ 功能说明:重启指定采集进程,点击后会进行二次确认提示。重启采集进程期间会中断该进程上正在进行的采集任务,请慎重操作。
采集代理 Topic 统计
关于此功能
当ORACLE节点数据源读取方式采用“DataPipeline Oracle 采集代理”方式时, 采集代理Topic统计将展示ORACLE节点作为数据源时采集代理使用的Topic信息,统计Topic大小,您可以在页面通过「查看」操作,根据输入的条件查看Topic消费数据的情况。
操作步骤
- 1.进入「数据节点」列表页,单击ORACLE节点名称链接或「详情」按钮,进入ORACLE节点详情页
- 2.点击「采集代理Topic」统计 页签,列表将展示当前节点采集代理使用的Topic名称,以及每个Topic占用的空间。
- 3.点击对应 Topic「查看」按钮,指定数据消费条件,查看Topic消费数据的情况。
- 1.指定消费起点。系统支持指定消费起点为:beginning、最新数据、时间戳、offset。
- 1.当选择消费起点为时间戳时,请在时间选择器选择消费起点的时间;
- 2.当选择消费起点为offset时,请输入消费分区 ,以及offset值。
- 2.指定消费范围。系统支持一次性消费10条、20条、50条、100条消息。默认消费100条。
- 3.指定消费条件。系统可根据您输入的消费条件 ,在消费数据中展示包含消费条件的数据。
- 4.点击「执行」按钮,执行结果将展示消费结果。
- 1.指定消费起点。系统支持指定消费起点为:beginning、最新数据、时间戳、offset。
采集代理监控
Oracle 采集代理监控提供采集代理程序的状态、速率、延迟等关键监控指标。
关于此功能
- 采集代理基本信息
- 采集代理状态
- 运行中
- 已暂停
- 错误
- 监控指标列表
| 指标 | 指标说明 |
|---|---|
| 已解析日志量 | 累计值,指采集代理自上次启动以来解析的日志量,单位kb |
| 日志解析速率 | 速率值,指随时间变化的采集代理解析日志的速率,单位kb/s |
| 因日志中不是所有数据都会同步,不代表同步速率/传输速率 | |
| 解析进程积压时间 | 时间值,指采集代理当前处理到的日志时点与最新日志时间的时间差值,单位ms |
| 采集代理重启 | 状态值,指采集代理自动重启事件在时间轴上的呈现,不会统计手动重启 |
| 系统处理延时-P95 | 时间值,指采集代理自身的处理延迟,在采样时间段内P95置信区间内的延时表现,可以理解为统计意义平均值,单位ms |
| 系统处理延时-MAX | 时间值,指采集代理自身的处理延迟,在采样时间段内的最大值,单位ms |
| 系统处理延时-MIN | 时间值,指采集代理自身的处理延迟,在采样时间段内的最小值,单位ms |
| 采集代理延迟(数据库事务提交时间-数据写入缓存时间) | 时间值,指采集代理数据处理的整体延迟,计算方式为数据库事务提交时间-数据写入缓存时间的差值,单位ms |
| 缓存写入速率 | 速率值,指采集代理写入缓存的写入速率,单位kb/s |
| 采集代理事务处理数量 | 累计值,指采集代理自上次启动以来处理的事务数量,单位个 |
操作步骤
- 在Oracle数据节点中,点击采集代理监控TAB
- 选择时间区间
- 查看监控数据
注意事项
- 采集代理监控数据默认保存最近30天
Logminer 读取方式
权限要求
- 提供 Oracle LogMiner;
- 12c 以下版本不需要 LOGMINING 权限;
- 日志补全至少需要开启 PRIMARY KEY、ALL、UNIQUE 级别的日志级别;
写入方式
JDBC写入方式
权限要求
- 对业务数据库具备 SELECT、INSERT、UPDATE、DELETE、DROP、 INDEX、ALTER、CREATE 权限。
- 需要授予 SELECT ON V_$SESSION 权限用于处理死锁导致的任务中断
- 需要授予 CREATE SESSION 权限
- 登录用户需要是 RESOURCE 角色,以便于用户能够创建表、索引等
节点特性
表
| 表类型 | JDBC读取 | Datapipeline Oracle 采集代理读取 |
|---|---|---|
| 普通表,即堆组织表,含分区表,无压缩 | 支持 | 支持 |
| 索引组织表 | 支持 | 不支持 |
| 临时表 | 支持 | 不支持 |
| 外部表 | 支持 | 不支持 |
| 压缩表 | 支持 | 不支持 |
| 嵌套表 | 支持 | 不支持 |
| 对象表 | 支持 | 不支持 |
| 簇表 | 支持 | 不支持 |
| 列存储表 | 支持 | 不支持 |
| 分布数表 | 支持 | 不支持 |
| 内存表 | 支持 | 不支持 |
视图
| 视图类型 | 读取 | 写入 |
|---|---|---|
| 普通视图 | 支持 | 不支持 |
| 物化视图 | 不支持 | 不支持 |
索引
源
支持查看索引
目的地
支持创建的索引类型:主键、唯一索引、普通索引、复合索引
数据类型
| 数据类型 | 数据源节点 | 目的地节点 |
|---|---|---|
| BFILE | ✓ | ✓ |
| BINARY_DOUBLE | ✓ | ✓ |
| BINARY_FLOAT | ✓ | ✓ |
| BLOB | ✓ | ✓ |
| CLOB | ✓ | ✓ |
| DATE | ✓ | ✓ |
| INTERVAL DAY TO SECOND | ✓ | ✓ |
| INTERVAL DAY (day_precision) TO SECOND | ✓ | |
| INTERVAL DAY TO SECOND (fractional_seconds_precision) | ✓ | |
| INTERVAL DAY (day_precision) TO SECOND (fractional_seconds_precision) | ✓ | |
| INTERVAL YEAR TO MONTH | ✓ | ✓ |
| INTERVAL YEAR (year_precision) TO MONTH | ✓ | |
| TIMESTAMP | ✓ | ✓ |
| TIMESTAMP(fractional_seconds_precision) | ✓ | |
| TIMESTAMP WITH TIME ZONE | ✓ | ✓ |
| TIMESTAMP(fractional_seconds_precision) WITH TIME ZONE | ✓ | |
| TIMESTAMP WITH LOCAL TIME ZONE | ✓ | ✓ |
| TIMESTAMP(fractional_seconds_precision) WITH LOCAL TIME ZONE | ✓ | |
| NCLOB | ✓ | ✓ |
| NUMBER | ✓ | ✓ |
| NUMBER(p) | ✓ | |
| NUMBER(p, s) | ✓ | |
| FLOAT | ✓ | ✓ |
| FLOAT(p) | ✓ | |
| RAW | ✓ | ✓ |
| RAW(p) | ✓ | |
| VARCHAR2 | ✓ | ✓ |
| VARCHAR2(size CHAR) | ✓ | |
| NVARCHAR2(size) | ✓ | ✓ |
| CHAR | ✓ | ✓ |
| CHAR(size) | ✓ | |
| CHAR(size BYTE) | ✓ | |
| CHAR(size CHAR) | ✓ | |
| NCHAR | ✓ | ✓ |
| NCHAR(size) | ✓ | |
| LONG | ✓ | ✓ |
| LONG RAW | ✓ | ✓ |
| ROWID | ✓ | ✓ |
| UROWID | ✓ | ✓ |
| SDO_GEOMETRY | ✓ | ✓ |
多租户
多租户容器数据库是 Oracle 数据库的一种架构。CDB 作为根数据库,PDB作为容器数据库或应用容器数据库,来以一个数据库实例分多租户支撑不同业务。
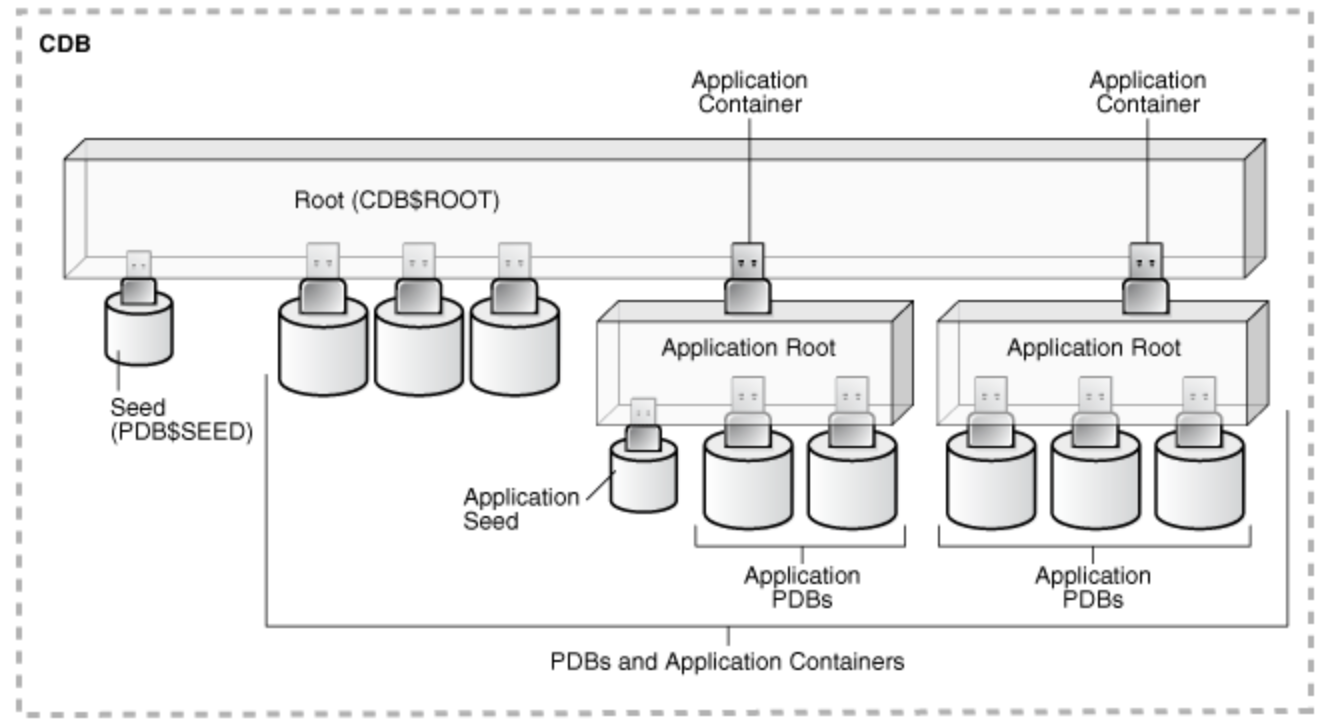
在历史版本中,为应对多租户数据库,我们需要在对应每一个PDB安装一个采集代理,以采集其增量数据,在PDB数量较多时,会导致采集代理数量过多,带来更多的负载的同时也不好管理。
在新版本中,我们支持了一个采集代理程序采集一个多租户容器数据库实例。
关于此功能
DataPipeline 与 Oracle 多租户容器数据库的逻辑概念对应关系如下:

- 一个 CDB 数据库对应 DataPipeline 中的一个 CDB Oracle 数据节点
- CDB 数据库中统一管理所有 PDB 的数据库日志
- 一个 PDB 数据库对应 DataPipeline 中的一个 PDB Oracle 数据节点
- PDB 节点中实际包含了用户的 Schema、数据表
- 配置 PDB 节点时,需要引用 CDB 节点信息
- 一个 采集代理 采集 CDB 数据库的 Redo 日志
- 在 DataPipeline 的 CDB 节点中,管理采集代理状态、配置、监控等信息
- 在数据链路中,可选 PDB 数据节点,数据映射选择的是 PDB 的数据表
- 数据任务在进行全量读取时,通过 JDBC 访问 PDB 节点
- 数据任务在进行增量读取时,通过采集代理读取 CDB 中的数据库日志,获取增量数据
补全日志
Oracle 补全日志可以在数据库级别设置,也可以在表级别设置。在数据库级别中,补全日志按补全的信息量,对应几个级别:
(1)最小附加日志(Minimal supplemental logging):是开启 logmnr 的最低日志要求,提供了行链接(chained rows)和多种数据存储(比如聚簇表、索引组织表)的信息。在 Oracle 9.2 之后的版本中,默认都不开启。
(2)主键补全(Primary key supplemental logging):在日志中补全所有主键列。如果表中无主键,则补全一个非空唯一索引列;如果非空唯一索引键也没,那么会补全除了 LOB 和 LONG 类型字段以外的所有列,这时就和下面的所有补全一样了。
(3)唯一键补全(Unique key supplemental logging):当唯一键列或位图索引列被修改时,在日志中补全所有唯一键列或位图索引列。打开唯一键补全也会同时打开主键补全。注意这个级别是需要条件触发的。
(4)外键补全(Foreign Key supplemental logging):当外键列被修改时,将在日志中补全所有外键列。这个级别也是需要条件触发的。
(5)所有补全(All supplemental logging):在日志中补全所有字段(排除 LOB 和 LONG 类型)。
在历史版本中,DataPipeline 的采集代理读取方式与 LogMinner 读取方式仅支持所有补全(All supplemental logging),在数据源 Oracle 数据库本身的业务压力比较大时,开启 ALL 级别日志补全也会给数据库服务带来比较大的压力。
因此,我们在新版本中支持了较低级别的日志补全进行数据同步的功能
关于此功能
当您使用 Oracle 数据源时,在数据库配置过程中需要开启日志补全功能,补全 redo log 日志文件;DataPipeline 通过解析日志文件获取增量数据,同步至下游。
如 Oracle 数据源业务压力较大,经您的数据库管理员(DBA)评估,无法开启 ALL 级别日志补全时,可以使用最小附加日志、主键补全、唯一键补全日志级别进行数据同步。
如 Oracle 数据库中有数据表 A,表结构如下
| id | PK |
|---|---|
| customer_id | |
| order_id | 唯一索引 |
| order_type | |
| price | |
| order_ts |
当上游发生业务变更,可以获取到的增量数据说明:
| 日志级别 | 业务数据变更 | 可获取的增量数据说明(不包含元数据信息) |
|---|---|---|
| Primary key supplemental logging | update A set price = 300 where id = 1222 | id = 1222,price = 300 |
| Unique key supplemental logging | update A set price = 300 where order_id = 1222 | order_id = 1222,price = 300 |
| Minimal supplemental logging | update A set price = 300 where id = 1222 | price = 300 |
| All supplemental logging | update A set price = 300 where customer_id = 1222 and order_ts = 1667445833 | id = 1222,customer_id = 1222,order_id = 1222,order_type = 1,price = 300,order_ts = 1667445833 |
根据可获取的增量数据,数据目的地可以执行的更新操作的依赖条件取决于日志内容,存在部分使用限制。
使用场景
当数据源需要同步的数据表有主键、唯一索引时,开启对应级别的日志补全,支持更新/删除 DML 同步。
当数据源需要同步的数据表没有主键、唯一索引时,开启非所有补全的日志补全级别,仅支持数据插入 DML 同步。
当数据源需要同步的数据表没有主键、唯一索引时,推荐开启 ALL 级别日志补全,通过逻辑主键功能指定业务主键,支持更新/删除/插入 DML 同步。
对不同的日志补全级别,可能存在不同的使用限制,使用此功能之前,请阅读 Oracle 数据源通过非 ALL 级别日志补全进行增量数据同步功能的使用限制说明,并合理评估数据源业务压力,选择合适的数据补全级别,以满足业务要求。
对于不同的 Oracle 数据节点日志补全级别,需要在数据节点-连接参数配置中添加连接参数
- 对应日志补全级别为:最小附加日志补全、主键补全、唯一键补全,需要添加参数:SUPPLEMENTAL_ALL_CHECK = false ; ENABLE_MINIMAL = true
- 对应日志补全级别为:所有补全,无需额外添加连接参数,SUPPLEMENTAL_ALL_CHECK 默认值为 ture,ENABLE_MINIMAL 默认值为 false
添加oracle节点的操作步骤
- 新建弹窗界面选择了 Oracle 节点类型之后,显示 Oracle 的基本信息配置模板:
- 版本:Oracle 10G、Oracle 11G、Oracle 12C、Oracle 19C
- 连接配置
- 连接地址名称
- 数据库服务器地址可以填写多个服务器的连接地址,作为一个“单机数据库”或“集群数据库”的连接地址
- 可以选择是否配置ASM连接信息,ASM连接信息与历史版本无变化
- ASM读取模式
- 本地读取
- 远程读取
- 本地读取模式下
- ASM连接地址
- 用户名
- 密码
- AMS_ORACLE_SID
- ASM_ORACLE_HOME
- 磁盘信息
- 远程读取模式下
- ASM连接地址
- 用户名
- 密码
- Endian类型(大端、小端)
- ASM读取模式
- 可以点击添加数据库服务器地址
- 可以点击删除
- 删除节点连接地址组的前置条件是没有数据任务在引用这个连接地址组;
- 当有任务引用时,不可删除,Hover删除按钮提示:“有数据任务引用,请切换连接地址后重试”
- 可以选择统一认证或不同连接地址分别认证,认证配置内容无变化
- 统一认证方式提示:打开统一认证方式,则认定使用「连接配置-1」的认证方式,\ 即在下方认证信息中代入「连接配置-1」的认证信息。
- 打开统一认证方式后,该连接地址的认证不允许修改
- 统一认证默认关闭
- 采集代理配置
- 采集代理名称:必填,名称长度限制同节点
- 服务器地址:指采集代理的地址和端口
- 采集数据库地址:下拉选择在连接配置中的数据库连接地址
- 可选连接地址组的名称,指定该采集代理采集哪个连接地址组
常见问题说明
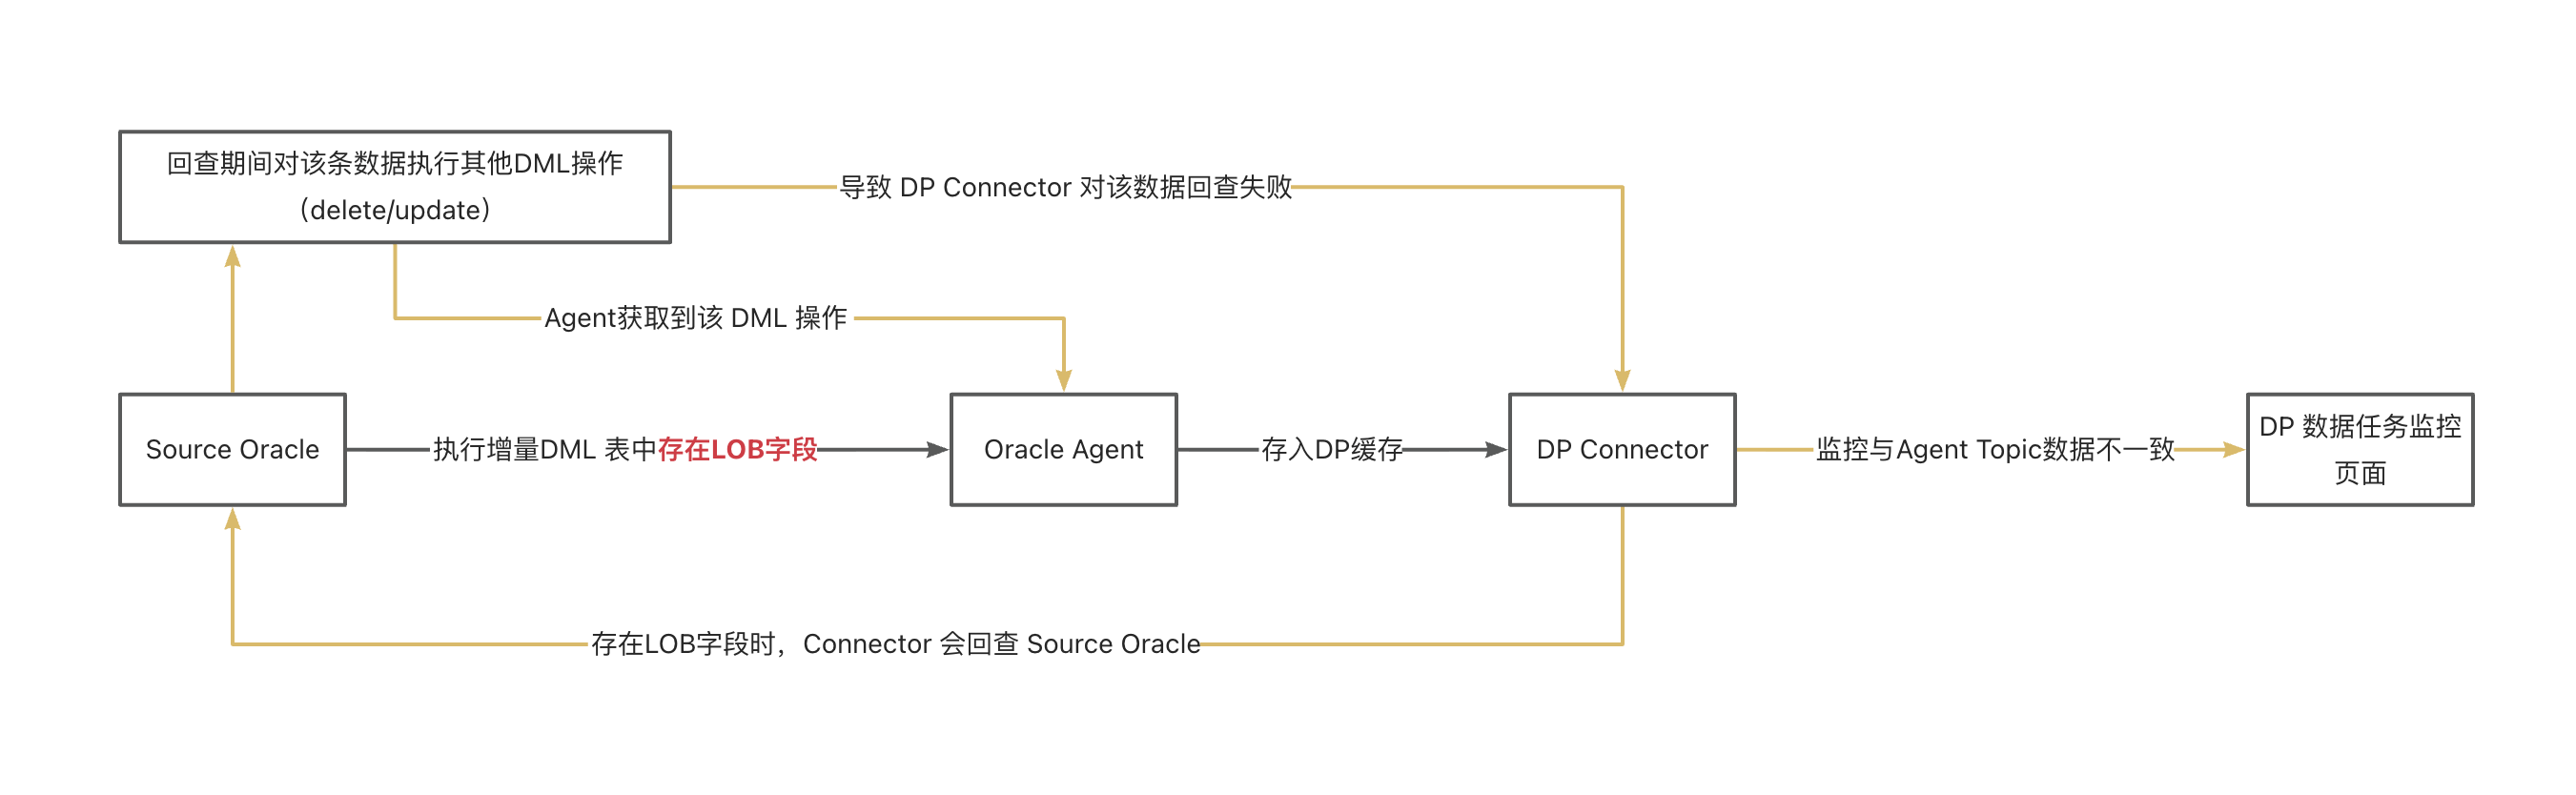
Oracle Agent任务,DML/DDL变更,DP Topic 以及 页面监控读取数量统计异常(高概率出现),下游数据与源端不一致
- 前提条件:
- DML 变更出现该问题的前提条件:执行DML变更操作的表中存在 LOB 字段,执行完成后快速对该条数据执行其他的DML操作(update/delet e)
- DDL 变更出现该问题的前提条件:执行DDL变更,执行完成后快速对该表执行多条 DML 操作(insert/update/delete)
- 原因:
- DML 变更出现该问题的原因:当 Oracle Agent 获取到 DML 操作,同时该 DML 操作数据包含 LOB 字段时,DataPipeline 会对该条数据进行回查。若在回查过程中该条数据执行了其他变更,就会导致Data Pipeline回查失败,同时 Oracle Agent 获取到新的增量数据。此时就会导致,DataPipeline 监控页体现与 Oracle Agent Topic 中记录不一致,同时源节点与目的地节点的数据不一致。
- DDL 变更出现该问题的原因:与 DML 同理,当 Oracle Agent 获取到 DDL 操作后,DataPipeline 会对该 DDL 涉及的表进行回查。若在回查过程中该表执行了多条 DML 操作,同时涉及 DDL 变更的字段存在默认值时,会导致源节点与目的地节点的数据不一致。
DML 操作出现该问题原理示例: