Hive
配置要求
在进行配置之前,请务必检查您的 Hive 数据节点是否符合平台要求,参考如下:
| 要求 | 详情 |
|---|---|
| 版本要求 | + 支持基于 CDH 5.12.2 平台的 Hive 1.1.0,基于 CDH 6.1.1 平台的 Hive 1.x.y、2.x.y,基于 CDH 7.1.7 平台的 Hive 3.1.3 + 支持基于 BMR 2.1.0 平台的 Hive 3.1.0 + 支持基于 HDP 3.1.5 平台的 Hive 3.1.0 + 支持基于MRS 3.2.0-LTS.1 平台的Hive 3.1.0 |
| 权限要求 | + 源端(读取数据):对数据目录有读(r)+ 执行(x) 权限 - - 示例权限:755 或 644(视安全策略而定) - - 验证命令:hdfs dfs -ls /path/to/source/data + 目的端(写入数据):对目标目录有写(w)+ 执行(x) 权限 - - 建议权限:775 或 755 - - 需要提前创建目标目录: hdfs dfs -mkdir -p /path/to/target/dir hdfs dfs -chown <username>:<group> /path/to/target/dir * hdfs dfs -chmod 775 /path/to/target/dir |
| 其他要求 | 无 |
Hive 文件读取方式通过连接到 Metastore 读取表结构并通过 HDFS 客户端读取文件,该读取模式支持 CSV、Parquet、Avro、ORC 类型文件的定时全量读取以及基于分区的定时增量读取。
Hive 文件写入方式通过连接到 Metastore 写入表结构并通过 HDFS 客户端进行文件写入,该写入模式支持将源端数据写入 HDFS 目的地端的 CSV、Parquet、Avro、ORC 类型文件,并且支持新建外部表、分区表。
JDBC 写入方式通过 JDBC 的方式连接到 HiveServer2 进行文件写入,该写入模式支持将源端数据写入目的地端的 ORC 类型文件,并且支持新建外部表、内部表、分区表、分桶表以及事务 ORC 表。
节点特性
数据类型
| 序号 | 官网支持类型 | DP定义的类型 | 作为源支持情况 | 作为目的地支持情况 |
|---|---|---|---|---|
| 1 | Tinyint | TINTINT | ✔️ | ✔️ |
| 2 | Smallint | SMALLINT | ✔️ | ✔️ |
| 3 | INT/INTEGER | INT/INTEGER | ✔️ | ✔️ |
| 4 | BIGINT | BIGINT | ✔️ | ✔️ |
| 5 | FLOAT | FLOAT | ✔️ | ✔️ |
| 6 | DOUBLE | DOUBLE | ✔️ | ✔️ |
| 7 | DOUBLE PRECISION | ❌ | ❌ | |
| 8 | DECIMAL | DECIMAL | ✔️ | ✔️ |
| 9 | NUMERIC | ❌ | ❌ | |
| 10 | TIMESTAMP | TIMESTAMP | ✔️ | ✔️ |
| 11 | [DATE](https://cwiki.apache.org/confluence/pages/viewpage.action?pageId=82706456#LanguageManualTypes-date) | [DATE](https://cwiki.apache.org/confluence/pages/viewpage.action?pageId=82706456#LanguageManualTypes-date) | ✔️ | ✔️ |
| 12 | INTERVAL | ❌ | ❌ | |
| 13 | STRING | STRING | ✔️ | ✔️ |
| 14 | VARCHAR | VARCHAR | ✔️ | ✔️ |
| 15 | [CHAR](https://cwiki.apache.org/confluence/pages/viewpage.action?pageId=82706456#LanguageManualTypes-char) | [CHAR](https://cwiki.apache.org/confluence/pages/viewpage.action?pageId=82706456#LanguageManualTypes-char) | ✔️ | ✔️ |
| 16 | BOOLEAN | BOOLEAN | ✔️ | ✔️ |
| 17 | BINARY | BINARY | ✔️ | ✔️ |
| 18 | arrays | arrays | ✔️ | ❌ |
| 19 | maps | maps | ✔️ | ❌ |
| 20 | structs | structs | ✔️ | ❌ |
| 21 | union | ❌ | ❌ |
操作步骤:
1.用户点击「添加数据节点」按钮,弹出添加数据节点弹窗,填写名称、描述后选择节点类型为 Hive。
- 名称:必填项,最多可填 50 个字符,节点名称是该节点在系统的唯一标识。
- 描述:非必填项,无字符长度限制, 用户可自定义内容来描述和区分节点。
- 类型:下拉列表,选择数据节点类型。
2.补充 Hive 客户端连接配置信息并保存数据
- 节点版本:支持 2.x.y 版本 HDFS 配置:需要上传 core-site.xml、hdfs-site.xml 文件。请参考官方说明: http://hadoop.apache.org/docs/r2.7.6/hadoop-project-dist/hadoop-common/ClusterSetup.html
- 可上传多个文件,上传多个文件时从上到下按时间递增排序显示
- 最新上传的配置文件中的配置会覆盖之前上传过的配置文件中的配置,同名文件夹不覆盖
- 数据库:必填项,可以选择用户权限的所有库或者填写连接数据库的名称。
- 写入根目录:非必填项,需要填写 Hive 目的地的主路径,要求填写绝对路径
- HDFS 用户名:必填项,HDFS 用户名用于读取 hive 表映射路径下的文件数据,若该用户名无权限访问,则无法读取和写入数据。
- 认证方式:必选项,选项:无、kerberos
- 选择 kerberos:需要配置:krb5.conf、Hive Principal、Hive Keytab
3.如果您想用 JDBC 的方式写入将数据写入 Hive 目的地,您需要配置 JDBC 连接配置
- 服务器地址:必填项,连接数据源的域名或 IP 地址
- 端口:必填项,连接数据源的端口值。
- 数据库:必填项,可以选择用户权限的所有库或者填写连接数据库的名称。
- SQL 引擎:必选项,选择 MapReduce 或 Spark 作为 SQL 引擎,默认为 MapReduce
- 认证类。型:必选项,选项:无 LDAP
- 选择无:需要配置用户名(必填),密码(非必填)
- 选择 LDAP:需要配置用户名(必填),密码(必填)
关于分区的说明
- 所有分区字段在数据节点处必须填写类型、表达式
- 所有分区字段在数据任务处必须填写同步起点
- 如果存在时间分区,那么时间分区只能有一层,数字分区不做限制,也就是一个表可以有1个时间+n个数字类型的分区
- 如果不存在时间分区,那么只支持一层数字分区,也就是一个表只能有一个数字类型的分区
- 仅支持时间和数字类型,字符串类型和其他类型不支持
- 如果是时间+数字一起使用的多层分区,那么数字类型的分区必须为定值,也就是表达式和同步起点相同,比如要同步0,那么表达式和起点都为0,不对这些进行校验,请保证正确使用
关于HIve 文件读取增量分区的含义:
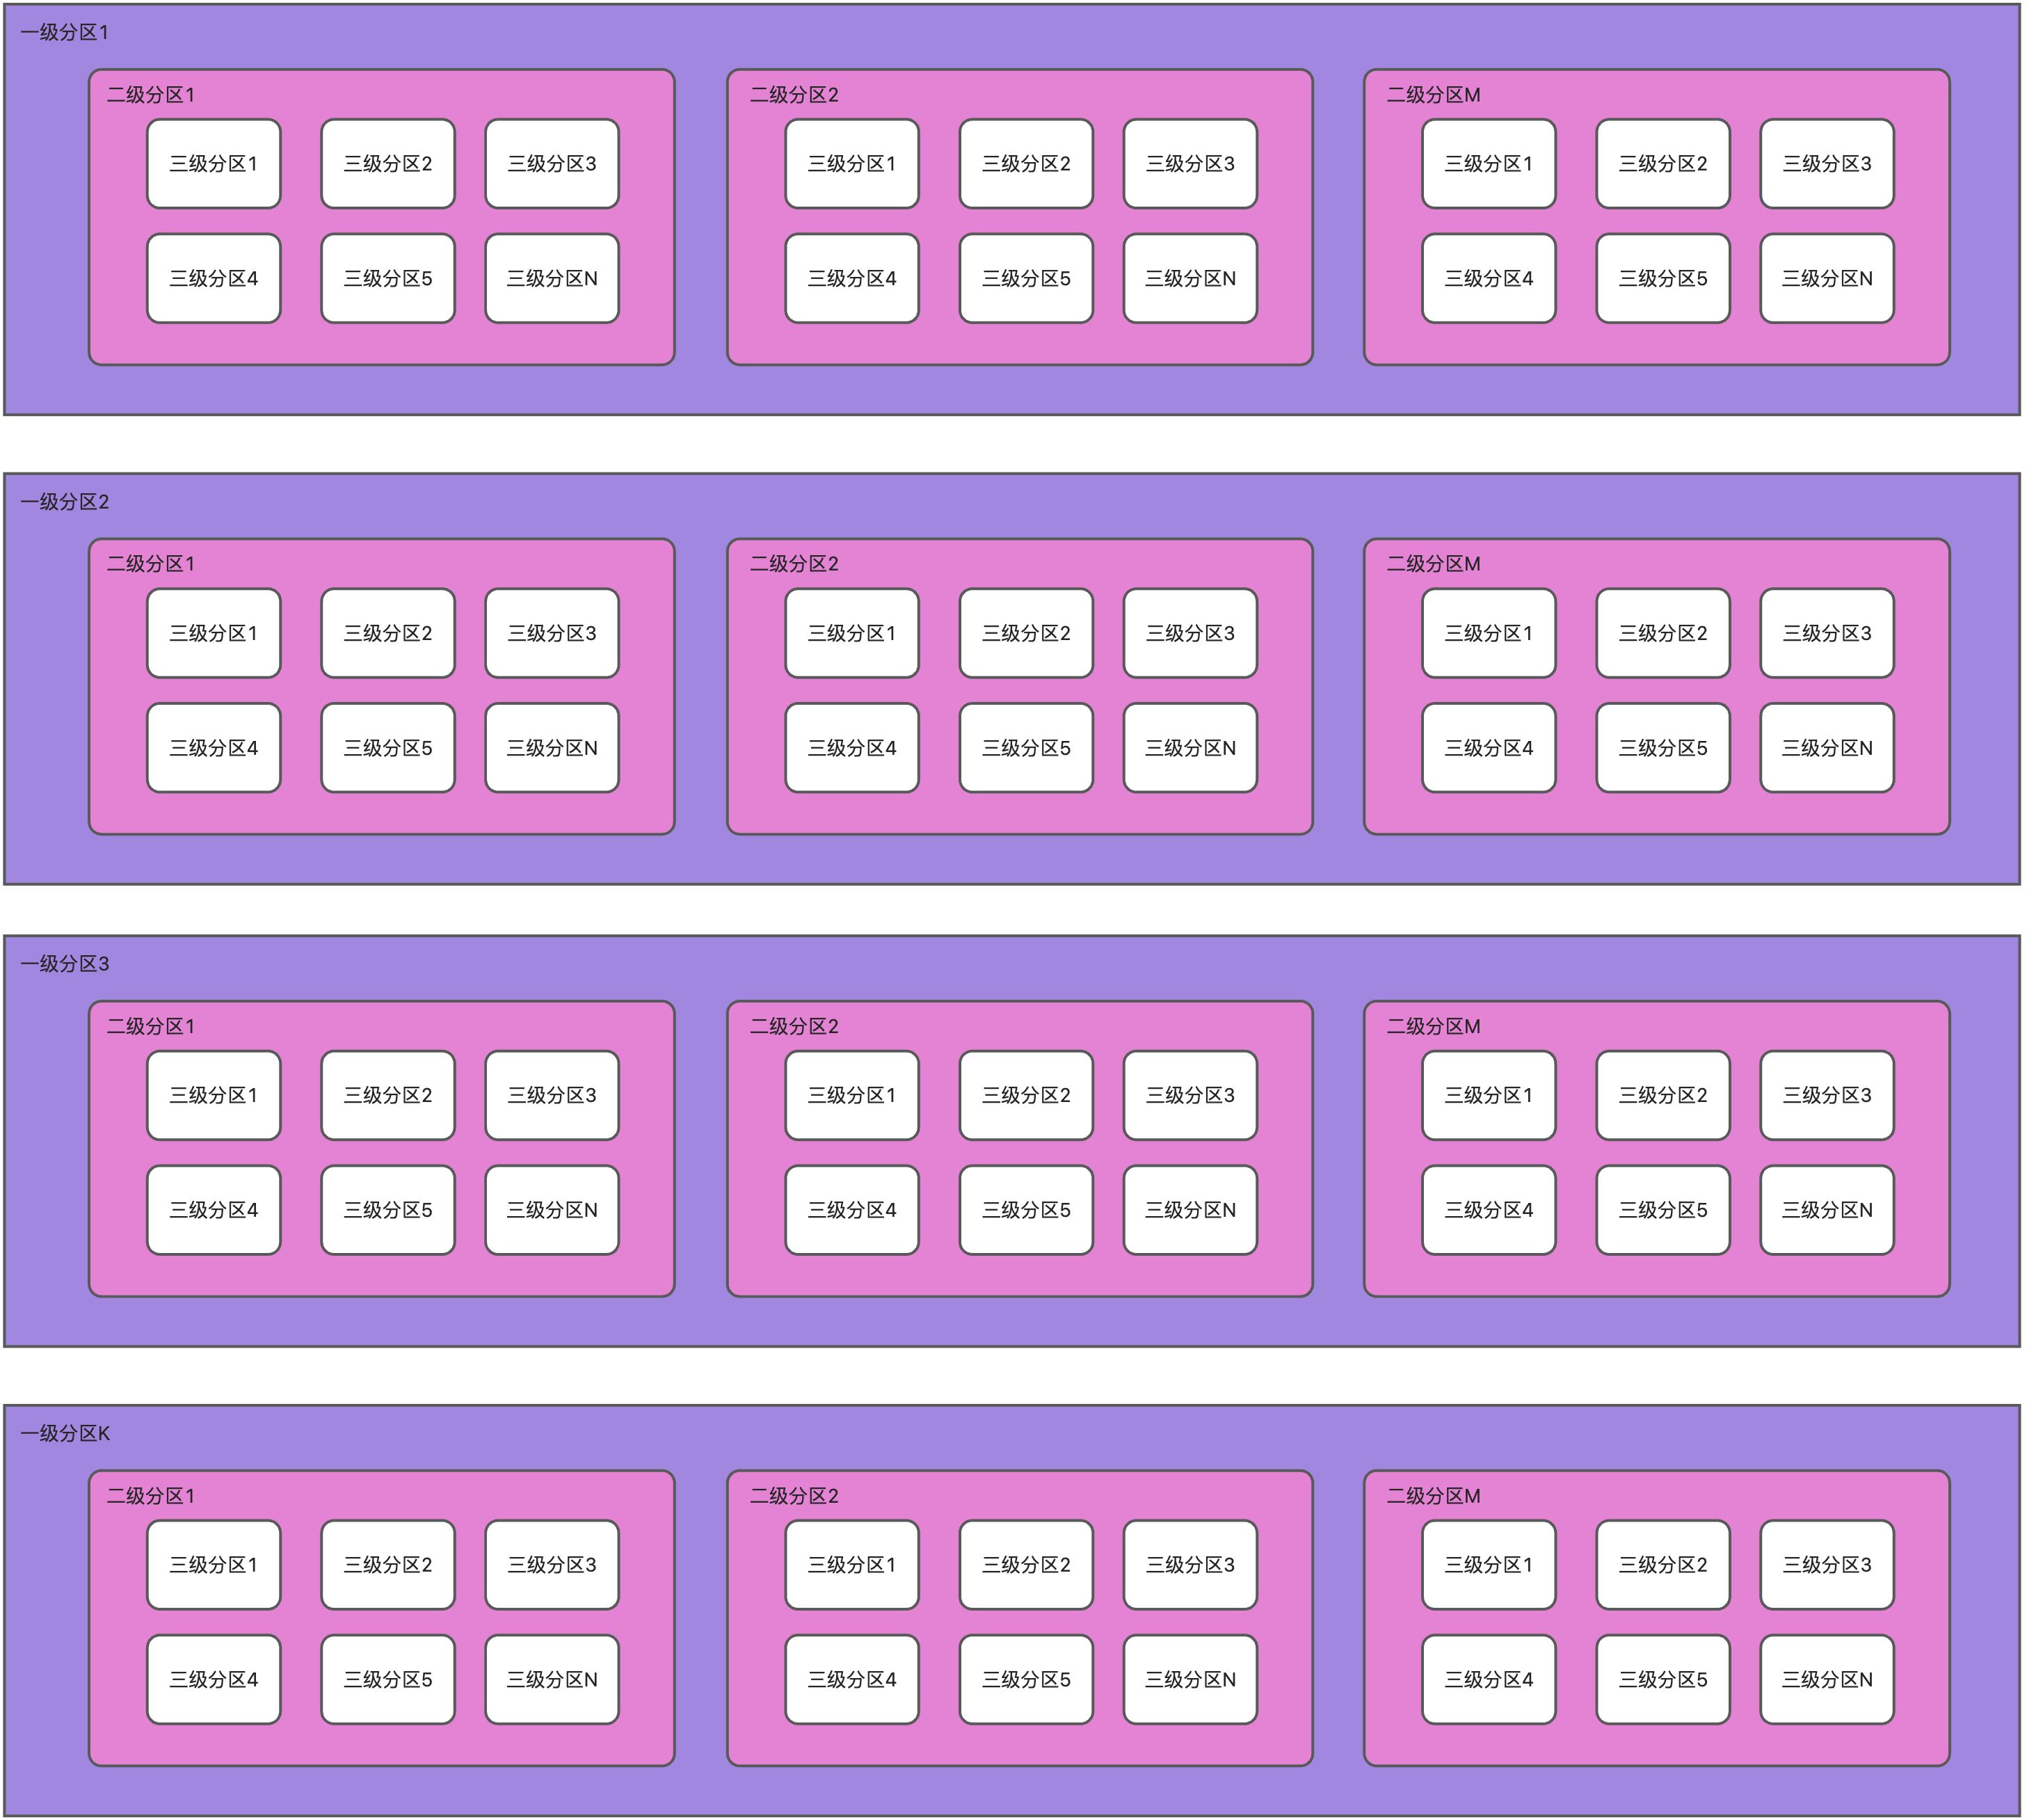
Hive分区读取时,需要结合业务情况进行设置:
Hive的分区分为可以增量的分区和不可增量的分区。
可以增量的分区,又分为有界和无界两种。
| 分区特性 | 是否有界 | 使用说明和限制 |
|---|---|---|
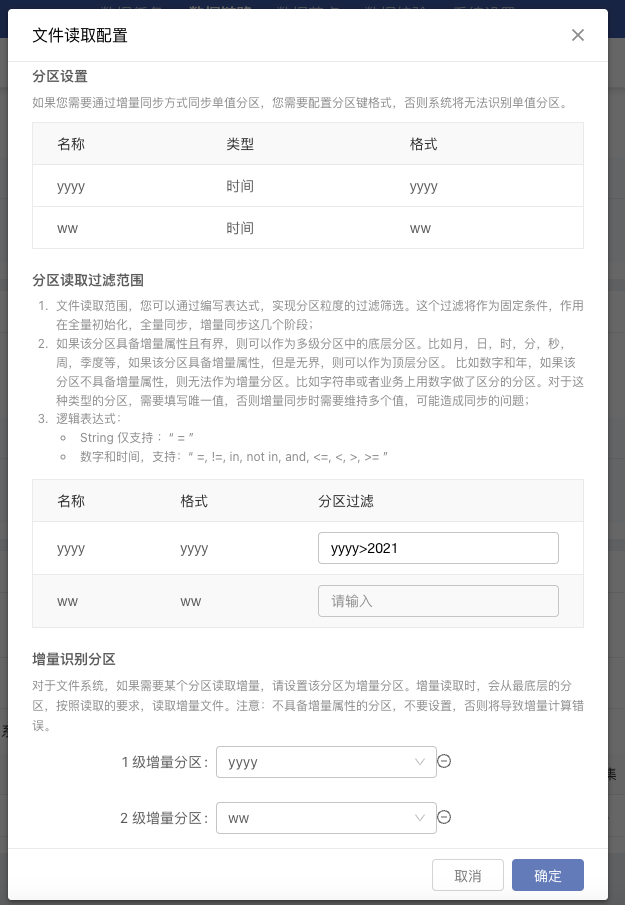
| 无增量含义的分区 | 其值是明确的list。 | 通常是跟随业务进行设定的,比如按照地区进行分区,无法计算增量。因此这个是不能作为增量识别分区使用的。只能在读取设置里过滤条件里进行筛选,如果不筛选的话,视为同步所有分区的内容。 |
| 有增量含义的分区 | 有界 | 增量且有界的分区,可以作为多级分区的非顶层分区进行设置。例如月,日,时,分,秒,周,季度等,有 |
| 无界 | 增量但时无界的分区,可以作为分区读取的顶层分区,例如数字和年。 |
分区读取配置如下图:
注意:关于周的定义
使用ISO8601标准
- yyyy为自然年,YYYY为周基年,鉴于使用习惯,所以页面上可以写yyyyww来代表周基年和周,实际后端采用的是ISO8601标准的YYYY进行解析
- 这个地方需要注意,比如2024年只有52周,2025年第一周开始时间为2024年12月30号
另外对于非法数据不做处理,比如qq为季度,只能为01,02,03,04.但是如果出现了其他数字,将有可能导致数据读取错误。
分区Format的说明:
- 数字格式:支持用 Java 数字格式化的方式定义,常见的格式如下:
- %d 表示实际长度的十进制整型数据
- %04d 表示在前面补 0 的至少四位的十进制整型数据,如:0001、0002、0003...
- 时间格式:支持用 yyyy 表示年份,MM 表示月份,dd 表示天,HH 表示时,mm 表示分,ss 表示秒。中间允许使用’-‘以及来分隔,如:yyyy-MM-dd 。不支持空格' '、斜线'/'、反斜线’\’
- 固定步长支持的格式范围:
| 格式 | 样例 |
|---|---|
| yyyy | 2024 |
| yyyyMM | 202412 |
| yyyyMMdd | 20241231 |
| yyyyMMddHH | 2024123112 |
| yyyyqq | 202404 |
| yyyyq | 20242 |
| yyyyww | 202432 |
| yyyy-MM-dd | 2024-12-31 |
动态步长支持的格式范围:
| 格式 | 样例 |
|---|---|
| yyyy | 2024 |
| yyyyMM | 202412 |
| yyyyMMdd | 20241231 |
| yyyyMMddHH | 2024123112 |
| yyyyqq(qq:两位数字表示季度) | 202404 |
| yyyyq(q:一位数字表示季度) | 20243 |
| yyyyww(22:两位数字表示周) | 202432 |
| yyyy-MM-dd | 2024-12-31 |
任务同步的配置
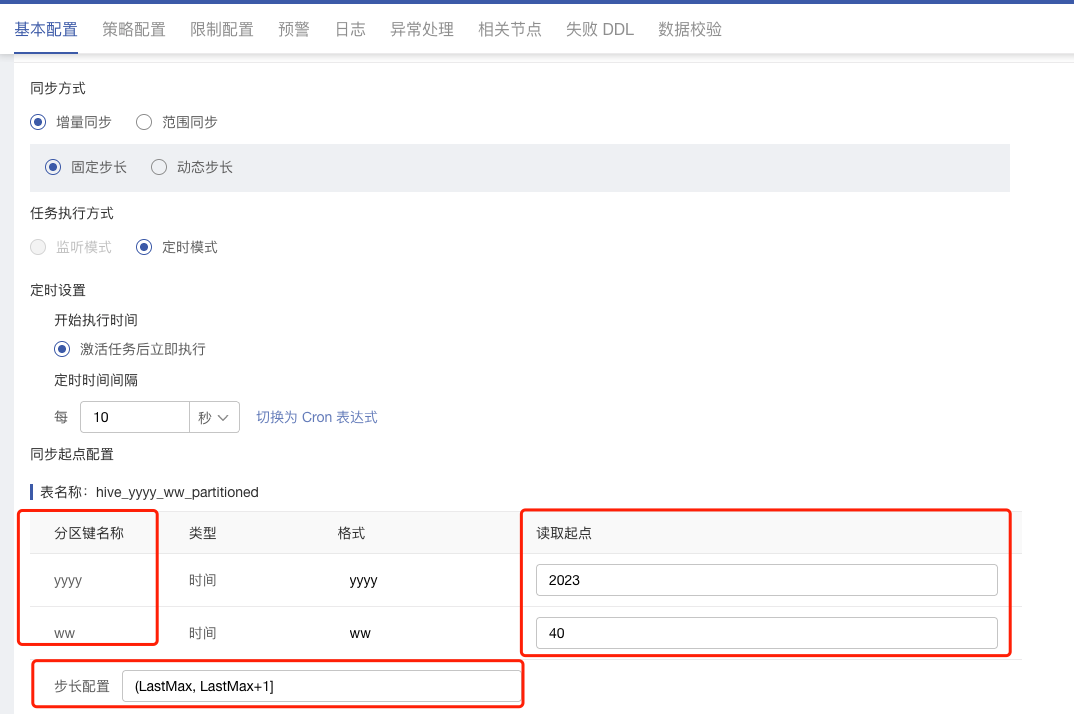
增量同步
首先要设置读取的起点,注意读取的起点,结合上图实际上是增量分区1=value1,增量分区2=value2,增量分区3=value3. 因此起点实际上是对应的每个分区设置一个值,然后再设置步长,步长则是根据起点设置后,从最底层分区开始读取增量,同时由于底层分区均有界,因此可以从底层分区读完过度到上一级分区上。
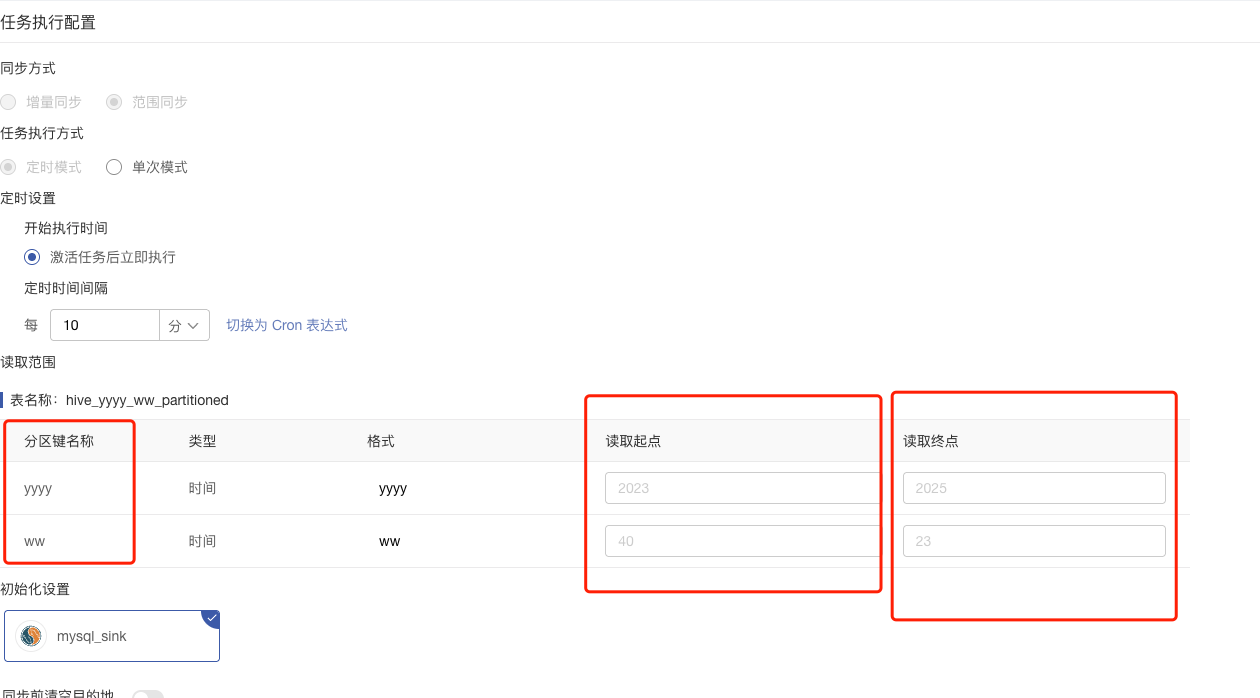
范围同步
注意起点是增量分区1=value1,增量分区2=value2,增量分区3=value3
终点是增量分区1=value1‘,增量分区2=value2‘,增量分区3=value3’