任务执行配置
任务执行配置是通过指定同步方式,执行时间,执行方式等配置选项指定任务执行方式的配置。
关于此功能
◎ 读取设置
读取设置包括以下几项配置:
- 传输队列设置:
- 设置数据源读取和写入的传输队列回收时间,超过缓存时间的数据会被资源回收;
- 读取并发设置:
- 设置并发读取可以在任务运行的时候将所选表按设置的分片规则进行并发读写来提升同步速率。您需要选择分片字段、分配方式和片数来配置并发读取。详情请查看读取并发设置;
- 读取条件设置(仅支持JDBC读取方式)
- 用户可根据需求设置 Where 语句,DataPipeline 提供last_max()函数帮助用户解决定时读取增量数据的需求。详情请查看读取条件设置。
◎ 写入设置
写入设置包括以下几项配置:
- Batch设置
- 可以通过条数、大小、时间来限制 Batch 规则,当前 Batch 写入成功后,下一 Batch 的满足条件判断归零,根据所选规则,达到任一规则上限则形成 Batch 写入。
- 起点设置
- 使用任务统一起点
- 使用暂停时进度(仅当任务暂停时出现)
- 全量初始化
- 指定起点
- 激活任务时为起点
- 分映射指定同步起点。详情查看任务执行配置。
- 使用任务统一起点
- 逻辑主键设置
- 可选择:不指定、使用目的地表元数据进行映射、使用源表的元数据进行映射
- 当选择不指定时,可以手动根据需要自由配置,如果不配置,加载时,将按照无主键表,仅支持 insert 方式
- 当使用元数据进行映射时,如果该数据库有主键,会优先用主键,无主键时会使用唯一索引。如果不是关系型数据库,会使用类似主键的元数据,例如 rowkey,key,_id 等。
◎ 同步方式
是指定数据任务同步的方式,包括增量同步与全量同步。我们提供两种任务同步方式:
| 同步方式 | 任务执行方式 | 业务及要求 |
|---|---|---|
| 增量同步 | 监听模式 | 采用日志监听方式,即CDC采集,是一个无界的数据流 |
| 定时模式 | 快照方式获取数据,每次读取均是一个有界的数据流,通过增量识别字段获取本次的数据流 | |
| 全量同步 | 定时模式 | 快照方式获取数据,每次读取均是一个有界的数据流,并且支持定时获取 |
| 单次模式 | 仅执行一次全量数据同步。快照方式获取数据,单次读取一个有界的数据流 |
◎ 读取方式
| 同步方式 | 任务执行方式 |
|---|---|
| JDBC读取 | JDBC 读取模式通过 JDBC Driver 连接到数据库并读取源端数据,该读取模式支持定时增量同步和定时全量同步 |
| 非JDBC读取 | CDC 读取方式:如mysql binlog日志、oracle logminer,通过解析日志进行实时数据抓取,进行数据增量同步 |
| DataPipeline 采集代理是DataPipeline 自研的在线解析日志的工具,目前仅支持Oracle和Gbase8s |
◎ 写入方式
| 同步方式 | 任务执行方式 |
|---|---|
| JDBC写入 | JDBC 写入模式通过 JDBC Driver 将数据写入目的地端; JDBC COPY模式,即在写入数据时使用copy命令,不同的节点的copy命令使用方式有区别; bulk insert,用于将大量数据快速加载到数据库表中,SequoiaDB |
| 非JDBC写入 | SDK写入,指利用数据库官方提供的软件开发工具包(Software Development Kit)中封装好的API或客户端库,在应用程序代码中执行数据写入操作 |
| 文件写入,将数据以文件的形式进行临时存储,随后解析文件中的数据并写入数据库,仅部分节点支持 |
◎ 同步起点
通用起点设置
指任务执行读取的数据起点,在基于日志获取技术的增量数据同步任务中,可以对数据任务整体做同步起点设置,也可对数据映射设置不同的同步起点。
- 任务使用统一同步起点
- 使用暂停时进度(仅当任务暂停时出现)
- 全量初始化
- 指定起点
- 激活任务时为起点
- 分映射指定同步起点
分映射指定同步起点设置
选择该选项后,用户可以通过任务映射列表-操作-写入设置进行单映射起点配置;也可以通过批量选中映射,对部分映射批量设置起点。
单映射设置
- 点击「写入设置」按钮,选择「起点设置」,进行映射起点配置
- 分映射同步起点设置可选择以下选项:
- 使用暂停时进度(仅当任务暂停时出现)
- 全量初始化
- 指定起点
- 激活任务时为起点
- 点击「保存」按钮,起点配置应用到该映射中
批量映射设置
- 批量选中需要配置起点的映射,「批量配置写入设置」按钮变为可用状态
- 点击「批量配置写入设置」按钮,选择「起点设置」
- 映射起点可以选择以下选项:
- 使用暂停时进度(仅当任务暂停时出现)
- 全量初始化
- 指定起点
- 激活任务时为起点
- 点击「保存」按钮,起点配置应用到选中映射中
指定起点介绍
指定起点配置
- 选择检查点:
- 使用检查点需在节点中配置「策略配置」-「检查点策略」,根据需求进行检查点策略配置
- 输入起点:
- 根据不同数据节点类型,输入对应的数据库起点
指定起点支持的数据节点
| 数据节点 | 读取方式 | 配置起点方式 |
|---|---|---|
| mysql | binlog | + 选择检查点 + 输入起点 - binlog postion - binlog文件名称 - GTID |
| oracle | logminer | + 选择检查点 + 输入起点 - logminer scn |
| 采集代理 | + 选择检查点 + 输入起点 | |
| gbase8s | gbase8s cdc | + 选择检查点 + 输入起点 - cdc记录序列号 |
| goldendb | goldendb cdc | + 选择检查点 + 输入起点 - GTID |
| oceanbase | oblog reader | + 选择检查点 + 输入起点 - ObLog Reader heartbeat |
| sqlserver | Change Tracking | + 选择检查点 + 输入起点 - Change Tracking Version |
| Change Data Capture | + 选择检查点 + 输入起点 - LSN | |
| tdsql for mysql | Binlog | + 指定时间为起点 |
如您使用任务统一同步起点,所有映射将会执行您配置的同步起点,映射中的同步起点配置不生效;
同理,使用分映射同步起点,每个映射执行自己的同步起点设置,任务统一同步起点不生效。
:::color3 注意:
- 当任务选择【全量初始化】、【指定起点】或者【激活任务时间为起点】这三个选项后,暂停任务并修改起点配置为【使用暂停时进度】时,重新激活任务页面展示之前的配置内容,但实际仍以【暂停时进度】为起点,执行数据任务
:::
同步起点-Hive数据源
- 同步方式为「增量同步」,「固定步长」。任务执行方式为「定时模式」
- 当数据源表存在分区键时,您可以通过配置“读取起点”和“读取步长”来限定每次定时读取数据的范围。DataPipeline会使用“读取起点”作为初次读取数据的LastMax值,并根据“读取步长”计算读取的范围,实现数据的动态增量读取。“LastMax”表示上一次读取时的最大值。
- 读取起点:表示初次读取数据时的LastMax值。这个值是一个目录名称,结合读取区间来确定初始读取的目录。
- 读取步长:表示每次读取数据时的读取范围。您可以配置“LastMax函数”来实现数据的动态增量读取,同时支持开区间和闭区间。开区间用()表示,闭区间用[]表示。
- 示例一:
- 表示以2023/40周为起点,每次读取后1周的数据。
- 当数据源表存在分区键时,您可以通过配置“读取起点”和“读取步长”来限定每次定时读取数据的范围。DataPipeline会使用“读取起点”作为初次读取数据的LastMax值,并根据“读取步长”计算读取的范围,实现数据的动态增量读取。“LastMax”表示上一次读取时的最大值。
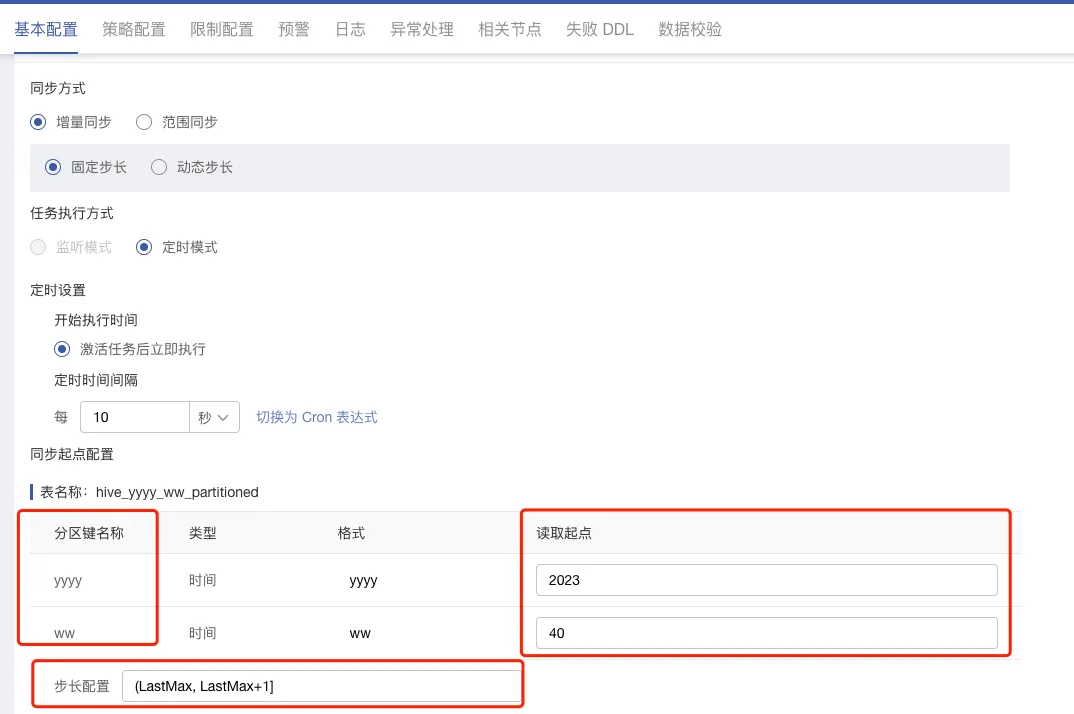
| 分区键名称 | 类型 | 格式 | 读取起点 | 读 |
|---|---|---|---|---|
| 年份 | 时间 | yyyy | 2023 | |
| 周 | 时间 | ww | [LastMax+1,LastMax+2] |
读取步长配置:(LastMax,LastMax+1]
* 根据示例配置的预期读取结果
| 读取次数 | 预期读取结果 |
|---|---|
| 第一次读取 | 2023/40周 |
| 第二次读取 | 2023/41周 |
| 第三次读取 | 2023/42周 |
如果有读取条件如果有过滤条件,则与起点设置求交集。
同步方式为「增量同步」,「动态步长」。任务执行方式为「定时模式」
- 当数据源表存在分区键时,您可以通过配置“读取起点”,实现动态步长的读取,相较于固定步长,动态步长类似JDBC的增量读取方式,可以一次性读取到能读取到的所有增量分区
- 读取起点:表示初次读取数据时的LastMax值。每次读完湖记录上一次的读取起点,并作为下一次的读取起点。
- 当数据源表存在分区键时,您可以通过配置“读取起点”,实现动态步长的读取,相较于固定步长,动态步长类似JDBC的增量读取方式,可以一次性读取到能读取到的所有增量分区
同步方式为「范围同步」,需要定义范围的起点和终点。
- 当数据源表存在分区键时,您可以通过配置“读取起点”和“读取终点”来限定每次定时读取数据的范围。范围同步表示每次读取固定范围的数据。
- 读取起点:表示每次读取数据的起始目录。在此配置中,您应该提供目录的名称,以指定每次读取的起始位置。
- 读取终点:表示每次读取数据的终止目录。在此配置中,您应该提供目录的名称,以指定每次读取的终止位置。
- 当数据源表存在分区键时,您可以通过配置“读取起点”和“读取终点”来限定每次定时读取数据的范围。范围同步表示每次读取固定范围的数据。
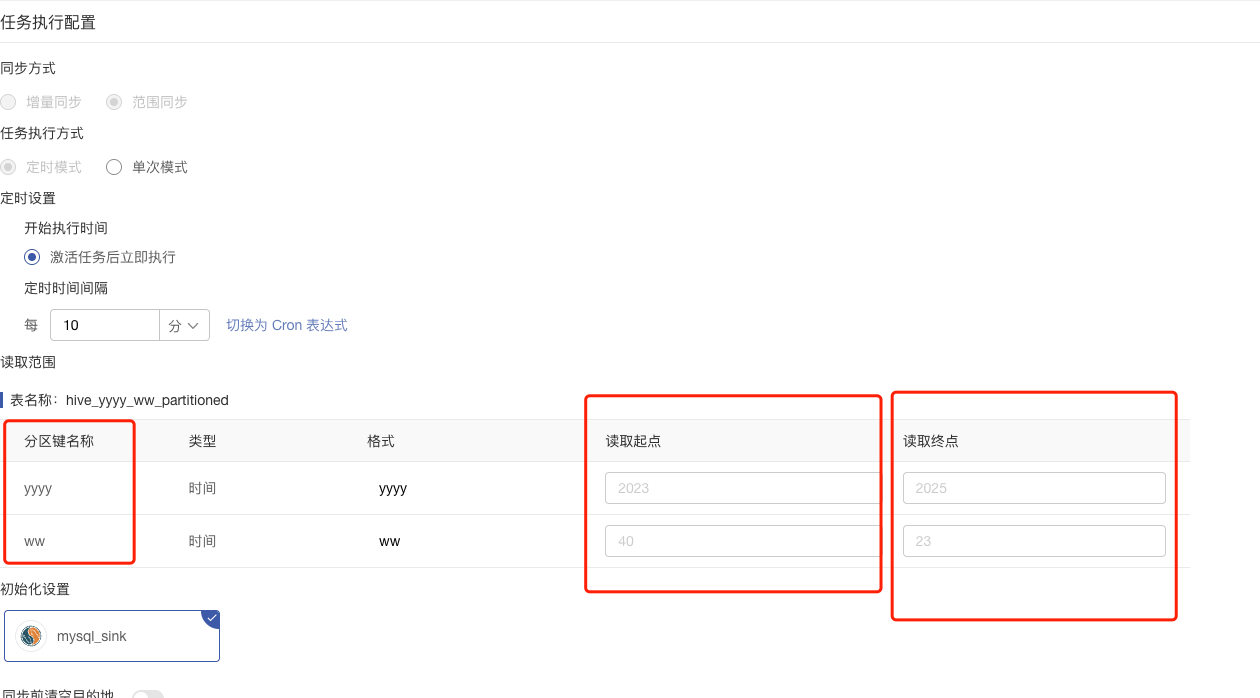
以上图为例,读取起点为2023/40周 读取终点为2025/23周
注意:
当范围同步时,为闭区间。当增量同步时,为左开右闭的区间,
示例:如果定义范围同步,假定起点设置为20010429,终点设置为20010503
计算出timestampPartitionValues:
20010429,20010430,20010501,20010502,20010503
如果是增量同步-固定步长,需要设置起点和固定步长
增量同步-固定步长起点为,lastmax,读取区间为(lastmax, lastmax+固定步长]
如果是如果是增量同步-动态步长,需要设置起点即可
增量同步-动态步长起点为,lastmax,读取区间为(lastmax, lastmax_new],每次读到最新的分区,下一次会从最新的分区的下一个分区开始,为了避免分区重复,因此区间为左开右闭
◎ 批次完成标识
指数据任务完成批次数据同步后,在数据目的地或您指定的环境完成标识。
- 标识生成维度:
- 任务级别生成同步完成标识:指任务内的所有映射都完成数据同步,系统才会生成同步完成标识。
- 映射级别生成同步完成标识:指任务内每条映射完成数据同步后,系统会立即生成相应的标识。
- 标识生成环境:
- 支持您选择数据目的地或非数据目的地节点作为标识生成环境。
- 当前以下节点支持生成完成标识:FTP,SFTP,HDFS,OSS,Mysql,Oracle,DB2,MaxCompute,PostgreSQL,SQL Server,Hive,Inceptor。
- 标识生成方式:
- 标识生成环境为非文件系统时,批量同步完成支持写入标识表。该表需要您按照表结构提示信息提前创建。
- 标识生成环境为文件系统时,批量同步完成支持生成标识文件。您需要指定标识文件生成路径。在标识文件路径中,支持引用「系统配置参数及默认值」中定义的「用户自定义参数」,以及如下参数。参数引用方式为 [$参数名称]。(目前不支持引用“随机数”参数)
| 参数 | 说明 |
|---|---|
| current_ts | 当前时间 |
| sink_table | 目的地表名称 |
| source_table | 数据源表名称 |
| task_id | 任务ID |
限制说明:
- 任务同步方式为增量定时读取模式或全量读取模式时支持配置同步完成标识。
- 当数据目的地为文件系统,配置批次同步完成标识后,数据源读取批次数据完成时DataPipeline将立即向文件系统目的地写入数据文件。即启用同步完成标识后DataPipeline不再按照任务配置的「新建文件大小限制」或「写入时间限制」规则对数据文件进行拆分或合并。
标识表结构定义:
| 字段名称 | 说明 |
|---|---|
| id | 自增ID |
| batch_count | 批次同步数据量 |
| batch_end_time | 批次结束时间 |
| batch_index | 批次序号 |
| batch_start_time | 批次开始时间 |
| batch_time_cost_ms | 批次耗时 |
| created_at | 记录时间 |
| done_mark_type | 标识维度,T 表示任务维度标识,M 标识映射维度标识 |
| mapping_id | 映射id |
| sink_database | 数据目的地数据库名称 |
| sink_node_id | 数据目的地节点id |
| sink_schema | 数据目的地Schema名称 |
| sink_table_name | 数据目的地表名称 |
| src_database | 数据源数据库名称 |
| src_node_id | 数据源节点id |
| src_schema | 数据源Schema名称 |
| src_table_name | 数据源表名称 |
| task_id | 任务id |
标识文件样例:
done_mark_type,M
task_id,21
mapping_id,23
batch_index,3
batch_start_time,2023-08-31 16:53:01
batch_end_time,2023-08-31 16:53:06
batch_time_cost_ms,5000
batch_count,1
src_node_id,2
src_schema,py_auto
src_table_name,sr_test_1
sink_node_id,19
sink_table_name,ys08301/sr_test_1
created_at,2023-08-31 16:53:02
- 标识延迟反馈配置:
- 当前MaxCompute作为目的地时支持生成完成标识的标识延迟反馈配置
- 最长配置的延迟反馈时长为 24 小时,默认值为 0,即不延迟反馈
- 配置延迟反馈时长后,将根据延迟反馈时长的配置,延迟写入标识表。
操作步骤
◎ 配置全量同步
- 在任务详情页点击基础配置,进入基础配置 Tab;
- 在任务执行配置中,配置读取方式和同步方式;
- 配置方式选择全量同步;
- 任务执行方式
- 定时模式:
- 指定任务首次执行时间
- 指定任务定时频率;
- 单次模式:任务激活后仅执行一次全量同步;
- 定时模式:
- 配置数据目的地全量初始化:
- 清除数据(truncate & insert)
- 删除重建(drop & create)
- 配置批次完成标识。
◎ 日志读取模式(CDC)下配置增量同步
- 在任务详情页点击基础配置,进入基础配置 Tab;
- 在任务执行配置中,配置同步方式;
- 选择读取方式为日志读取模式(CDC),选择增量同步;
- 选择任务执行方式
- 监听模式
- 定时模式
- 指定任务首次执行时间
- 指定任务定时频率;
- 选择同步起点;
- 全量初始化:即增量同步之前先进行全量数据同步,将数据目的地数据覆盖
- 您可在下方配置每个数据目的地的全量初始化方式
- 清除数据(truncate & insert);
- 删除重建(drop & create);
- 您可在下方配置每个数据目的地的全量初始化方式
- 指定起点:即直接进行增量数据同步,不对数据目的地数据进行操作
- 此选项需要您指定增量同步读取起点
- 以 MySQL 增量同步监听模式即 Binlog 读取模式为例,需要填写:\ a. Binlog Position\ b. Binlog 文件名称\ c. GTID
- 当数据源节点在节点策略配置中开启检查点策略,您可通过系统指定同步起点,即在进行增量同步之前不进行全量同步的情况中,在日志增量获取模式下指定日志读取起点,以明确数据从哪个 snapshot 开始同步。检查点策略详见:检查点策略
- 激活任务为起点
- 即从激活任务的时间点开始读取数据源当前产生的日志
- 任务暂停后,可选择「使用暂停时进度」
- 全量初始化:即增量同步之前先进行全量数据同步,将数据目的地数据覆盖
◎ JDBC 读取模式下下配置增量同步
- 在任务详情页点击基础配置,进入基础配置 Tab;
- 在任务执行配置中,配置同步方式为增量同步;
- 配置读取方式为JDBC;
- 进行定时配置:
- 指定任务首次执行时间;
- 指定任务定时频率;
- 选择同步起点,可使用统一起点配置或者分映射起点配置;
- 全量初始化:即增量同步之前先进行全量数据同步,将数据目的地数据覆盖;
- 您可在下方配置每个数据目的地的全量初始化方式
- 清除数据(truncate & insert);
- 删除重建(drop & create);
- 您可在下方配置每个数据目的地的全量初始化方式
- 指定起点:即直接进行增量数据同步
- 此选项需要您指定增量同步读取起点
- 以 MySQL 增量同步监听模式即 Binlog 读取模式为例,需要填写:\ a. Binlog Position\ b. Binlog 文件名称\ c. GTID
- 当数据源节点在节点策略配置中开启检查点策略,您可通过系统指定同步起点,即在进行增量同步之前不进行全量同步的情况中,在日志增量获取模式下指定日志读取起点,以明确数据从哪个 snapshot 开始同步。检查点策略详见:检查点策略
- 激活任务为起点
- 即从激活任务的时间点开始读取数据源当前产生的日志
- 任务暂停后,可选择「使用暂停时进度」
- 全量初始化:即增量同步之前先进行全量数据同步,将数据目的地数据覆盖;
- 任务暂停后,修改增量任务执行配置中的全量初始化开关、增量读取起点等配置,任务将会按照您修改后的执行配置方案重新执行,可能会覆盖已同步数据;
- DB2 数据节点作为数据源时,执行任务全量数据同步,DataPipeline 将标记任务对应订阅同步方式及同步状态为 refresh;
- DB2 数据节点作为数据源时,执行带有全量初始化的增量数据同步任务,DataPipeline 将标记任务对应订阅同步方式为 mirror,订阅中每张表的同步状态为 refresh;
- DB2 数据节点作为数据源时,执行带有全量初始化的增量数据同步任务,DataPipeline 将标记任务对应订阅同步方式为 mirror,订阅中每张表的同步状态为 active(即 mark a table capture point)。
◎批量数据同步完成后生成标识文件
- 在任务详情页点击基础配置,进入基础配置 Tab;
- 配置同步方式为增量同步,任务执行方式为定时模式。或配置同步方式为全量同步。
- 选择需要生成完成标识的目的地,开启「生成同步完成标识」开关。
- 定义标识生成维度。
- 定义标识生成环境。
- 定义标识生成方式。
- 方式一:同步完成后将同步完成信息写入标识表。首次使用该功能时请点击「查看标识表创建语句」,按照页面提示的建表语句在标识生成环境创建标识表。创建完成后请点击「选择标识表」进行表选择。
- 方式二:同步完成后生成同步完成标识文件。需要定义输入标识文件生成路径与标识文件名称。
- 定义标识延迟反馈配置。
全量初始化清空目的地
| 数据目的地 | 清空目的地方式 |
|---|---|
| ArgoDB | 清除数据(truncate & insert) |
| TDSQL MYSQL | 清除数据(truncate & insert) |
| StarRocks | 清除数据(truncate & insert) |
| Paimon | 清除数据(drop & create) |
| Gbase 8a | 清除数据(truncate & copy )、删除重建(drop & create) |