2022年(含以前)版本更新日志
v3.6
金黄稻谷千层浪,累累瓜果十里香,在这个收获的季节,我们迎来了 DataPipeline 3.6 版本的发布。
版本目标
- 数据校验功能支持
- 自研 CDC 产品能力增强
- 故障治理体系建设
在 3.6 版本中,围绕版本目标,新增了数据校验功能,用户可以在 DataPipeline 数据融合产品内部对数据质量情况进行检查;Oracle Agent 支持了较低级别的日志补全进行数据同步的功能,一定程度上降低了对数据库的压力;整体上,我们统一了报错日志的格式,针对每个报错类型,提供故障处理指南,引导用户进行正确的操作,以便快速恢复任务运行。我们也做了一些其他优化,支持 JDBC 写入 Inceptor 的多种存储(ES/Hyperbase/Hive 存储)、丰富了任务级别的预警指标等。
新增功能
新增功能:支持通过指定分片字段拆分 JDBC SQL 多并发读取的全量数据获取方式
功能背景
在将业务系统数据同步至分析系统时,全量数据铺底往往是最先进行的必要步骤。在全量数据同步过程中,同步工具通常会向数据源提交一个快照请求,用于做增量数据与全量数据的衔接。
在数据库中,快照数据会占用表空间。当全量数据较大或可用表空间较小时,会给数据库带来较大压力,且可能会因为快照读取速率慢导致暂存时间过久超过数据库表空间允许的缓存时间,导致读取报错。
通过快速将全量数据读取出来,虽然短时间内会占用更多的数据库连接,增加部分查询引擎的压力,但综合来看,还是在数据同步场景中最有效的降低数据库压力的方式。
在 DataPipeline 产品中,通过指定分片字段,可以拆分多个读取 SQL,多并发的读取大表的全量数据,加速数据同步。
使用场景
同步场景:
- 使用 JDBC 读取方式的全量数据获取
- 增量数据获取的全量初始化阶段
对于数据表数据量较大、且数据表有分布较均匀的可用分区字段(如数字类型自增主键、字符类型订单编号等)
功能说明
新增功能:支持错误队列规则配置与展示
功能背景
在历史版本中,我们支持了错误队列暂停设置、激活设置、回收设置等配置选项,但没有具体的错误队列校验内容的设置。
在新版本中,我们添加了对每个字段进行的非空校验自定义设置,并将当前校验错误类型与字段的关系完整展现到页面中。
使用场景
场景 1:出现错误队列,无法判断错误队列产生原因,可以在页面中查找错误队列产生原因。
场景 2:向数据目的地业务逻辑上不能为空的字段写入空值数据,产生数据错误,可以对该字段类型配置非空错误校验条件。
功能说明
错误类型说明
| 错误类型 | 说明 |
|---|---|
| 数据过长 | 数据超过数据库支持的精度设置 |
| 非法数据格式 | 向某字段写入非该字段类型的数据,且目的地无法兼容 |
| 数据越界 | 数据精度标度越界 |
| 非空约束 | 向非空约束字段写入空值 |
| 非法数据内容 | 向字段写入不兼容的数据内容 |
| 高级清洗错误 | 高级清洗脚本错误产生的错误数据 |
| 主键为空错误 | 主键字段为空,无法写入 |
| 主键/唯一索引冲突错误 | 写入数据时,发生主键/唯一索引冲突 |
| 未知错误 | 未知错误数据类型 |
- 错误队列策略会根据错误规则对数据进行校验,并对校验为错误数据的数据执行任务暂停策略和错误堆栈信息存储策略。
- 您可以自定义错误规则并管理系统默认错误规则,也可以配置当检测到错误数据时任务的相关策略。\
- 错误队列类型可分为预校验错误类型与后校验错误类型。
- 预校验错误类型指系统在写入目的地之前执行数据检验,将无法写入的错误数据写入错误队列,包括数据过长错误、非法数据格式错误、数据越界错误、非空约束错误、非法数据内容错误。
- 后校验错误类型指系统在尝试写入失败后无法处理的错误数据,这部分数据会被写入错误队列,包括高级清洗错误、主键为空错误、未知错误。
新增功能:支持错误日志编码,提供故障处理指南
功能背景
在故障发生后,快速找到错误的原因,快速定位问题,指导上游系统做出正确的业务判断,尽快恢复业务,是减少客户损失的重要手段。
DataPipeline V3.6 统一了报错日志格式,针对每个报错类型,提供故障处理指南,引导用户进行正确的操作,以便快速恢复任务运行。
使用场景
当数据任务发生错误时,定位错误并恢复任务运行的过程。
功能说明
- 在任务错误日志中可以找到对应的错误编码
- 根据错误编码查找故障处理指南
- 根据指南中的解决办法解决问题
- 如遇未知错误类型,可以及时寻找 DataPipeline 技术专家协助解决问题,DataPipeline 产品团队与服务团队将会将处理过的未知错误类型与解决办法记录至故障处理指南中。
新增功能:支持数据条数校验(Oracle、Inceptor、ES、OushuDB、DB2、PG、DM 节点)
功能背景
DataPipeline 作为企业级的数据融合平台产品,数据质量管理尤为重要。在用户使用 DataPipeline 过程中,有时会出现数据丢失情况。由于产品前期未提供同步数据质量管理功能,导致用户无法直接得知数据质量情况,丢失数据的信息往往是由下游数据使用方反馈,用户无法主动对数据质量情况进行把控,丢失数据处理也变得被动且滞后。
V3.6 版本基于数据任务提供数据条数校验功能,是 DataPipeline 产品继数据融合之后,在数据管理领域的持续探索。
使用场景
V3.6 版本支持全量数据校验,但无论数据任务执行方式是增量还是批量,数据源的数据往往是实时变化的,在这种情况下,直接校验全量数据得到的校验结果通常都存在差异(由于同步速率导致在同一时刻数据源与数据目的地数据不一致)。
所以,V3.6 版本数据校验适用于以下场景:
- 数据源与数据目的地数据均无变动,这种场景下可以进行全量数据条数校验,且能够获得准确的校验结果。
- 数据源与数据目的地均有校验条件限制字段,如数据写入时间字段。以时间为条件限制校验范围,如校验该时间五分钟前的数据。
功能说明
- 目前仅支持基于数据任务来添加校验任务,即无法校验不是由 DataPipeline 同步的数据。
- V3.6 版本支持数据量校验,即校验数据源与数据目的地的条数是否一致。
- 支持校验的数据节点:Oracle,Inceptor,ES,OushuDB,DB2,Postgresql,DM、Mysql。
- 支持用户输入校验条件(where 条件语句)来限定校验范围。
- 支持配置预警策略,获取校验结果通知,以及校验异常通知。
- 支持查看校验历史结果。
新增功能:支持 JDBC 写入 Inceptor 的多种存储(ES/Hyperbase/Hive 存储)
功能背景
星环科技作为一家企业级大数据基础软件开发商,致力于围绕数据的集成、存储、治理、建模、分析、挖掘和流通等数据全生命周期提供基础软件与服务。TDH 作为星环的大数据基础平台,支持 9 种存储引擎,能够自动化应对不同部门的业务需求。
DataPipeline 在 3.6 版本,基于某证券客户业务需求,支持 TDH 新建表时选择 Hive、Hyperbase、Elasticsearch 三种不同存储引擎,在支持用户更多使用场景、推进国产化适配的进程上更进一步。
功能说明
当数据目的地为 Inceptor 时,DataPipelineV3.6 版本支持通过 JDBC 方式创建底层存储为 Hive、Hyperbase、Elasticsearch 类型的表。且在选择已有表时,支持通过 JDBC 方式写入类型存储为 Hive、Hyperbase、Elasticsearch 的表。
功能优化
功能优化:增强 Oracle Agent 同步数据的能力:支持 Oracle 最小附加日志、主键补全、唯一键补全日志级别数据同步
功能背景
Oracle 补全日志可以在数据库级别设置,也可以在表级别设置。在数据库级别中,补全日志按补全的信息量,对应几个级别:
(1)最小附加日志(Minimal supplemental logging):是开启 logmnr 的最低日志要求,提供了行链接(chained rows)和多种数据存储(比如聚簇表、索引组织表)的信息。在 Oracle 9.2 之后的版本中,默认都不开启。
(2)主键补全(Primary key supplemental logging):在日志中补全所有主键列。如果表中无主键,则补全一个非空唯一索引列;如果非空唯一索引键也没,那么会补全除了 LOB 和 LONG 类型字段以外的所有列,这时就和下面的所有补全一样了。
(3)唯一键补全(Unique key supplemental logging):当唯一键列或位图索引列被修改时,在日志中补全所有唯一键列或位图索引列。打开唯一键补全也会同时打开主键补全。注意这个级别是需要条件触发的。
(4)外键补全(Foreign Key supplemental logging):当外键列被修改时,将在日志中补全所有外键列。这个级别也是需要条件触发的。
(5)所有补全(All supplemental logging):在日志中补全所有字段(排除 LOB 和 LONG 类型)。
在历史版本中,DataPipeline 的采集代理读取方式与 LogMinner 读取方式仅支持所有补全(All supplemental logging),在数据源 Oracle 数据库本身的业务压力比较大时,开启 ALL 级别日志补全也会给数据库服务带来比较大的压力。
因此,我们在新版本中支持了较低级别的日志补全进行数据同步的功能
使用场景
当您使用 Oracle 数据源时,在数据库配置过程中需要开启日志补全功能,补全 redo log 日志文件;DataPipeline 通过解析日志文件获取增量数据,同步至下游。
如 Oracle 数据源业务压力较大,经您的数据库管理员(DBA)评估,无法开启 ALL 级别日志补全时,可以使用最小附加日志、主键补全、唯一键补全日志级别进行数据同步。
如 Oracle 数据库中有数据表 A,表结构如下
| 字段 | 字段说明 |
|---|---|
| id | PK |
| customer_id | 业务主键 |
| order_id | 唯一索引 |
| order_type | |
| price | |
| order_ts | 业务主键 |
当上游发生业务变更,可以获取到的增量数据说明:
| 日志级别 | 业务数据变更 | 可获取的增量数据说明(不包含元数据信息) |
|---|---|---|
| Primary key supplemental logging | update A set price = 300 where id = 1222 | id = 1222,price = 300 |
| Unique key supplemental logging | update A set price = 300 where order_id = 1222 | order_id = 1222,price = 300 |
| Minimal supplemental logging | update A set price = 300 where id = 1222 | price = 300 |
| All supplemental logging | update A set price = 300 where customer_id = 1222 and order_ts = 1667445833 | id = 1222,customer_id = 1222,order_id = 1222,order_type = 1,price = 300,order_ts = 1667445833 |
根据可获取的增量数据,数据目的地可以执行的更新操作的依赖条件取决于日志内容,存在部分使用限制。
功能说明
当数据源需要同步的数据表有主键、唯一索引时,开启对应级别的日志补全,支持更新/删除 DML 同步。
当数据源需要同步的数据表没有主键、唯一索引时,开启非所有补全的日志补全级别,仅支持数据插入 DML 同步。
当数据源需要同步的数据表没有主键、唯一索引时,推荐开启 ALL 级别日志补全,通过逻辑主键功能指定业务主键,支持更新/删除/插入 DML 同步。
对不同的日志补全级别,可能存在不同的使用限制,使用此功能之前,请阅读 Oracle 数据源通过非 ALL 级别日志补全进行增量数据同步功能的使用限制说明,并合理评估数据源业务压力,选择合适的数据补全级别,以满足业务要求。
丰富任务预警指标:实时流量和读取速率预警
功能背景
DataPipeline 作为一款企业级数据融合产品,为了便于用户及时发现处理任务运行过程中出现的业务问题,我们会持续加强预警指标体系建设。DataPipeline 3.6 版本新支持了读取实时流量预警、读取速率预警的指标。
功能说明
读取实时流量预警对监控时间段内、指定表的读取数据量的变化进行监控。监控时间段内,当读取数据量的变化达到告警阈值时,发送告警。仅支持日志解析增量监听 / 增量定时读取、kafka 增量定时读取、MongoDB 增量监听读取支持配置此预警,其他情况配置此预警不生效。
读取速率预警对监控时间段内、指定表的读取速率进行监控。监控时间段内,当读取速率达到告警阈值时,发送告警。
Kafka 功能增强
功能背景
在数据实时处理需求日益旺盛的情况下,Kafka 作为高吞吐量、低延迟,持久性好的消息中间件被广泛使用,在我们的客户群里中,有大量客户使用 DataPipeline 将 Kafka 节点作为数据源或作为数据目的地同步数据,所以 Kafka 数据同步的速率、时效性尤为重要。在往期版本中,DataPipeline 不支持配置 Kafka Consumer 参数以及 Producer 参数,导致当出现写入速率慢、连接超时等通过可以调整参数解决的问题时,无法通过配置解决,需要修改代码解决。
使用场景
在数据同步过程中,需要人为定义或调整 Kafka Consumer 参数或 Producer 参数,例如以下常见场景:
- Kafka 节点连接超时
- Kafka 目的地写入速率慢
- 写入 Kafka 目的地时使用自定义的分区器
- 指定写入 Kafka 目的地的消息压缩格式
功能说明
V3.6 版本支持在数据节点配置 Consumer 参数以及 Producer 参数,将分别在 Kafka 作为数据源以及 Kafka 作为数据目的地时生效。
同时当 Kafka 作为数据目的地,支持用户在每条数据映射配置 Consumer 参数。
其他优化与问题修复
- 支持配置日志级别
- Kafka 节点支持配置连接参数
- 创建目的地表时默认创建主键
- 同一资源组不支持有多个 Kerberos 配置文件(kdc 不同)
v3.5
晴日暖风生麦气,绿阴幽草胜花时。在这个热情的季节里,DataPipeline 在 2022 年 8 月迎来了 V3.5 版本更新。
版本目标
- 多元异构与国产信创支持
- 登录安全性增强
在 3.5 版本中,我们围绕着多元异构与国产信创支持和登录安全增强的目标,新增支持了 ES 数据节点、OushuDB 数据节点、TDH Hyperbase 数据目的地,达梦支持 logmnr 读取、DB2 支持 JDBC 读取;根据业务需要,新增逻辑主键功能、优化项目分组权限与交互、新增了 DDL 预警、映射同步状态预警;同时,在安全性方面,增加了登录验证和超时退出功能。
新增功能
支持 TDH Hyperbase 数据目的地
功能背景
Transwarp Hyperbase 是星环科技自主研发的实时 NoSQL 宽表数据库。Hyperbase 支持百万级高并发、毫秒级低延时业务需求,可以在普通廉价服务器集群上高效支持企业的高并发精确查询与范围查询、流处理应用、全文搜索以及高并发非结构化数据检索,同时支持以标准 SQL 为接口的高效数据访问,帮助用户快速开发历史数据查询、业务在线检索等应用。
功能说明
DataPipeline 3.5 版本支持 TranSwarp 6.x.y 版本 Hyperbase,通过 JDBC 方式连接到 Inceptor Engine 对 Hyperbase 进行数据写入。支持 Hyperbase 内表以及 Hyperdrive 内表两种表类型。由于 Hyperbase 的 rowkey 直接决定了数据查询效率,所以 rowkey 的配置十分关键。在向 Hyperbase 写入数据前,您需要使用高级清洗指定 Hyperbase rowkey 的写入逻辑。
支持 Elasticsearch 数据源和数据目的地
功能背景
Elasticsearch 是一个分布式、高扩展、高实时的搜索与数据分析引擎。它能很方便的使大量数据具有搜索、分析和探索的能力。充分利用 Elasticsearch 的水平伸缩性,能使数据在生产环境变得更有价值。
功能说明
DataPipeline 3.5 版本支持 6.x、7.x 版本的 Elasticsearch 数据源以及数据目的地,以 Java REST Client 方式对 Elasticsearch 进行数据批量读取和写入。当 Elasticsearch 作为数据源时,DataPipeline 能够解析索引的嵌套结构,支持配置 query 参数作为数据同步条件;当 Elasticsearch 作为数据目的地时,DataPipeline 能够支持将数据写入索引已有的嵌套结构。
支持 OushuDB 数据源和目的地
功能背景
OushuDB 是由 Apache HAWQ 创始团队打造的新一代云原生数据仓库,是 Apache HAWQ 的企业增强版,该产品采用了存储与计算分离技术架构,具有 MPP 的所有优点,还具有弹性,支持混合工作负载和高扩展性等优点。 同时支持公有云与私有云。高可扩展,遵循 ANSI-SQL 标准,具有极速执行器,提供 PB 级数据交互式查询能力。并且提供对主要 BI 工具的描述性分析支持和高级机器学习功能。兼容 Oracle,GPDB 和 PostgreSQL,可以轻松取代传统数据仓库包括 Teradata,Oracle,DB2,Greenplum 和 SQL-on-Hadoop 引擎。并且原生支持 Kubernetes 容器平台,帮助企业无缝迁移到最新的云计算平台。OushuDB 已在金融、电信、制造、医疗和互联网等行业得到广泛的部署和应用。
功能说明
DataPipeline 3.5 版本支持通过 JDBC 连接到 OushuDB 进行读写,同时支持通过 HDFS 协议写入到 OushuDB 的外部表。目的地支持新建 AO、ORC、PARQUET 格式的内表以及 TEXT、CSV、ORC 格式的外表。也支持在目的地手动指定逻辑主键
DDL 预警、映射同步状态预警
功能背景
DataPipeline 作为一款企业级数据融合产品,监控、预警功能将持续予以优化,以满足用户复杂业务场景下对数据、对系统的安全需求。
使用场景
DataPipeline3.5 版本新支持了数据源 DDL 预警指标,以及同步状态预警指标。配置 DDL 预警指标后系统将自动识别数据源发生的结构变化,以及数据目的地将触发的操作,以消息的形式通过指定方式发送给用户,使用户能够及时了解上游的结构变化,对下游结构调整迅速做出决策。同步状态预警便于用户及时掌握当前的数据同步动态。
功能说明
DataPipeline3.5 版本 DDL 预警支持用户配置预警方式、预警人、以及预警时间段,当数据源发生结构变化后,将以用户配置的预警方式推送预警消息。同步状态预警支持监控增量同步的数据连续性,支持监控全量同步无完成情况,以及批量同步的批次完成情况。
逻辑主键
功能背景
DataPipeline 作为一款企业级数据融合产品,面向客户众多,客户实际数据融合场景复杂,存在利用自定义业务主键同步数据的需求。基于 3.4 及以往版本只能使用主键,用户无法自定义业务主键的情况,3.5 支持为部分数据节点配置业务主键,用户可以使用业务主键进行同步,又不影响表的实际结构。
使用场景
- 数据目的地存在主键,但实际同步场景希望使用自定义的业务主键进行增量数据同步。
- 数据目的地不存在主键,希望指定字段作为更新键进行数据增量同步。
功能说明
- 3.5 版本支持为以下节点配置逻辑主键:Oracle、Mysql、DB2、Elasticsearch、Maxcompute、Inceptor、oushudb。
- 3.5 版本配置逻辑主键后,会自动使用逻辑主键作为更新键来同步增量数据。
- 逻辑主键支持为已有表及新建表指定。
- 逻辑主键支持指定非空字段。当非空字段作为更新键报错时,该条数据将进入错误队列。
超时无动作退出登录
功能背景
DataPipeline 作为一款面向企业的数据融合产品,尤其是在金融、保险等对数据安全要求高的业务中,安全性至关重要。为了增强系统安全,避免登录身份被冒用,我们提供了超时登录功能。
使用场景
系统统管理员可以根据需要,设置无操作退出登录的超时时间。
功能说明
系统提供超时无动作退出登录的功能,当页面无操作时长超过设置时间,系统会退出登录。
项目分组优化
功能背景
DataPipeline 作为企业级的数据融合平台产品,其可管理性尤为重要,为了满足企业级的可管理性的需求,在本版本中提供了对数据节点和数据链路内项目分组的功能。
使用场景
创建节点,链路或任务时,可以直接选择项目分组。将对应的实体创建到指定分组中,满足企业级的管理要求。
功能说明
项目组权限:项目组相较于 V3.4 版本及以前的功能,将取消权限。即项目组对所有的用户均有权限,用户只是对于项目组内具体的实体(节点,链路,任务)有对应权限(编辑/查看)。
项目组信息展示,在项目组上,将会增加项目组内实体数量的统计(K/L),其中 K 表示登录用户在该项目组中有权限的实体的数量,L 表示项目组内所有的实体的数量。
项目组的创建,编辑和删除:仅管理员拥有权限,可以创建,编辑,删除资源组。支持项目组设置为默认项目组,这样当在全部项目的功能模块下,创建实体的时候,会优先在默认项目组中创建。
实体的移动,支持对实体进行移动分组的操作,用户可以选定实体后,批量的移动到指定项目组里。
功能优化
资源控制优化
功能背景:
任何成熟的集群系统,计算资源都是有限的。在 V3.4 版本之前,DP 的资源模型是在有限的资源下,无限制的提交任务,这必然会给用户带来极大的风险。因此在 V3.5 版本中,对于资源使用模型进行了第一阶段的优化。主要优化内容为,可以通过资源组设置线程使用上限,这样避免任务无限提交,导致同时处于工作状态的线程过多,而造成 gc,oom 等问题。
使用场景:
在业务系统运行过程中,可以监测每个 worker 的线程使用情况,以及每个任务的线程使用情况。可以方便快速的获取到任务的状态,从而判断业务是否正常,系统是否健康,是否有风险。同时产品支持动态调整线程上限,用户可以根据业务的情况,动态调整定时和实时的资源使用情况,避免因为资源紧张导致某类任务起不来。或者可以提示,当前资源紧张,如果在启动任务,可能会给系统带来系统级的不稳定风险,建议用户关掉一些不重要的任务,或者选择扩容。
功能说明
本功能将主要实现以下几点:
1 允许提交线程的动态调整。当发现实时或者定时的资源不足时,可以根据对 worker 节点的资源判断,动态调整资源分配。
2 当使用的线程已经达到允许线程的上限的 90%,则新发起的线程需求,将进入到争抢机制。会以一定的概率抢到资源,等待时间越久,抢到的概率会越高。目前提供的默认抢占概率为超过 20 分钟,线程可以被执行的概览为 50%,当等待时间超过 50min 时,概率为 90%。当然数值可以根据业务需求去设置和调整,同样为动态生效。
3 如果线程被全部占满,则在提交的线程会进入到等待队列中,当有资源释放的时候,会按照概率获取资源执行。
4 在任务列表和任务提交时,均提供线程的使用情况,方便用户判断系统的资源情况。
其他优化与问题修复
- 适配了适配百度智能云 BMR Hive 3.1.0
- 支持达梦数据节点 logmnr 数据读取方式
- 添加登录验证码校验
- 完善高级清洗脚本库模版
- 支持 IBMDB2 节点作为数据源时 JDBC 读取方式
v3.4
东风洒雨露,会人天地春。DataPipeline 在 4 月迎来了 V3.4 版本更新。\ 在 3.4 版本中,我们对数据结构变化场景、数据一致性场景等数据同步过程中的核心技术进行了增强;同时对索引、字符集、注释等数据语义特性
版本目标
- 增强 DDL 处理能力
- 增强数据语义处理全面性
新增功能
新增 Create table、Truncate table、Rename Column DDL 对应的结构变化策略
功能背景
DDL 的处理能力是产品的一大核心竞争力。也是业界在异构数据库的同步场景中,最难处理和解决的一部分。同时我们也看到在信创的大背景下,能否处理 DDL,也逐渐成为了数据同步中间件产品的入门门槛。而不断提升多元异构的处理能力,也一直在 DataPipeline 的长期发展的路线图中,因此在多方面需求的背景下,我们在 3.4 版本,迎来了 DDL 结构变化处理的里程碑式的增强。
使用场景
当上游发生了各种 DDL 变化时,下游需要根据 DDL 的类型,甚至具体的 DDL 变化,来做相应的处理。因此 DataPipeline 针对 DDL 从源端解析获取,再到目的地端执行,提供一整套完备的处理机制和流程。来满足用户对于上游发生 DDL 变化的各种处理。\ 1 如何获取 DDL?\ 在 V3.4 版本中,对于 create table ,rename column,truncate table,采用了日志解析的方式感知。而对于 add column ,drop column,alter table(字段类型,精度,标度变化),则仍然沿用之前的 schema diff 的方式感知,drop table 则采用定时请求的方式获取。从这里可以看出 DP 已经提供了多样的方式感知源端的 DDL 变化。未来也会更多的从日志中解析 DDL 变化,从而更早的感知到来自于源库的所有 DDL 变化。\ 2 目的地针对 DDL 变化的执行策略有哪些?\ 当上游的 DDL 变化被 DP 的采集系统感知到后,会发送到下游进行 DDL 变化的处理。DP 根据数据库的特性以及企业管理应用,提供了 3 种处理模式。 第一种当发生该 ddl 变化后,暂停任务,由业务人员确认,是否要应用。这主要面对管理要求严格的业务线。对于数据库的元数据管理有着严格管控要求的业务线。 第二种当发生该 DDL 变化后,忽略。此时任务将忽略该 DDL 变化,继续同步。这主要是下游系统有很严格的管理要求,同时,下游明确知道此阶段或者此任务上游可能处于会增加与我业务系统不相关的冗余字段或者冗余变化。那就可以采用忽略的策略。 第三种当发生该 DDL 变化后,在下游执行该 DDL 变化。这主要是上下游系统要求做备份,或者要完全 copy 一份 ods 层的数据,因此希望提供一份与上游有相同变化的数据。此时可以采用执行该 DDL 变化。\ 3 如果 DDL 执行失败如何处理?\ 当通过系统在目的地执行该 DDL 变化,可能由于权限原因,或者数据库目的地锁的原因,发现无法执行成功时,该执行失败的 DDL 会记录在任务的 DDL history 里,您可以手动在下游数据库执行后,在这里忽略掉该 DDL 变化,然后继续执行任务。避免失败的 DDL 阻断同步任务进行。
功能说明
本版本中,将增强 Mysql 和 oracle 的 DDL 解析能力,可以通过日志解析获取到 Create table,Truncate table,rename column 三种 DDL 的变化。而在目的地则在原有基础上,加强了文件系统,以及 NoSQL 类型数据库的 DDL 处理能力。详情可以参见 DDL 结构变化说明。
Exactly Once 一致性支持(Beta)
功能背景
在数据同步过程中,数据一致性通常包括两种形式:
- 完整一致性(Exactly once)
- 最终一致性(At least once)\ 通常情况下,数据同步工具提供最终一致性支持,即可满足大部分业务场景要求,即至少向目的地写入一次增量数据,重复写入由目的地数据库的主键/唯一键保证结果幂等;在数据同步领域内,各厂商默认提供最终一致性功能。\ DataPipeline 在之前的版本中,在功能逻辑层面提供了最终一致性的数据保障;但深挖本源、技术驱动的企业灵魂告诉我们,在技术上不断突破、提升,提供更好的技术方案保障客户数据任何情况下完整一致是我们不懈的追求。\ 因此,端到端一致性策略跟大家见面了。
使用场景
在数据源与目的地都有主键/唯一键的情况下,如发生部分增量数据重复执行,如一条 update 被执行两次,数据源与目的地数据是幂等的,即最终一致性(At least once)是可以被保障的;在您将数据写入数仓、数据平台以供数据分析使用的场景中,可以不开启端到端一致性选项,产品默认保证数据的最终一致性。\ 在数据源数据与目的地数据都要求严格时序一致,不能出现重复执行数据更新等场景时,完整一致性(Exactly once)功能是必须的,您可以开启端到端一致性选项,保障数据一致性。
功能说明
在数据任务增量数据同步执行过程中,实时数据处理将被转换为一个一个连续的小 batch,每个 batch 的读取写入都以应用事务机制保障。\ 当读取写入任一环节出现失败情况,事务被回滚,任务会从之前的记录进度位点开始下一次事务读取写入。\ 在一个 batch 中,事务机制需要持久化读取进度与写入进度,对于关系型数据库目的地,进度将被持久化至目的地数据表;对于文件系统目的地,进度将被持久化至系统关系型数据库组件。\ 对于文件系统目的地,每个 batch 的数据会先被写入至临时数据目录,当完成全部读取与写入后,临时数据目录文件将会被挪移至正式目录,并在系统中持久化写入进度。\ 因此,对于不同类型的数据目的地,配置项会有所不同。\ 详情参见 huan-cun-ce-lve-1.md
数据映射支持配置目的地表索引
功能背景
持续提高对多元异构的节点支持是产品持续的发展路线,对于表特性来说,索引作为重要的语义特性,可以提高数据检索速度、保证数据的唯一性、并可以实现表仪表之间的参照完整性。在很多客户的实际场景中的表都建有索引。在之前的版本中,只支持部分节点的主键、唯一索引的同步,新版本对不同的数据节点的特性进行了支持,不仅支持了不同节点的多种索引类型,也支持了多种索引存储方式如 hash 索引、B-tree 索引等。
使用场景
当数据源的表有索引时,能够完整的同步相关索引到目的地,并可以对目的地新建表创建索引,保证表同步前后的一致性和完整性。
功能说明
DataPipeline 支持部分类型节点的表索引的同步,并支持新建表索引。同时提供了索引同步策略,以提高一些全量同步场景下的同步效率。\ 数据源索引:\ 支持节点类型:MySQL、Oracle、PostgreSQL、MS SQL Server、Db2、TiDB、Teledb、HashData、AWS RDS for PostgreSQL\ 当上述节点作为数据源时,支持读取相关数据源的索引信息及索引变化。\ 数据目的地索引:\ 支持节点类型:MySQL、Oracle、PostgreSQL、MS SQL Server、Db2、Greenplum、TiDB、openGauss、Gauss 200、Telepg、AWS RDS for PostgreSQL、Amazon RedShift\ 新建表:当上述节点作为数据目的地时,支持根据源端索引信息自动映射目的地索引信息,并支持新建和编辑索引信息。\ 选择已有表:当上述节点作为数据目的地时,支持读取相关目的地索引信息及索引变化。
数据映射支持字符集映射
功能背景
在过去的版本中,DataPipeline 处理写入目的地数据字符集的方式是将数据编码为目的地节点字符集,这样的处理方式能够保证写入目的地数据不乱码。但部分节点如 MySQL、Tidb、Teledb,支持灵活配置表级别、字段级别字符集,这种情况下如果表或字段的字符集与节点字符集不一致,可能发生数据写入失败的情况。
使用场景
为全面支持语义特性,DataPipeline3.4 版本支持配置 MySQL、Tidb、Teledb 节点表级别,以及字段级别的字符集。
功能说明
3.4 版本支持对 MySQL、Tidb、Teledb 目的地进行表级别、字段级别的字符集配置。DataPipeline 提供对字符集映射的默认规则 。\ 对于无表级别字符集的数据节点,如 ORACLE、MYSQL、PostgreSQL 等节点,DataPipeline 写入数据时会根据目的地节点字符集自动编码数据,无需人为操作。\ 对于文件类型数据节点,DataPipeline 支持配置文件写入的编码方式。
新增支持达梦 8 数据节点
功能背景
DM8 是达梦公司在总结 DM 系列产品研发与应用经验的基础上推出的新一代自研关系型数据库。DM8 融合了分布式、弹性计算与云计算的优势,在灵活性、易用性、可靠性、高安全性等方面进行了大规模改进。另外,多样化架构可以充分满足不同场景的需求,支持超大规模并发事务处理和事务-分析混合型业务处理、支持动态分配计算资源,具有资源利用更加精细化、成本投入更低的优点。
使用场景
Datapipeline 支持读取 DM8 数据库的全量与增量数据。支持通过 JDBC 方式连接到 DM8 数据库中进行批量数据读取,同时支持以 JDBC 方式将数据写入到 DM8 数据库中。
功能说明
DataPipeline 3.4 版本支持 DM8 版本的达梦数据库,通过 JDBC 方式进行数据的读取与写入。在产品配置中,您只需配置数据库连接信息,并将系统所需权限赋予 DataPipeline 访问数据库的用户,即可通过配置节点、链路、任务获取到需要同步的数据信息。
新增支持 Hudi 数据目的地
功能背景
Hudi 是一种数据湖的存储格式,在 Hadoop 文件系统之上提供了更新数据和删除数据的能力以及消费变化数据的能力。Hudi 提供表、 事务、高效的 upserts/deletes、高级索引、 流式摄取服务、数据集群/压缩优化和并发,同时将数据保持为开源文件格式。
使用场景
DataPipeline 支持将源端数据变更实时写入 Hudi 目的地,在增量数据同步到 Hudi 的同时,也支持将数据映射至 Hive,以供 Hive 方便的进行实时视图查询。
功能说明
DataPipeline 3.4 版本支持 0.9.0 版本以上的 Hudi,通过 Hudi JAVA Client 将源端增量数据写入 Hudi 目的地,您无需额外部署 Spark、Flink 等计算引擎。在产品配置中,您只需配置 Hive 连接信息,开启数据映射至 Hive 功能后,在 Hive 端就能够实时获取到增量数据。
新增支持易鲸捷 xTP 数据源
功能背景
易鲸捷 QianBase xTP 是分布式数据库 2.0 时代的产品,采用云原生分布式架构,可支撑未来银行基本所有交易型业务和少量分析业务。其最大优势在于完全去中心化的架构设计,通过分布式数据库的高安全性,解决国产 IT 底座不够稳定的问题,是目前我国重要行业关键业务系统实现全栈技术安全替换的最佳解决方案。
使用场景
DataPipeline 支持读取易鲸捷 QianBase xTP 数据库的全量与增量数据。在易鲸捷 xTP 数据库作为交易系统数据库时,DataPipeline 可以通过 QianBase xTP CDC 功能,将增量数据抽取出来并同步至任何 DataPipeline 支持的数据目的地,以供下游业务方使用。
功能说明
DataPipeline 通过与易鲸捷公司的深度技术合作,通过调用 QianBase xTP CDC 功能获取增量数据并写入缓存,DataPipeline 的融合引擎将缓存的增量数据写入下游。在产品配置中,您只需将 CDC 功能需要的权限赋予 DataPipeline 访问数据库的用户,通过配置节点、链路、任务即可获取增量数据。
新增支持阿里云 OSS 数据节点
功能背景
阿里云 OSS 是文件系统类型的数据库。被广泛用在阿里系的生态产品中,在构建数仓,数据湖,OLAP,AI 分析,实时计算等诸多场景中,都成为解决方案中,存储部分最关键的一环。同时 OSS 还具备了海量存储,持久性,安全性高,成本低,智能存储等优点。
使用场景
DataPipeline 支持通过 SDK 读取阿里云 OSS 数据库的对象存储的文件。其中全量读取,将从指定路径定时读取全量数据。增量读取,则可以通过配置表达式的方式,从表达式所映射的路径下,增量读取文件。通常情况下, 会以日期(天)或者序列号为增量判断条件。 同时也支持通过 SDK 写入到阿里云 OSS 数据库中,写入时支持 CSV,Parquet,Avro 的文件类型,并且支持写入动态目录 业务调度,支持配置读取标识文件来控制读取逻辑。同时作为目的地时,当映射完成后,也支持配置路径,写入标识文件,方便业务系统调度。\ 支持通过 FTP 客户端进行文件读取,支持读取 CSV、Json 类型文件的定时全量读取,并支持定义带参数的源表,且支持定时读取该源表中的增量文件; 支持通过 FTP 客户端进行文件写入,支持将源端数据写入 FTP 目的地端的 CSV、Json 类型文件,并且支持写入动态文件目录; 支持配置读取标志文件来控制读取逻辑。
功能说明
DataPipeline 通过对文件类型系统的深刻认识以及对于业务场景应用的深刻理解,除了同其他已经支持的文件类型的节点(HDFS,FTP 等)一样,读取时提供全量读取,增量读取;写入时,则可以指定文件类型,并且指定文件的写入路径。您可以通过访问控制列表(ACL)给存储空间和对象授予访问权限,包括公共读写,公共读,私有三种权限。
新增支持逻辑主键场景映射配置
功能背景
部分用户现场源端数据表和目的地已有表由于历史原因无主键字段,这种情况下 DataPipeline 无法基于主键进行同步。在过去的版本中,用户通过人为在数据目的地将多个字段聚合配置主键来解决这个问题,但在实际的同步场景中,这种方法配置过程繁琐,且无法保证数据目的地不出现重复数据。
使用场景
逻辑主键的使用场景通常是数据源没有主键,但需要按照数据源主键进行增量同步的情况。
功能说明
DataPipeline 支持您在数据源与数据目的地标记字段为逻辑主键,但不会修改数据源与数据目的地的表结构,逻辑主键仅在 DataPipeline 数据同步内部使用。目前支持为 ORACLE 节点配置逻辑主键。
- 当数据源为 ORACLE 节点类型时,在数据源表没有主键的情况下,DataPipeline 支持您标记字段为逻辑主键,按照逻辑主键同步增量数据。
- 当数据目的地为 ORACLE 节点类型时,在新建表的情况下,DataPipeline 支持您标记字段为主键或逻辑主键。在选择目的地已有表的情况下,如果已有表没有主键,DataPipeline 支持您标记已有表字段为逻辑主键。
DP 内部数据追踪功能
功能背景
DataPipeline 系统可使用 Kafka 作为缓存组件 ,但如果发现数据同步出现延迟、数据丢失情况时往往难以判断数据是在哪个环节丢失,工程师需要手动连接 kafka 集群查看数据消费情况,定位问题的步骤往往繁杂而冗长。
功能说明
DataPipeline 内部数据追踪功能提供页面化的 Topic 消费信息查询,可查询的 Topic 包括 ORACLE 采集代理 Topic、数据任务 Topic、DataPipeline 系统内部 Topic。您可通过在页面指定数据消费起点、查询条件,查询数据消费情况
任务延迟监控
功能背景
以往版本用户无法直观的看到增量数据写入数据目的地的延迟情况。
使用场景
增量数据任务查看数据写入延迟。
功能说明
增量任务延迟监控功能将统计该增量任务中每条映射数据写入目的地的延迟时间,您可通过每条映射的延迟统计图表直观看到数据写入时间波动,用以观测性能、稳定性指标。
数据任务及系统提供导出报表功能
功能背景
客户无法通过一个报表知道系统的全面信息和状况,不便于统计分析与汇报
使用场景
每天或每月可以对系统进行巡检,通过导出报表分析系统、节点、链路、任务的各种信息指标来了解该系统的全面状态
功能说明
系统设置新增导出报表的功能,可以选择导出一段时间(最近 24 小时、最近一周、最近一个月)的系统信息、用户信息、节点信息、链路信息、任务信息,直接页面下载相关 Excel 文件到客户端进行分析和汇报
功能优化
优化数据映射多对一(分库分表合表)场景配置
功能背景
在老版本的数据映射中,支持配置多对一的表映射,但是目的地需要一张一张的单独选表,无法批量选择同一张表,且多对一关系的字段映射也是相互独立的,无法批量配置,而大多数用户多对一场景下,字段映射的关系大多一致,导致在用户多对一场景中需要做很多重复的操作,降低了用户体验和配置效率。
使用场景
当用户想将多张源表中的数据同步到目的地同一张表时,可以通过数据映射处多对一聚合的功能,快速完成配置。在分库分表同步到目的地同一张表时,由于源表结构一致,可以配置一张源表到目的地表的字段映射复用至其他所有表,大大减少了配置任务的时间。
功能说明
3.4 版本支持在数据映射表映射页面选择多张源表进行“多对一聚合”操作,对多张源表选择同一张目的地表,一次性完成多对一配置,并且在该页面更直观地展示了多对一关系。\ 同时支持在数据映射页面配置一条映射的字段映射关系并根据源表字段匹配将该映射规则应用于其他表映射,大大减少了用户的操作步骤。
优化 TiDB TiCDC 读取方式节点配置
功能背景
在过去的版本中,DataPipeline 支持了通过读取 TiDB TiCDC 程序向消息队列缓存的增量数据的方式获取 TiDB 增量数据。但在实际配置与管理过程中,DataPipeline 并未提供页面化的 TiCDC 程序配置,导致配置过程割裂,用户操作与体验十分不友好。
使用场景
在 TiDB 作为上游数据源的场景中,有大量的数据表需要同步,通过 DataPipeline 可视化的同步配置即可将 TiCDC 配置、DP 任务配置结合在一个平台中管理,方便用户使用。
优化任务执行配置
功能背景
当前 DP 的任务执行已经支持对于同步方式,执行方式,同步起点进行设置。,可以通过 where 条件或者配置数据映射实现行过滤和列过滤。但是对于增量场景中,无法实现范围同步。这对于类似电信行业,金融行业,有月结,年结诉求的,且全量数据巨大的场景,将无法实现准确的数据分析。因此在 3.4 版本中,结合实际业务场景,增加同步终点的设置从而满足电信和金融行业的实际应用场景。
使用场景
当任务配置为,增量监听模式时,支持通过日志解析,配置同步终点,从而实现日志读取的范围同步。
| 同步方式 | 执行方式 | 行过滤 | 列过滤 | 复杂条件 | 同步范围 |
|---|---|---|---|---|---|
| 全量同步 | 定时 | where 条件过滤 | 数据映射配置 | 高级清洗 | -- |
| 增量同步 | 定时 | where 条件过滤 | 数据映射配置 | 高级清洗 | -- |
| 监听 | 目前不支持,只能在高级清洗设置 | 数据映射配置 | 高级清洗 | 起点+终点 |
功能说明
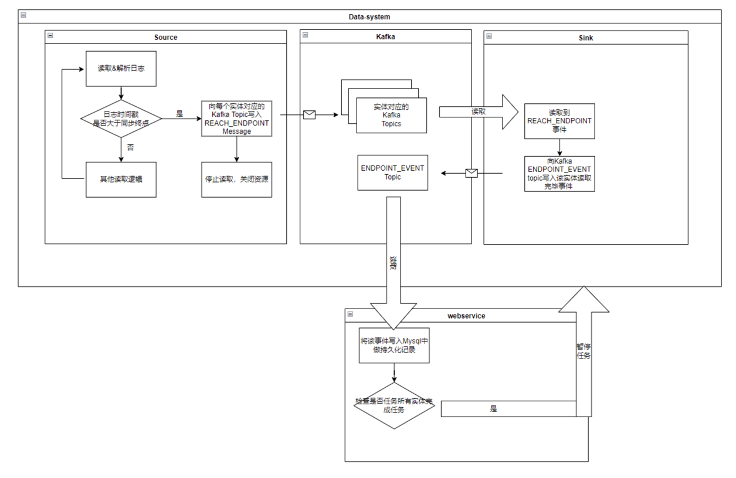 \
当读取到达同步终点时,暂停读取,将所有缓存数据写入后,任务暂停,从而保障写入到下游的数据,不会丢数据也不会出现重复数据。
细化节点、链路、任务的操作权限(编辑/查看)
功能背景
在之前的版本中,DataPipeline 支持了基于用户组的使用权限区分,对于数据链路、数据节点、数据任务均可分别添加参与人控制谁能使用
使用场景
在多团队使用 DataPipeline 产品的场景中,不同团队使用的负责的业务方向不同,但组织内数据流转信息也需要一定透明。\ 因此区分链路、节点、任务等逻辑概念的编辑与查看/使用权限应运而生。
功能说明
在链路、节点、任务基本信息中,您可添加编辑参与人或查看参与人,以控制各实体的细分权限。
Kafka 数据目的地写入数据格式优化
功能背景
3.4.5 版本针对往期版本 Kafka 数据格式定义进行了优化,系统支持通过页面配置写入 Kafka 目的地的信息。当数据源节点类型为 ORACLE、Mysql 时,支持采集数据源更丰富的元数据信息,且支持采集数据 before 信息。数据格式适配 ORACLE GoldenGate 写入 Kafka 数据格式,降低了替换 ORACLE GoldenGate 技术成本。
使用场景
用户需要将更丰富的元数据信息以及数据变更前的内容写入 Kafka 目的地,或替换 OGG 的场景。
功能说明
当 ORACLE 节点的读取方式为:DataPipeline Oracle 采集代理,LogMiner,IBM InfoSphere Data Replication 时,支持采集 ORACLE rowid、before 信息。当 Mysql 节点的读取方式为 BINLOG 时,支持采集 gtid、position、before 信息。\
其他优化与问题修复
优化错误队列数据清除策略
新增支持读取 gz 格式压缩文本文件
新增支持注释映射与注释配置
优化文件读取分隔符配置
优化数据映射元数据刷新逻辑
新增支持 Hive SQL 引擎配置
优化日志查看、筛选组件,提供日志下载功能
修复部分已知问题
v3.3
燕山雪花大如席,片片吹落轩辕台。DataPipeline 在 12 月迎来了 V3.3 版本更新。
版本目标
- 多元异构与国产信创支持
- 全面增强链路映射配置
在 3.3 版本中,我们围绕着多元异构与国产信创支持、全面增强链路映射配置两个版本目标,新增支持了 MongoDB 数据节点、OceanBase 数据节点、HBASE 数据目的地、API 数据源、SFTP 数据节点、AWS PostgreSQL RDS 数据节点,Oracle 数据库日志解析采集代理程序推出集中管理的新版本,对操作审计日志功能进行了优化;同时,对最经常使用的数据链路映射配置功能进行了全面增强。
多元异构与国产信创支持 新增功能:MongoDB 数据节点
功能背景
MongoDB 是一个基于分布式文件存储的数据库,旨在为 WEB 应用提供可扩展的高性能数据存储解决方案。在 2021 年 4 月数据库流行度排行中,MongoDB 位列第五,在 NoSQL 中位列第一。近几年内在国内发展迅速,在金融领域,中国银行、招商银行以及太平洋保险、泰康等这些头部金融行业,都开始使用 MongoDB,在很多公有云平台,MongoDB 也成为除了 MySQL 之外使用最广泛的一个数据库之一。
使用场景
- 支持通过 MongoDB Java Drivers 定时增量读取和定时全量读取源端数据。
- 支持通过 Change Streams 订阅集合上所有数据的更改来实时读取增量数据。
- 支持通过 MongoDB Java Drivers driver 将数据写入目的地端。
功能说明
- 支持通过 MongoDB Java Drivers 连接到 MongoDB 节点进行数据的采集/写入并进行可用性校验;
- 支持 MongoDB 节点相关语义映射:
- 支持 MongoDB 节点相关的默认 mapping;
- 支持配置 MongoDB 节点相关的字段类型、索引、特性映射;
- 支持新建 MongoDB 节点作为数据源/目的地的链路:
- 支持通过 Change Stream 的方式实时读取 MongoDB 数据源的增量数据;
- 支持通过固定结构、无结构的两种方式解析 MongoDB 数据源的集合;
- 支持 MongoDB 目的地通过新建表和选择已有表的方式完成表映射;
- 支持配置 MongoDB 节点作为源/目的地相关表映射以及字段映射;
- 支持 MongoDB 节点作为数据源/目的地的结构变化策略;
- 支持 MongoDB 节点作为数据源/目的地的数据加载策略;
- 支持新建 MongoDB 节点作为数据源/目的地的任务:
- 支持 MongoDB 节点作为源的全量同步/增量同步;
- 支持 MongoDB 节点全量初始化、清空目的地功能;
- 支持 MongoDB 节点作为源/目的地的重新同步并情况目的地功能。
多元异构与国产信创支持 新增功能:OceanBase 数据节点
功能背景
- OceanBase 数据库是阿里巴巴和蚂蚁集团不基于任何开源产品,完全自研的原生分布式关系数据库软件,在普通硬件上实现金融级高可用,兼容 MySQL 模式与 Oracle 模式,具有高可用可扩展的业务连续性、应用易用性、低成本、低风险的特点。在客户的各类系统中应用广泛。
使用场景
- OceanBase 目前支持 2.2.x 与 3.x 版本,在 DataPipeline 3.3 版本中可作为数据源和数据目的地使用。
- 作为源使用,可以使用 ObLog Reader,JDBC 的读取方式,将增量和全量数据写入到 MySQL、MS SQL Server、Oracle、PostgreSQL、Apache Kafka、IBM Db2、Open Gauss、Gauss 200、FTP、HDFS、Hive、Inceptor、MaxCompute、TiDB、SequoiaDB、Redis、TelePG 等。
- 作为目的地使用,可以使用 JDBC 写入方式,将源端的增量和全量数据写入到 OceanBase 目的地。
功能说明
- 支持通过 ObLog Reader,JDBC 连接到 OceanBase 节点进行数据的写入并进行可用性校验;
- 支持 OceanBase 节点相关语义映射
- 支持 OceanBase 节点相关的默认 mapping;
- 支持配置 OceanBase 节点相关的字段类型、索引、特性映射;
- 支持新建 OceanBase 节点作目的地的链路:
- 支持配置 OceanBase 节点作为目的地相关表映射以及字段映射;
- 支持 OceanBase 节点作为数据目的地的结构变化策略;
- 支持 OceanBase 节点作为数据目的地的数据加载策略;
- 支持新建 OceanBase 节点作为目的地的任务:
- 支持 OceanBase 节点作为目的地的重新同步并清空目的地功能。
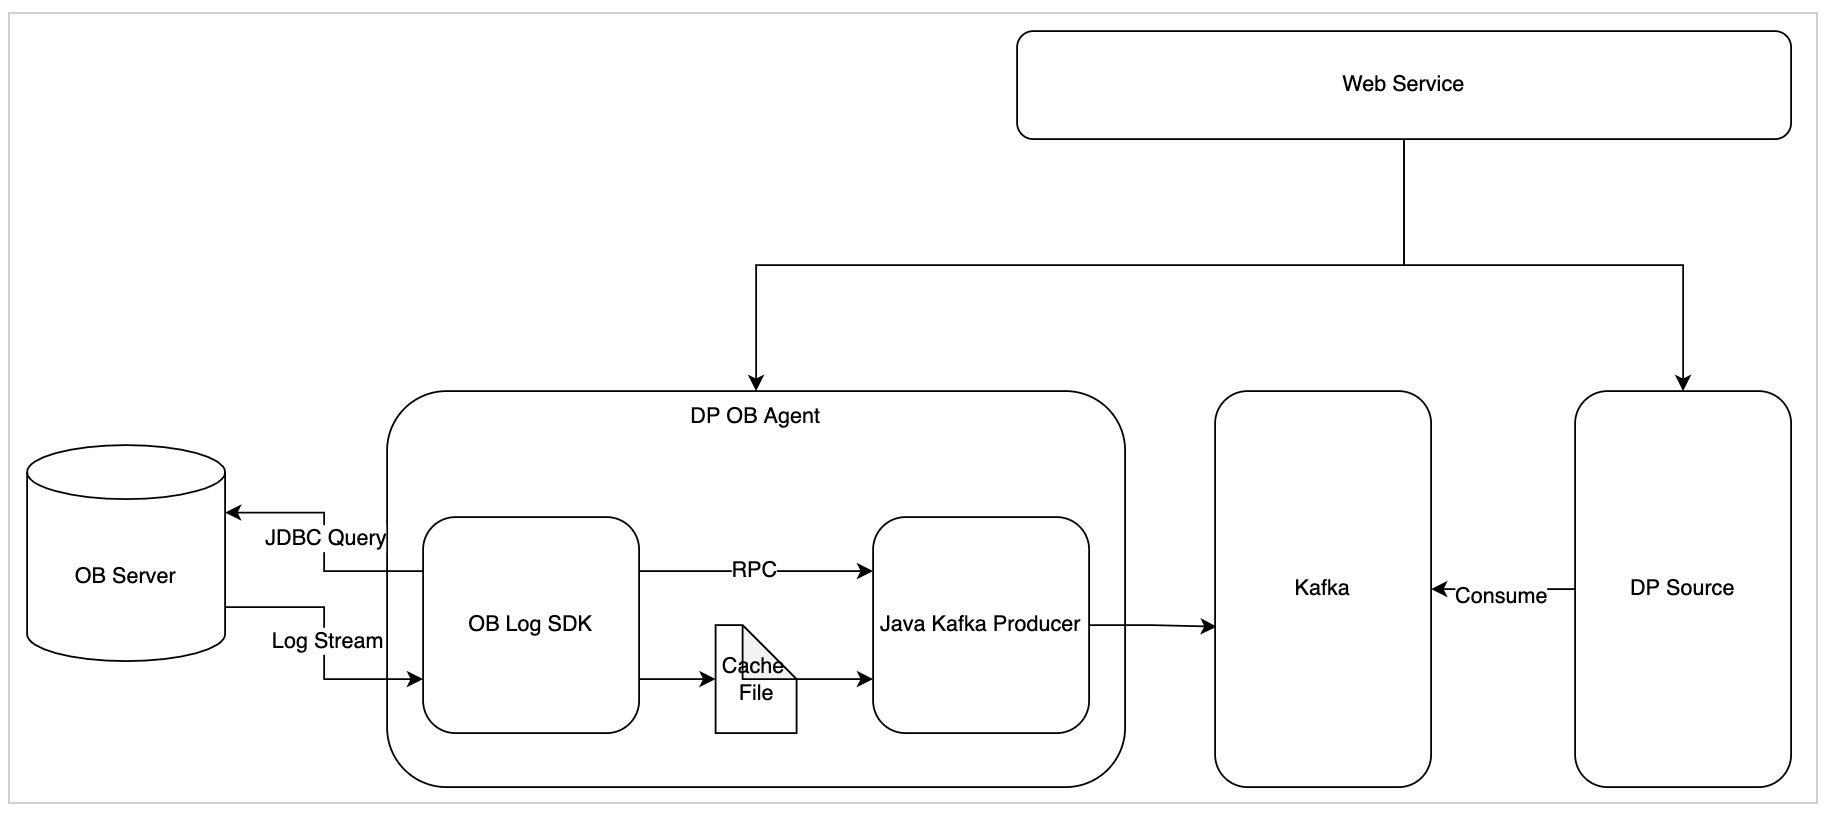
使用 ObLog Reader 采集 OceanBase 实时数据,系统架构如下:
多元异构与国产信创支持 新增功能:HBASE 数据目的地
功能背景
- hbase 是分布式可扩展、面向列的开源数据库,支持海量数据存储和计算,在需要实时读写、随机访问超大规模数据集时,可以使用 HBase。利用 HBase 可以在廉价 PC server 上搭建起大规模结构化存储集群。HBase 被广泛应用于大数据存储解决方案中。
- Hadoop HDFS 为 HBase 提供了高可靠性的底层存储支持,Hadoop MapReduce 为 HBase 提供了高性能的计算能力,Zookeeper 为 HBase 提供了稳定服务和 failover 机制。
使用场景
- hbase 目前发布了 1.x 和 2.x 版本,datapipeline3.3 版本支持将 hbase1.x 和 2.x 版本作为目的地使用。
- 作为目的地使用,datapipeline3.3 版本支持 Hbase 客户端写入方式,将源端的增量和全量数据写入到 Hbase 目的地。
功能详情
- 支持通过 JDBC 连接到 HBase 节点进行可用性校验;
- 支持通过 Hbase 客户端方式连接到 Hbase 节点进行数据写入。
- 支持新建 HBase 节点作目的地的链路:
- 支持配置 HBase 节点作为目的地相关表映射以及字段映射;
- 支持通过高级清洗对 Hbase RowKey 进行写入;
- 支持 HBase 节点作为数据目的地的结构变化策略;
- 支持 HBase 节点作为数据目的地的数据加载策略。
- 支持新建 Hbase 节点作为目的地的任务:\
- 支持 Hbase 节点作为目的地的重新同步并清空目的地功能。
多元异构与国产信创支持 新增功能:SFTP 数据节点
功能背景
sftp 是 Secure FileTransferProtocol 的缩写,安全文件传送协议。可以为传输文件提供一种安全的加密方法。SFTP 是使用加密传输认证信息和传输的数据,所以,使用 SFTP 是非常安全的。在很多对网络安全性要求更高客户场景中,需要使用到 SFTP 代替 FTP。
使用场景
- 支持通过 FTP 客户端进行文件读取,支持读取 CSV、Json 类型文件的定时全量读取,并支持定义带参数的源表,且支持定时读取该源表中的增量文件;
- 支持通过 FTP 客户端进行文件写入,支持将源端数据写入 FTP 目的地端的 CSV、Json 类型文件,并且支持写入动态文件目录;
- 支持配置读取标志文件来控制读取逻辑。
功能说明
- 支持通过 JDBC 连接到 SFTP 节点进行数据的采集/写入并进行可用性校验;
- 支持 SFTP 节点相关语义映射
- 支持 SFTP 节点相关的默认 mapping;
- 支持配置 SFTP 节点相关的字段类型、索引、特性映射;
- 支持新建 SFTP 节点作为数据源/目的地的链路:
- 支持配置 SFTP 节点作为源/目的地相关表映射以及字段映射;
- 支持 SFTP 节点作为数据源/目的地的结构变化策略;
- 支持 SFTP 节点作为数据源/目的地的数据加载策略;
- 支持新建 SFTP 节点作为数据源/目的地的任务:
- 支持 SFTP 节点作为源的全量同步/增量同步;
- 支持配置读取标志文件来控制读取逻辑;
- 支持 SFTP 节点全量初始化、情况目的地功能;
- 支持 SFTP 节点作为源/目的地的重新同步并情况目的地功能。
多元异构与国产信创支持 新增功能:API 数据源
功能背景
- 全球有 2000 万以上的开发者、超过百亿的 API。所有的应用程序,均需要通过 API 进行数据通讯,因此 API 是所有数据交互的关口。同时 API 也企业核心的数字资产,是企业数据和服务输出和获取的唯一渠道。API 节点的实现将增强产品多元异构的特性,满足更多用户复杂场景;
使用场景
- 支持请求返回格式为 XML、TEXT、JSON 的 API,并按照样例文件解析出字段来进行字段映射,并且支持用参数的形式定义 URL、Params、Headers、Body。
功能说明
- 支持连接到 API 节点进行数据的采集并进行可用性校验
- 支持请求方式:GET、POST、PUT、DELETE、PATCH
- 支持分页 API 读取
- 支持认证方式:Basic auth
- 支持返回格式:XML、TEXT、JSON
- 支持新建 API 节点作为数据源的链路
多元异构与国产信创支持 功能优化:操作审计日志功能增强
功能背景
- 在之前的版本中,DataPipeline 支持了数据节点、链路、任务的配置变更、状态变更、高风险操作等种类的日志页面查看,但这些审计日志是分布在每个逻辑概念详情页-日志查看中的,在进行行为审计过程中很不方便。
使用场景
- 在行为审计过程中,通过系统审计日志页面,查看数据节点、链路、任务的配置变更、状态变更、高风险操作等审计日志。
功能说明
- 在系统日志页面,通过筛选操作审计日志,查看所有节点、链路、任务、系统配置的审计日志。
- 已被删除的数据节点、链路、任务的也可以通过系统日志页面查看。\
多元异构与国产信创支持 新增功能:AWS PostgreSQL RDS 数据节点
功能背景
- AWS RDS for PostgreSql 是亚马逊提供的云化 PostgreSql 数据库节点,支持 PostgreSQL 核心引擎功能。
使用场景
- Amazon RDS 目前支持 PostgreSQL 9.6、10、11 和 13 版本,在 3.3 版本中可作为数据源和数据目的地使用。
- 作为源使用,可以使用 Wal2json,JDBC 的读取方式,将增量和全量数据写入到 MySQL、MS SQL Server、Oracle、PostgreSQL、Apache Kafka、IBM Db2、Open Gauss、Gauss 200、FTP、HDFS、Hive、Inceptor、MaxCompute、TiDB、SequoiaDB、Redis、TelePG 等。
- 作为目的地使用,可以使用 JDBC 写入方式,将源端的增量和全量数据写入到 AWS RDS for PostgreSql 目的地。
功能说明
- 支持通过 JDBC 连接到 AWS RDS for PostgreSql 节点进行可用性校验;
- 支持通过 JDBC、Wal2json 连接到 AWS RDS for PostgreSql 节点进行数据读取,支持通过 JDBC 连接到 AWS RDS for PostgreSql 节点进行数据写入。
- 支持 AWS RDS for PostgreSql 节点相关语义映射
- 支持 AWS RDS for PostgreSql 节点相关的默认 mapping;
- 支持配置 AWS RDS for PostgreSql 节点相关的字段类型、索引、特性映射;
- 支持新建 AWS RDS for PostgreSql 节点作目的地的链路:
- 支持配置 AWS RDS for PostgreSql 节点作为目的地相关表映射以及字段映射;
- 支持 AWS RDS for PostgreSql 节点作为数据目的地的结构变化策略;
- 支持 AWS RDS for PostgreSql 节点作为数据目的地的数据加载策略;
- 支持新建 AWS RDS for PostgreSql 节点作为目的地的任务:\
- 支持 AWS RDS for PostgreSql 节点作为目的地的重新同步并清空目的地功能。
全面增强链路映射配置 数据映射功能全面增强
功能背景
在经历了 V3.1 版本的批量设置后,我们收到了一些反馈。该功能最直接的目的是为了提升产品的易用性,因此我们继续以提升易用性为目标,对易用性做了进一步的提升和改进。
本版本是 V3.3 版本中易用性优化的一个里程碑版本,在 DataPipeline 的产品中,数据链路是最为复杂的一部分。因此提升其易用性,也会极大的优化产品的体验。并且本版本制定了批量的模板,后续新的节点都可以套用该模板,针对规则进行设置,执行规则即可将原来繁复的建立数据映射的工作一键完成。同时增加了检查,将一些链路上的错误和警告,前置反馈给用户,提升了交互性,避免用户在无法获取到链路异常状态的情况下,继续做数据任务的同步。导致整个异常问题以执行任务报错为代价反馈。
使用场景
- 基于某个规则向目的地批量创建新表,或者匹配已有表,一键完成映射初始配置
- 批量修改数据映射
- 检查数据映射中的一些配置错误并提前反馈,进行修复
功能说明
- 将原有的批量拆解成了规则+操作两个部分。
- 拆分出规则后,您就可以在在配置好一个规则后,直接选表即可完成表的创建或者匹配工作。避免了大量的重复选表和建表工作
- 扩大了支持的范围,上一个版本批量还不支持文件,以及一些新增节点的设置,诸如 maxcompute,hdfs,ftp 等节点都无法支持批量设计,这里通过提炼出规则,可以对于所有的节点进行操作。
- 增强了匹配已有表的场景,上一个版本批量的场景支持有限,比如对于已有表的匹配规则,只能支持名称全匹配,不支持前缀,后缀,或者字符替换等模式。本版本对于已有表以及字段的匹配功能进行了加强
- 增加了链路的配置检查,过往使用中,软件产品由于提升了灵活度,这导致设置的时候,缺乏足够的限制。也会给一些不熟悉产品的用户带来困扰。这次特别对数据链路中一些问题做了提前的预警。采用警告和错误两个级别提示用户对映射进行核查及修复,帮助用户可以尽早知道链路设置的问题,避免问题后置,任务启动中才暴露问题。
- 对于映射的操作粒度,在 V3.3 版本之前,删除只能整条映射删除。但是用户有时候有保留源表,删除目的地表重新匹配的需求,因此本版本增加了该功能,并且可以提供批量删除,提升易用性
- 优化了保存按钮,并将检查的提示一同悬浮在界面固定位置,方便用户实时查看到链路状态。
- 优化交互,对于一些常见的操作比如增加前缀,后缀的操作,可以通过界面直接配置,使用户更加轻易的对所选映射进行编辑和修改。
- 高级清洗的优化,原有的高级清洗批量操作里只能选择已有的高级清洗脚本,本次更新内容除了可以选择已有高级清洗脚本,还可以选择创建一个新的高级清洗脚本,减少用户的操作路径。
v3.2
雨水夹明镜,双桥落彩虹。DataPipeline 在 10 月迎来了 3.2 版本更新。
在 3.2 版本中,我们针对结构变化策略进行了功能增强,新增支持了 MS SQL Server 的 Change Data Capture 的数据读取模式、Gauss200 数据目的地、自定义数据节点、TelePG 数据节点,并适配支持 Hive、PostgreSQL、SequoiaDB 的多个版本。
功能更新:
结构变化策略新增更多的策略支持
当前 DataPipeline 已经支持的结构变化包含了源端删除表,源端加列,源端删列以及源端的字段变化(类型,精度,标度)。我们发现上游还会有一些常见的 DDL 操作,于是我们在 3.2 新增了更多的 DDL 处理策略。本版本在原有基础上又新增了源端清空表的策略,源端新建表的策略, 源端重命名字段的策略。以上三种源端的 DDL 语句,均需要解析日志才可以获取,因此仅有部分数据源才能获取到该 DDL 的变化。并且对应到不同的目的地,会有相应的执行策略。同时当新增列时,增加可以控制上游的默认值是否同步的选项。
新增升级功能
不能升级的软件是没有生命力的, 由于产品在 2.7 到 3.2 的产品演进中,从业务场景,企业数据实时化,数据规模发展等角度出发,配合企业数据部门发展以及协同的需求,演进出一套新的逻辑概念。因此在 2.8 的初期版本,一直在努力地打造功能。终于在本版本,功能搭建基本完成的情况下, 启动 2.7 升级的功能。本版本将从安全性,便捷性等角度出发, 为客户提供较为方便的升级方案,帮助客户从 2.7 的系统升级到当前最新的版本,助力客户实现数据任务的平稳迁移。
新增 MS SQL Server Change Data Capture 数据读取模式
在之前的版本中,对于 MS SQL Server 数据节点的增量数据获取,DataPipeline 支持了 Change Tracking 模式;基于 Change Tracking 技术,获取增量数据在数据源将产生部分物化视图,占用部分数据源的 SQL 引擎资源。且 Change Tracking 不支持在 Always On 的备库中开启,在部分生产环境中,Change Tracking 的开启确实对部分 DBA 同学造成了一定困扰。
在 3.2 版本中,DataPipeline 支持了通过 Change Data Capture 模式(以下简称 CDC)获取 MS SQL Server 的增量数据;CDC 模式通过解析数据库日志,将增量数据写入到数据库临时表中,减少了因产生物化视图而带来的额外数据源 SQL 引擎压力,且支持 Always On 备库,丰富了数据采集的场景。
新增 GaussDB 200 数据目的地
GaussDB 200 是企业级的大规模并行处理关系型数据,采用 MPP(Massively Parallel Processing)架构,支持行存储与列存储,提供 PB 级别数据量的处理能力。GaussDB 200 在核心技术上跟传统数据库相比有巨大优势,可以解决很多行业用户的数据处理性能问题,可以为超大规模数据管理提供高性价比的通用计算平台,并可用于支撑各类数据仓库系统、BI(Business Intelligence)系统和决策支持系统,统一为上层应用的决策分析等提供服务,所以在近几年里得到了市场的广泛认可。
在 3.2 版本中,DataPipeline 支持通过 JDBC 的方式向 GaussDB 200 写入数据。同时,DataPipeline 也与华为进行了鲲鹏服务器兼容性测试,支持将 DataPipeline 部署至鲲鹏架构服务器,并连接基于鲲鹏架构的 GaussDB 来采集数据。
新增自定义数据节点
在以往的客户服务过程中,DataPipeline 发现很多用户有一些特殊节点以及复杂的连接逻辑的需求,无法通过现有的通用节点连接来实现。
为了解决这个问题,在 3.2 版本中,DataPipeline 新增了自定义数据节点,以适应更灵活的数据同步场景。自定义节点中允许用户自定义实体,实体是任意的,可以是关系型数据库、数据仓库、API 或者应用等,您可以根据自己的需求去定义其读取及写入逻辑以及对系统提供的同步策略的适配。
TelePG 目的地,TeleDB 数据源的适配
TelePG 和 TeleDB 为天翼云提供基于云计算平台上的在线关系型数据库服务,其中 TeldDB 主要通过天翼云的 RDS 实例,在互联网网站、物联网、企业办公和移动客户端提供应用。完全兼容 MySQL5.6,5.7,8.0,提供备份,恢复,扩容,监控等数据库服务。而 TelePG 则可以提供在线的高可用,面向负责 SQL 处理的 OLTP 在线失误处理场景,支持 NoSQL 数据类型,支持 GIS 地理信息处理,提供 PostgreSQL 版本为 9.5,9.6,10,11 这可以更好的适应和满足电信的应用场景。
在 3.2 版本中,TeleDB 作为数据源,可以提供 binlog 和 JDBC 两种读取方式,TelePG 作为目的地,提供 JDBC 的写入方式,同时支持丰富的数据类型。
功能优化:
Hive/Inceptor 与文件系统节点任务执行配置优化
在任务暂停后,Hive/Inceptor 节点以及文件系统节点作为源的映射支持重新设置同步起点,Hive/Inceptor 节点以及文件系统节点作为目的地的映射支持清空目的地。并且支持 Hive/Inceptor 节点以及文件系统节点作为目的地的任务在同步前清空目的地。
时间类型字段映射规则优化
SQL 类型的数据库通常有三种时间类型
- 普通时间类型:写入的是什么值,读出来的就是什么值。无论数据库的时区和 Client 的时区如何,结果都是一样的;
- 带本地时区的时间类型:数据库存储的时间以数据库的时区设置为准。当 Client 访问数据库时,获取的值会自动按照 Client 的时区进行转换;
- 带时区的时间类型:数据库分别存储时间和时区。当 Client 访问数据库时,获取的时间对象也包括这两部分信息。
当程序运行一个数据同步任务时,我们的 Source 和 Sink Task 分别承担读取 Client 和写入 Client 的角色,其 JVM 的时区均为 UTC 时区,各个 JDBC 类型的 Source 和 Sink 会话时区默认也是 UTC 时区。普通时间和时区时间都不会受到 Client 的会话时区的影响,而本地时区会受影响。尤其是当下游的字段成为文本类型时(例如 kafka),从源端读出来的时间应该按照哪个时区显示就成为一个问题。在之前版本的产品中,会话时区均为 UTC,因此读出来的值也是 UTC 时区的值,在一些情况下就不符合用户要求了。例如,城商行的客户希望 Kafka Sink 中 oracle timestampltz 类型对应的值为+08:00 时区的值,而不是 UTC 时区的。如果无法指定参数,用户就需要自己写高级清洗来进行转换,体验非常不好。
在 3.2 版本的产品中,我们支持在数据节点配置时区参数,通过指定数据节点时区,在读取数据时可以获得基于该失去准确转换的时间值,在写入数据时可以按照指定时区进行准确时间转换。
其他优化
- 消息队列缓存多集群部署优化
- Hive 适配 1.x 版本
- PostgreSQL 12.x、13.x 版本适配
- 巨杉数据库 2.x、3.x、5.x 版本适配
- 修复部分系统问题
- MySQL 目的地语义映射特性映射自动添加全部小写
- 数据加载策略对于无主键表配置优化
v3.1
荷风送香气,竹露滴清响。DataPipeline 在 6 月迎来了 3.1 版本更新。
在 3.1 版本中,我们新增了支持阿里云 Maxcompute 数据节点、通过 InfoSphere Data Replication 获取 Oracle 增量数据;对 Kafka 数据节点 Topic 序列化器设置、数据映射配置进行了操作优化。
功能更新:
MaxCompute 数据节点
3.1 版本 Datapipeline 新增加了 MaxCompute 的数据节点的支持。该节点可以作为源及目的地。当作为目的地时支持 MaxCompute 在目的地创建分区表及非分区表,或者选择已有表进行数据同步。当作为数据源时增量读取及范围读取等多种读取方式,目前支持的数据类型为 2.0。暂不支持 MaxCompute 的外表场景。
Oracle 支持通过 InfoSphere Data Replication 获取数据
对于实时获取 Oracle 数据源的增量数据,DataPipeline 已经支持了通过自研采集代理程序与 LogMiner 的数据获取方式;这些方式可以支持 Linux、Windows 服务器的环境。在一些客户的场景中,Oracle 数据源可能在 AIX 环境中,通过 InfoSphere Data Replication,DataPipeline 也得到了采集 AIX Oracle 数据库增量数据的能力。
结构变化策略新增支持数据字段类型及精度标度 DDL 处理策略
当前 DataPipeline 已经支持的结构变化包含了源端删除表,源端加列和源端删列。我们发现上游还会有一些常见的 DDL 操作,于是我们在 3.1 新增了上游的字段类型变化及精度标度变化的 DDL 处理策略。我们会根据不同的数据源到不同的目的地的能力范围以及常见的字段类型变化做处理。从而更好的实时同步上游的数据变化。
功能优化:
支持 Kafka Topic 序列化器默认值设置
在过去的版本中,DataPipeline 无法修改 Topic 序列化器的默认值,导致每一次新增的 Topic 都需要手动调整至所需要的序列化器。在此版本中,我们将此功能进行了优化,支持了在 Kafka 节点的基本设置页面中配置 Kafka Topic 序列化器的默认值,使所有新增 Topic 的 Key 及 Value 都可以根据需要载入默认值,增加了便捷性和灵活度。此外,在每一次进行批量修改序列化器后,出现追加询问弹窗,使用户可以更便捷地提前对未来要添加的 Topic 序列化器进行默认值的设置。(Key 序列化器和 Value 序列化器须保持一致)。
数据映射默认配置:支持创建映射时添加默认字段与默认开启高级清洗
此版本中,DataPipeline 支持了包含关系型数据节点类型等数据映射默认配置,提前设置好需要添加的字段和开启高级清洗脚本的使用,显著减少了对数据链路中未来添加映射的后续操作。通过此功能,让您能够快捷地在创建映射时向数据目的地添加默认字段与默认开启高级清洗脚本,优化操作流程,减少操作难度。
其他优化
- 数据任务状态-自动重启中状态优化。
- 数据映射同步延迟监控日志优化。
- 数据映射元数据刷新功能优化。
- Oracle 采集代理程序健康检查逻辑优化。
- InfoSphere Data Replication 订阅自动重启功能优化。
- 数据任务执行配置优化。
- 增加了任务执行过程中一些相关业务 metric 的展示,包括时间预估,待写入的缓存的数据量和未读取数据量的统计。
v3.0
东风何时至,已绿湖上山。DataPipeline 在 4 月迎来了 3.0 版本更新。
在 3.0 版本中,我们新增支持了 TDH(星环)大数据平台、GaussDB(Open Gauss)数据目的地、TiDB TiCDC 读取模式、Db2 数据目的地、PostgreSQL 数据目的地;在高级清洗功能中,支持客户使用自有依赖资源进行数据处理;并对数据任务执行配置、数据映射批量操作场景进行了产品优化。
功能更新:
Inceptor 数据节点
Inceptor 是星环极速大数据平台(Transwarp Data Hub)基于 Hadoop 和 Spark 技术平台打造的用于数据仓库和交互式分析的大数据平台软件。在证券相关客户的数仓场景/数据平台场景中,获得了广泛的认可。
在当前版本中,DataPipeline 与星环科技达成了产品兼容互认证,全面支持 Transwarp Inceptor 数据节点。
我们支持 Inceptor 文件读取方式、Inceptor 文件写入方式以及 JDBC 写入方式来进行 Inceptor 节点作为源、目的地的同步。
Inceptor 文件读取方式通过连接到 Metastore 读取表结构并通过 HDFS 客户端读取文件,该读取模式支持 CSV、Parquet、Avro、ORC 类型文件的定时全量读取以及基于分区的定时增量读取。
Inceptor 文件写入方式通过连接到 Metastore 写入表结构并通过 HDFS 客户端进行文件写入,该写入模式支持将源端数据写入 HDFS 目的地端的 CSV、Parquet、Avro、ORC 类型文件,并且支持新建外部表、单值分区表、范围分区表。
JDBC 写入方式通过 JDBC 的方式连接到 HiveServer2 进行文件写入,该写入模式支持将源端数据写入目的地端的 CSV、Parquet、Avro、ORC 类型文件,并且支持新建外部表、内部表、单值分区表、范围分区表、分桶表以及事务 ORC 表。
GaussDB(openGauss)数据目的地
openGauss 是一款开源关系型数据库管理系统,采用客户端/服务器,单进程/多线程架构,支持单机和一主多备部署方式,备机可读,支持双机高可用和读扩展。
在当前版本中,我们支持通过 JDBC 的方式向 GaussDB 写入数据。同时,DataPipeline 也与华为进行了鲲鹏服务器兼容性测试,支持将 DataPipeline 部署至鲲鹏架构服务器,并连接鲲鹏架构 GaussDB 采集数据。
TiDB TiCDC 读取模式
TiDB 是 PingCAP 公司自主设计、研发的开源分布式关系型数据库,随着数据核心系统国产化浪潮的不断推进,TiDB 逐渐受到客户青睐;在之前的版本中,TiDB 作为新业务系统数据库通常需要将其他系统的数据导入 TiDB,DataPipeline 也在众多客户实际场景中较好地支持了 TiDB 作为数据目的地。
TiDB 在客户场景中的使用频率逐步升高,同步以 TiDB 作为数据库的业务系统的数据的需求也逐渐增多,在当前版本中,我们支持了 TiDB 作为数据源;同时提供了 JDBC 连接、TiCDC 两种增量数据获取方式。
通过配置 TiCDC 与 DataPipeline TiDB 数节点,并在 DataPipeline 系统中接入 TiCDC 吐出的数据,数据工程师可以通过获取 TiDB 增量数据日志的方式,实时采集 TiDB 增量数据,精准获取增量数据、数据变化,有效降低数据源数据读取压力。
Db2 数据目的地
支持通过 JDBC 的方式向 Db2 写入数据。
PostgreSQL 数据目的地
支持通过 JDBC 的方式向 PostgreSQL 写入数据。
功能优化:
在高级清洗功能中,使用自定义依赖包处理数据
在之前的版本中,我们支持用户通过自定义 Java 数据处理脚本,对单条数据进行简单处理,如添加字段赋值、时间转换、字段截取/拼接等。
在实际的生产环境数据处理过程中,由于客户场景不同,单条数据处理的数据加工场景也不尽相同且愈发复杂。通过页面编辑清洗脚本的方式在代码相对复杂的场景中,用户使用友好程度较低。
在当前版本中,我们支持在高级清洗功能中,通过程序调用自定义依赖包进行单条数据处理,在一些代码量较大的处理场景中,如数据加密/解密,复杂数据类型转换,数据脱敏操作等,提供了更友好的支持。现可以通过页面上传、管理依赖包,通过清洗脚本直接调用,省时省力。
数据映射批量配置
数据映射是将数据源的数据表和字段与数据目的地的表和字段建立映射关系的功能。数据映射配置是将源数据与目的地数据关联起来的步骤,是 DataPipeline 产品支持多元异构场景的核心。通过图形化的配置,您可以轻松地建立不同节点之间的数据映射,来为数据任务的运行做准备。
在之前的版本中,我们支持了数据映射页面化定义,将复杂的数据对应、转换、处理代码变成了交互式的页面配置,将数据需求的处理时间从 2 周缩短至 10 分钟。
在当前版本中,我们支持了数据映射批量配置,选择要同步哪些数据源表后,可以通过批量操作选项,一键根据数据源结构创建目的地新数据表、一键根据数据源表名称自动匹配数据目的地表,一键添加目的地字段,一键应用高级清洗脚本。在多个数据源数百张至几万张数据表数据映射定义的场景中,可以将配置数据映射,应对数据需求的处理时间从 10 分钟缩短至所有表一次操作 10 秒钟完成。
高级清洗数据抽取优化
更新了高级清洗中,样例抽取的逻辑。具体优化内容,请参考配置清洗脚本。