2023年版本更新日志
v4.5
2023-12
功能列表
- 新增功能:
- Gbase 8s 数据源支持 Gbase 8s CDC 增量采集和 JDBC 批量采集
- 数据校验功能支持 TiDB、PostgreSQL 数据节点
- 支持采集 Oracle 多租户容器数据库的增量数据
- 功能优化:
- Kafka 数据源 Topic 支持配置不同的序列化器
- 数据节点、链路、任务列表交互优化
新增功能
新增功能:Gbase 8s 数据源支持 Gbase 8s CDC 增量采集和 JDBC 批量采集
功能背景\ GBase 8s 是天津南大通用数据技术股份有限公司自主研发的、支持共享存储集群、两地三中心部署的、成熟稳定的百 T 金融级国产交易型数据库。适用于 OLTP 应用场景,包括金融、电信行业的关键核心业务系统,安全、党政、国防等行业对信息安全性有较高要求的信息系统,以及大型企业的经营类、管理类信息系统,能够在 80%以上场景中替换国际主流数据库及共享存储集群。Gbase 8s 在四川银行、泸州银行、达州银行等银行系统广泛应用。
使用场景
- 满足业务上实时采集和离线批量采集 Gbase 8s 8.7 数据的要求。
- 配合业务操作流程,实现程序自动捕获并处理 Gbase 8s 数据源的结构变化。
功能说明
- 支持通过 Gbase 8s CDC 的方式实时采集 Gbase 8s 的增量数据
- 支持通过 JDBC 的方式批量采集 Gbase 8s 的全量数据
- Gbase 8s CDC 作为数据源节点时,字段类型的支持情况如下:
| 字段类型 | 是否支持 | |
|---|---|---|
| 1 | BIGINT | 是 |
| 2 | BIGSERIAL | 是 |
| 3 | BYTE | 是,采集此数据需反查数据库,会对数据库造成压力 |
| 4 | CHAR(n) | 是 |
| 5 | CHARACTER VARYING(m,r) | 是 |
| 6 | DATE | 是 |
| 7 | DATETIME | 是 |
| 8 | DECIMAL (p,s) | 是 |
| 9 | DOUBLE | 是 |
| 10 | FLOAT(n) | 是 |
| 11 | INT8 | 是 |
| 12 | INTEGER | 是 |
| 13 | INTERVAL | 是 |
| 14 | MONEY(p,s) | 是 |
| 15 | NCHAR(n) | 否 |
| 16 | NUMERIC(p,s) | 是 |
| 17 | NVARCHAR(m,r) | 是 |
| 18 | REAL | 是 |
| 19 | SERIAL(n) | 是 |
| 20 | SERIAL8(n) | 是 |
| 21 | SMALLFLOAT | 是 |
| 22 | SMALLINT | 是 |
| 23 | TEXT | 是,采集此数据需反查数据库,会对数据库造成压力 |
| 24 | VARCHAR(m,r) | 是 |
| 25 | LVARCHAR | 是 |
| 26 | BLOB | 是,采集此数据需反查数据库,会对数据库造成压力 |
| 27 | BOOLEAN | 是 |
| 28 | CLOB | 是,采集此数据需反查数据库,会对数据库造成压力 |
| 29 | JSON | 是,采集此数据需反查数据库,会对数据库造成压力 |
| 30 | BSON | 是,采集此数据需反查数据库,会对数据库造成压力 |
| 31 | XML | 是 |
| 32 | ROW | 是 |
| 33 | Collection Data Type(Set、List、Multiset) | 否 |
- Gbase 8s 数据源节点支持 DataPipeline 数据源的所有通用功能
新增功能:数据校验功能支持TiDB、PostgreSQL数据节点
- 功能说明
- 支持校验TiDB、PostgreSQL节点的数据条数、数据内容。
- 支持数据校验已支持的全部标准功能。
- 使用限制
- 数据内容校验要求数据源表与数据目的地表都存在主键或唯一索引,且主键字段或唯一索引该字段需要对应
- 数据内容校验不支持包含联合主键或联合唯一索引的表。
新增功能:支持采集 Oracle 多租户容器数据库的增量数据
功能背景
多租户容器数据库是 Oracle 数据库的一种架构。CDB 作为根数据库,PDB作为容器数据库或应用容器数据库,来以一个数据库实例分多租户支撑不同业务。
在历史版本中,为应对多租户数据库,我们需要在对应每一个PDB安装一个采集代理,以采集其增量数据,在PDB数量较多时,会导致采集代理数量过多,带来更多的负载的同时也不好管理。
在新版本中,我们支持了一个采集代理程序采集一个多租户容器数据库实例。
功能说明
- 支持一个采集代理采集多租户数据库中所有租户的增量数据
- 支持多租户数据库与RAC、ADG等部署/高可用架构组合使用,支持高可用切换
- 详见:2.1 管理数据节点 - 添加数据节点 - 数据节点-基础配置 - 配置 Oracle 数据节点
功能优化
- Kafka 数据源 Topic 支持配置不同的序列化器
- 数据节点、链路、任务列表交互优化
v4.4
2023-11
功能列表
- 支持采集DB2、OceanBase 数据源节点的更新前数据
- Kafka数据目的地支持定义 数据源主键变更写入策略
- 系统配置默认值配置功能增强
- Kafka 版本适配
- TiDB数据目的地加载方式优化
- OceanBase 4.x 版本适配
- 支持配置环境变量控制登录滑块验证
新增功能
新增功能:支持采集DB2、OceanBase 数据源节点的更新前数据
功能背景
当前支持采集以下数据源节点的更新前数据:ORACLE、MySQL、GoldenDB、PostgreSQL、DB2、OceanBase、Gbase8c、GaussDB(for openguass)。未支持DB2节点、OceanBase节点。
使用场景
- 用户需要DB2节点、OceanBase节点的更新前数据。
功能说明
- 当用户需要使用DB2的更新前数据时,需要先开启采集before数据的参数。开启后将对新建任务采集数据生效。当历史任务需要采集DB2更新前参数时,请先暂停数据任务,通过调用接口方式修改采集before数据的参数。具体配置请查看《部署前指南》。
- 当数据目的地为Kafka、DataHub时,用户可以通过“写入设置”配置将更新前数据写入“before”字段,将更新后数据写入“after”字段。
- 支持通过配置高级清洗方式获取更新前数据。
新增功能:Kafka数据目的地支持定义 数据源主键变更写入策略
功能背景
- 当数据源主键变更时,DataPipeline历史版本会将一条UPDATE消息拆分为DELETE消息与INSERT消息写入数据目的地。
- 对于部分用户,Kafka 消息中的操作类型表示不同业务含义,历史处理逻辑将影响用户的业务处理。
使用场景
- 数据目的地为Kafka。
- 数据源UPDATE主键后,用户需要将UPDATE操作写入Kafka数据目的地。
功能说明
- 默认写入方式为主键变更后拆分为DELETE消息与INSERT消息写入Kafka。
新增功能:系统配置默认值配置功能增强
功能背景
不同用户对策略的要求不同,以至于用户每新建一个实体都需要逐一配置策略,且用户需要的策略配置基本统一,更改时多为重复操作。因此,DataPipeline 在 v4.4 版本支持策略配置、限制配置的默认值设置。
使用场景
- 对实体的策略配置与限制配置要求基本一致时,可在系统设置中设置默认值。
功能说明
- 在系统设置-系统参数及默认值中可以配置实体的系统配置默认值。配置完成后,新建实体将引用此配置。
功能优化
功能优化:OceanBase 4.x 版本适配
在历史 OceanBase 节点支持的历史功能基础上,针对 OceanBase 4.x 特性,我们新增支持如下功能:
- MySQL 模式
- 作为数据源,全量读取和增量读取均支持采集 JSON 格式数据
- 作为目的地,支持写入 JSON 格式数据,当数据格式不正确时,需进错误列
- Oracle 模式
- 作为数据源,全量读取和增量读取均支持采集 JSON 格式和 XML 格式数据
- 作为目的地,支持写入 JSON 格式和 XML 格式数据,当数据格式不正确时,需进错误列
功能优化:Kafka 版本适配
- 适配 Apache Kafka 3.0.x、3.1.x、3.2.x、3.3.x、3.4.x版本。
- 同时支持作为数据源与数据目的地。
- 适配 华为MRS(3.2.0-LTS.1 版本) Kafka。
- 同时支持作为数据源与数据目的地。
功能优化:TiDB数据目的地加载方式优化
- 功能说明:支持以唯一索引作为数据加载条件更新数据。当数据目的地为TiDB时,更新条件支持:逻辑主键、主键、唯一索引。
- 使用场景:当数据目的地仅有唯一索引时更新数据。
- 功能说明:当数据源为ORACLE、MySQL,数据目的地为TiDB时,解耦数据源主键与数据目的地更新条件。
- 使用场景
- ORACLE、MySQL数据源无主键,仅TiDB存在更新条件时,更新TiDB目的地数据。
- ORACLE、MySQL数据源的主键与TiDB数据目的地的更新条件无同步映射关系时,更新TiDB目的地数据。
- 使用场景
功能优化:支持配置环境变量控制登录滑块验证
- 功能说明:支持配置webservice容器参数,以控制登录时是否需要滑块验证。
- 使用方式:为webservice 配置环境变量:SKIP_CAPTCHA=true。默认值为 false,设置为 true 表示跳过滑块验证,直接登入系统。
v4.3
2023-10
功能列表
- 支持 StarRocks 做数据目的地
- 支持捕获并处理分区结构变化
新增功能
新增功能:支持 StarRocks 做数据目的地
功能背景
StarRocks 是一款高性能分析型数据仓库,使用向量化、MPP 架构、CBO、智能物化视图、可实时更新的列式存储引擎等技术实现多维、实时、高并发的数据分析。StarRocks 既支持从各类实时和离线的数据源高效导入数据,也支持直接分析数据湖上各种格式的数据。StarRocks 兼容 MySQL 协议,可使用 MySQL 客户端和常用 BI 工具对接。同时 StarRocks 具备水平扩展,高可用、高可靠、易运维等特性。广泛应用于实时数仓、OLAP 报表、数据湖分析等场景。
使用场景
- StarRocks 目前支持 2.5 版本,在DataPipeline 4.3 版本中可作为数据目的地使用。
- 作为目的地使用,可以使用 Stream Load 写入方式,将源端的增量和全量数据写入到 StarRocks 目的地。
功能说明
- DataPipeline支持 StarRocks 作为数据目的地。
- StarRocks 作为目的地节点时,对字段类型的支持情况如下:
- 支持的数据类型
| 序号 | 字段类型 | 是否支持 |
|---|---|---|
| 1 | TINYINT | 是 |
| 2 | SMALLINT | 是 |
| 3 | INT | 是 |
| 4 | BIGINT | 是 |
| 5 | LARGEINT | 是 |
| 6 | DECIMAL | 是 |
| 7 | DOUBLE | 是 |
| 8 | FLOAT | 是 |
| 9 | BOOLEAN | 是 |
| 10 | CHAR | 是 |
| 11 | STRING | 是 |
| 12 | VARCHAR | 是 |
| 13 | DATE | 是 |
| 14 | DATETIME | 是 |
| 15 | ARRAY | 否 |
| 16 | JSON | 是 |
| 17 | BITMAP | 是,明细模型不支持此类型 |
| 18 | HLL | 是,明细模型不支持此类型 |
- 支持在数据写入 StarRocks 过程中开启事务
- StarRocks 节点支持 DataPipeline 数据目的地的所有通用功能
新增功能:支持捕获并处理分区结构变化
功能背景
在数据同步过程中,保持源数据库和目标数据库之间数据的一致性是至关重要的。当源数据库分区操作引起表内数据发生变化(比如 truncate partition)时,如果这些操作没有正确在目标数据库处理,可能会导致数据不一致和错误。因此,DataPipeline 4.3 版本支持处理分区结构变化策略。
使用场景
- 源数据库移除分区或清空分区引起数据变化时,可配置此策略。
功能说明
- 当数据源表移除分区或清空分区后,可通过配置策略,在目的地执行相同的分区操作。
功能优化
功能优化:节点版本适配 - CDH 7.1.7平台 3.1.3 版本 Hive,CDH 7.1.7平台 3.1.x 版本 HDFS
- 支持数据源与目的地。
- 支持增量定时获取、指定范围获取 Hive 节点数据。
- 支持增量定时获取 HDFS 节点数据
v4.2
2023-09
功能列表
- 支持批量、实时读取Vastbase G100数据源
- 支持JDBC读取ArgoDB数据源
- TiDB 数据节点版本适配 5.x、6.x
新增功能
新增功能:支持批量、实时读取Vastbase G100数据源
功能背景
Vastbase G100数据库是海量数据基于开源openGauss内核开发的企业级关系型数据库。融合多年对各行业应用场景的深入理解,Vastbase除了具有openGauss极致的性能以外,还在原有功能基础上增加了大量Oracle和Mysql兼容特性。
使用场景
- Vastbase G100作为数据源的增量数据同步
- Vastbase G100作为数据源的全量数据同步
- Vastbase G100作为数据源的全量+增量数据同步
功能说明
- 支持版本:Vastbase G100 V2.2.10
- 支持节点认证方式:口令认证、SSL认证
- 支持数据读取方式:逻辑复制、JDBC
- 功能限制:「逻辑复制」读取方式仅支持解析字符集为utf-8的行存表,不支持解析列存表,不支持间隔分区表、全局临时表。
新增功能:支持JDBC读取ArgoDB数据源
功能背景
ArgoDB 是星环自主研发的分布式分析型数据库,可以替代 Hadoop + MPP 的混合架构。我们使用标准的 SQL 语法支持用户业务的建设,并且能够给用户提供多模型数据分析、实时数据处理、存储与计算模块解耦、异构服务器混合部署等先进技术能力。用户可以通过一个 ArgoDB 数据库,实现其数据仓库业务、实时数据仓库业务、数据集市业务、OLAP 数据分析业务、事务型分析型业务混合负载业务、异构数据联邦分析计算业务等各种场景的建设需求。
DataPipeline在历史版本支持了通过文件写入方式向ArgoDB数据目的地写入数据,此次4.2版本支持ArgoDB数据库作为数据源,通过JDBC读取方式获取数据。
使用场景
- ArgoDB作为数据源的全量同步
- ArgoDB作为数据源 定时同步指定范围的数据
功能说明
- 支持版本:ArgoDB 5.2
- 支持JDBC读取方式。
- 支持读取ArgoDB 5.2版本所有存储模式的表。
功能优化
功能优化:节点版本适配 - TiDB 5.x、6.x
在过去的版本中,DataPipeline 已支持 TiDB 2.x、3.x、4.x 版本,在新版本中,我们支持了 5.x、6.x 版本。
- 支持数据源与目的地。
- 支持实时数据获取、增量数据获取。
v4.1
2023-08
功能列表
- 支持Rename DDL场景
- 支持定义批量数据同步批次完成标识
- 支持在Kubernetes环境部署
新增功能
新增功能:支持Rename DDL场景
功能背景及使用场景
在业务系统中,如数据表存量数据较大,执行Alter table增加字段、变更字段类型等结构变化时间会造成较长时间的锁表,业务上通常不允许关键数据表不可用时间较长。因此,数据源在进行结构变化时,通常会通过执行“多次Rename”进行表替换操作,以减少结构变更时间。
在过去的版本中,DataPipeline并不支持这种结构变化场景,需要修正数据,需要手动刷新结构并重新同步数据,在数据目的地,数据不可用的时间较长。
功能说明
DataPipeline 产品在4.1版本中,新增支持“数据源重命名正在同步的表” DDL场景,提供删除重建目的地表、恢复索引权限、全量刷新数据的选项。全自动化处理这种结构变化,对下游数据应用的影响由之前的数小时降低至几秒钟。
新增功能:支持生成批次同步完成标识
功能背景
在过往版本中,客户使用DataPipeline同步的批量数据时,往往需要根据历史同步所需时间来判断数据是否同步完成,是否达到可用状态,整个过程低效且不精确。为提升客户对数据的使用效率,DataPipeline在4.1版本引入了批量数据同步完成生成标识的功能。
使用场景
- 下游数据可用性判断: 下游业务部门需要明确知道何时可以开始使用最新批次的数据。批量同步完成标识充当了一个关键的信号,当标识文件出现时,下游业务知道数据已经完全可用,可以开始使用。
- 数据同步一致性保障: 批量同步完成标识充当一致性的依据,确保数据同步操作是在完全成功的情况下才被视为完成。
功能说明
- 在批量同步场景下支持生成标识。即任务同步方式为“增量同步”,执行方式为“监听模式”,或任务同步方式为“全量同步”。
- 支持同步完成后生成标识文件,或将同步完成信息写入标识表。
- 支持在任务中所有映射同步完成后生成标识,同时支持每条映射同步完成后生成标识。
- 当数据目的地为文件系统,配置批次同步完成标识后,数据源读取批次数据完成时DataPipeline将立即向文件系统目的地写入数据文件。即启用同步完成标识后DataPipeline不再按照数据链路配置的「新建文件大小限制」或「写入时间限制」规则对数据文件进行拆分或合并。
- 标识表或标识文件记录信息如下:
| batch_count | 批次同步数据量 |
|---|---|
| batch_end_time | 批次结束时间 |
| batch_index | 批次序号 |
| batch_start_time | 批次开始时间 |
| batch_time_cost_ms | 批次耗时 |
| created_at | 记录时间 |
| done_mark_type | 标识维度,T 表示任务维度标识,M 标识映射维度标识 |
| id | 自增id |
| mapping_id | 映射id |
| sink_database | 数据目的地数据库名称 |
| sink_node_id | 数据目的地节点id |
| sink_schema | 数据目的地Schema名称 |
| sink_table_name | 数据目的地表名称 |
| src_database | 数据源数据库名称 |
| src_node_id | 数据源节点id |
| src_schema | 数据源Schema名称 |
| src_table_name | 数据源表名称 |
| task_id | 任务id |
新增功能:支持在Kubernetes环境部署
功能背景及使用场景
在以前的版本中,DataPipeline不支持容器编排平台的部署功能,
越来越多的商业客户,已经部署了开源或者定制的容器管理平台,支持多种应用层的服务冗余和自动切换。有些已使用DataPipeline产品的客户,期望DataPipeline能够部署到自管理的Kubernetes平台上,以实现数据服务的多节点冗余和自动接管。
功能说明
DataPipeline 产品在4.1版本中,新增支持在Kubernetes集群环境上的部署功能,满足更加自动化、可扩展和高可用的容器管理功能。当某台虚机/服务器发生故障时,基于Kubernetes部署的DataPipeline产品,能自动切换到Kubernetes集群中其它节点继续运行,不影响正在进行或者未完成的数据同步任务。
在4.1版已经实现的功能中,缺省配置同一后台功能组件的三个容器实例同时运行,可以有效保证后台组件的高可用性,产品支持NFS共享存储和Calico网络配置。
功能优化
- 预警信息优化-支持自定义参数(时间、随机数)拼接至预警消息体
v4.0
2023-07
功能列表
- 支持 TDSQL-MYSQL 做数据目的地
- 支持 ArgoDB 做数据目的地
- 支持实时解析 GoldenDB 数据源
- 支持 JDBC 方式采集 DB2 for i (AS/400) 数据源
- 支持为 TiDB 数据目的地表配置逻辑主键
- 支持为 底层存储为文件型数据节点配置16进制ASCII分隔符
新增功能
新增功能:支持 TDSQL-MYSQL 数据目的地
功能背景
布式数据库 TDSQL是腾讯打造的一款企业级数据库产品,具备强一致高可用、全球部署架构、高 SQL 兼容度、分布式水平扩展、高性能、完整的分布式事务支持、企业级安全等特性,同时提供智能 DBA、自动化运营、监控告警等配套设施,为客户提供完整的分布式数据库解决方案。
TDSQL MySQL版(TDSQL for MySQL)是一种支持自动水平拆分、Shared Nothing 架构的分布式数据库。提供公有云和专有云、纯软件(独立)部署、一体机(柜)等多种部署方案,可以提供集中式数据库实例、分布式数据库实例。同时 TDSQL具备虚拟化多租户、强同步复制、线程池、热点更新、内核优化等能力,能够为用户提供事前、事中、事后的全维度安全方案,并获得多项国际和国家认证。
使用场景
- TDSQL MYSQL目前支持10.3.19.x版本,在 DataPipeline 4.0 版本中可作为数据目的地使用。目前支持 5.2 版本,在DataPipeline 4.0版本中可作为数据目的地使用。
- 作为目的地使用,可以使用JDBC写入方式,将源端的增量和全量数据写入到 TDSQL MYSQL目的地。
功能说明
- 支持通过JDBC连接到TDSQL MYSQL节点进行数据的写入
- 支持 TDSQL MYSQL 分布式、集中式实例,支持 MYSQL 5.7 和 MYSQL 8.0 内核
- TDSQL MYSQL 作为目的地节点时,对字段类型的支持情况如下:
| 序号 | 字段类型 | 是否支持 |
|---|---|---|
| 1 | TINYINT | 是 |
| 2 | SMALLINT | 是 |
| 3 | MEDIUMINT | 是 |
| 4 | INT | 是 |
| 5 | BIGINT | 是 |
| 6 | FLOAT | 是 |
| 7 | DOUBLE | 是 |
| 8 | DECIMAL | 是 |
| 9 | NUMERIC | 是 |
| 10 | CHAR | 是 |
| 11 | VARCHAR | 是 |
| 12 | BINARY | 是 |
| 13 | VARBINARY | 是 |
| 14 | BLOB | 是 |
| 15 | TEXT | 是 |
| 16 | TINYBLOB | 是 |
| 17 | TINYTEXT | 是 |
| 18 | MEDIUMBLOB | 是 |
| 19 | MEDIUMTEXT | 是 |
| 20 | LONGBLOB | 是 |
| 21 | LONGTEXT | 是 |
| 22 | ENUM | 是 |
| 23 | SET | 是 |
| 24 | YEAR | 是 |
| 25 | TIME | 是 |
| 26 | DATE | 是 |
| 27 | DATETIME | 是 |
| 28 | TIMESTAMP | 是 |
| 29 | JSON | 是 |
- TDSQL 节点支持 DataPipeline 数据目的地的所有通用功能
新增功能:支持 ArgoDB 数据目的地
功能背景
ArgoDB 是星环自主研发的分布式分析型数据库,可以替代 Hadoop + MPP 的混合架构。我们使用标准的 SQL 语法支持用户业务的建设,并且能够给用户提供多模型数据分析、实时数据处理、存储与计算模块解耦、异构服务器混合部署等先进技术能力。用户可以通过一个 ArgoDB 数据库,实现其数据仓库业务、实时数据仓库业务、数据集市业务、OLAP 数据分析业务、事务型分析型业务混合负载业务、异构数据联邦分析计算业务等各种场景的建设需求。
Q:从数据库架构来看, ArgoDB 和 Inceptor 很相似,请问这两者的区别是什么,在什么情况下推荐使用 Inceptor ,在什么情况下推荐使用 ArgoDB 。
A:场景上: Inceptor 更多用于做湖仓, ArgoDB 用于做湖仓集一体,另包含实时数仓、AETP等。功能上 ArgoDB 更全面;性能是 Inceptor 2-10倍(不同场景)
使用场景
- ArgoDB 目前支持 5.2 版本,在DataPipeline 4.0版本中可作为数据目的地使用。
- 作为目的地使用,可以使用文件写入方式,将源端的增量和全量数据写入到 ArgoDB 目的地。
功能说明
- DataPipeline支持 ArgoDB 作为数据目的地。
- ArgoDB 作为目的地节点时, ArgoDB 文件写入支持写入内表,暂不支持向外表写入数据。对于不同的内表引擎类型,支持情况如下表:
| 表类型 | 是否支持 |
|---|---|
| ORC 事务表 | 是 |
| ORC 非事务表 | 是 |
| HOLODESK 内表 | 是 |
| TEXTFILE 内表 | 否 |
| SEQUENCEFILE 内表 | 否 |
| RCFILE 内表 | 否 |
| PARQUET 内表 | 否 |
| HYPERDRIVE 内表 | 是 |
| HYPERBASE 内表 | 是 |
| ESDRIVE 内表 | 否 |
| SEARCH 内表 | 否 |
- ArgoDB 做目的地节点时,对字段类型的支持情况如下:
| 序号 | 字段类型 | 是否支持 |
|---|---|---|
| 1 | TINYINT | 是 |
| 2 | SMALLINT | 是 |
| 3 | INT | 是 |
| 4 | BIGINT | 是 |
| 5 | FLOAT | 是 |
| 6 | DOUBLE | 是 |
| 7 | DECIMAL(m,n), DECIMAL (默认为 DECIMAL(10,2)) | 是 |
| 8 | BOOLEAN | 是 |
| 9 | STRING | 是 |
| 10 | CHAR(n) | 是,Hyperbase、Hyperdrive表不支持此类型 |
| 11 | VARCHAR(n) | 是 |
| 12 | VARCHAR2(n) | 是,Hyperbase、Hyperdrive表不支持此类型 |
| 13 | DATE | 是 |
| 14 | TIMESTAMP | 是 |
| 15 | TIME | 是,Hyperbase、Hyperdrive表不支持此类型 |
| 16 | BLOB | 是 |
| 17 | CLOB | 是 |
- ArgoDB 节点支持 DataPipeline 数据目的地的所有通用功能
新增功能:支持实时解析 GoldenDB 数据源
功能背景
GoldenDB 是中兴通讯研发的的关系型分布式数据库产品,产品深耕金融、政企等行业,采用无共享架构,融入中兴通讯多年的数据库研发经验,为用户提供了高可用、高可靠、可扩展的“大数据+分布式数据库”解决方案;满足 OLTP 类应用,同时兼顾OLAP数据处理要求,提供统一的基础数据服务平台,有利于提升业务创新能力和用户体验。
使用场景
- GoldenDB 在DataPipeline 4.0版本中可作为数据源使用。
- 以下版本支持通过JDBC方式采集批量数据:GoldenDB 5.2.01、GoldenDB 5.2.02、GoldenDB 5.2.03、GoldenDB 6.1.01 、GoldenDB 6.1.02、GoldenDB 6.1.03。
- 以下版本支持通过GoldenDB CDC方式采集实时数据:GoldenDB 6.1.02、GoldenDB 6.1.03。
功能说明
- 支持通过JDBC连接 GoldenDB 节点读取批量数据。
- 支持通过GoldenDB CDC方式采集GoldenDB节点实时数据。
- 支持 GoldenDB 节点相关语义映射、结构变化策略、数据加载策略。
- 支持 GoldenDB 分布式部署模式,集中式部署模式。
新增功能:支持 JDBC 方式采集 DB2 for i (AS/400) 数据源
功能背景
历史版本DataPipeline支持使用IBM InfoSphere Data Replication方式采集DB2 for i (AS/400) 数据。实际使用过程发现,在IBM InfoSphere Data Replication获取全量数据时,如果表有数据写入,IBM InfoSphere Data Replication可能会对表添加共享锁,导致刷新订阅报错,无法获取增量数据。
基于此问题,DataPipeline 4.0版本支持通过JDBC方式连接DB2 for i (AS/400)并获取全量数据,避免表被锁导致数据同步中断。
使用场景
- JDBC读取模式支持DB2 for i (AS/400) 7.1版本。
功能说明
- 支持通过JDBC连接到 DB2 for i (AS/400) 节点读取批量数据
- 支持分别配置全量读取模式与增量读取模式。全量读取模式支持JDBC与IBM InfoSphere Data Replication,增量读取模式支持IBM InfoSphere Data Replication。
- JDBC模式支持分片读取全量数据,提升全量数据获取的速率。
v3.7
新年伊始,万象更新,在2023年开年之际,我们迎来了DataPipeline 3.7版本的发布。2023年3月,我们对3.7版本功能做了丰富和增强。
版本目标
- 支持产品备份和灾难恢复
- 多源异构能力增强
- 可观测性功能增强
稳定性建设是 DataPipeline 在产品迭代过程中不断打磨的重要方向,在3.7版本中,我们在产品层面提供了产品备份和灾难恢复方案,为系统稳定提供了强有力的保障。在可观测性上,我们丰富了监控维度和监控指标、数据校验中增加了内容校验功能、新增在产品页面查看组件日志的功能,产品的整体可观测性能力得到了稳步提升。同时,当前版本新增支持了ClickHouse数据节点、DataHub数据目的地、阿里云DRDS(PolarDB)数据源、GaussDB(OpenGauss内核)数据源。
新增功能
新增功能:DataPipeline 产品备份及灾难恢复方案
功能背景
核心数据对分析系统供数,交易数据支撑反洗钱、反欺诈场景都离不开实时数据。随着实时数据连续性要求越来越高,数据融合产品的多机房容灾能力也成为了保障业务连续的重要组成部分。DataPipeline 产品一直以来为客户提供分布式高可用保障,在此之上建立多地多机房数据融合灾备能力,可以保障在灾难场景下的实时数据不断。
使用场景
由于人为或自然原因,造成信息系统严重故障、瘫痪或其数据严重受损,使信息系统支持的业务功能停顿或服务水平达到不可接受的程度,并持续特性时间的突发事件发生时,为了规避灾难带来的损失和保证信息系统所支持的关键业务功能在灾难发生后能及时恢复和继续运作,可以使用DataPipeline 产品灾备方案恢复业务。
功能说明
DataPipeline 灾难恢复方案(以下简称灾备方案)满足一类系统的灾备需求等级,支持数据同步系统 RTO < 30分钟、RPO < 5分钟,支持同步的数据 RTO < 30 分钟、RPO = 0。
灾备方案可以分为以下几个大模块
- 灾备环境搭建与配置:指根据灾备需求、网络与地理区域限制,制定灾备部署架构设计,并对灾备环境进行配置调整。
- 数据备份:对数据同步进度、状态、配置、监控、错误队列数据进行备份。
- 灾难恢复:指灾难恢复过程中的程序后台手动灾备切换方案、自动灾备切换方案、Web交互式灾备切换方案。
- 灾后重建:指灾难恢复后灾备系统的重建工作,包括备份程序重建、备份数据恢复、手动业务切换流程。
- 在灾难发生时,我们支持基于对主机群的状态检测或外部系统触发的自动灾备切换;同时也支持手动灾备切换的程序后台交互、Web页面交互。
新增功能:支持数据列表达式计算
功能背景
不同数据源的建成部门、年代、技术栈、数据标准不同,其数据格式与数据内容都会存在一定差异。在数据应用过程中,需要统一的数据标准。因此数据同步过程中也需要对数据进行一定的加工处理。在之前的版本中,我们支持通过高级清洗脚本(Java code)对单条数据进行清洗转换;虽然代码的适应场景广泛,清洗逻辑定义开放程度高,但使用门槛较高,对于用户的编程能力有一定要求。在3.7版本中,我们支持了通过对数据列编辑表达式,转换数据值、添加元数据信息的功能,降低了数据处理过程中的使用难度;同时表达式编辑逻辑与SQL代码类似,也在数据处理过程中有一定灵活性。
使用场景
对单条数据的值处理、元数据信息补充等场景,包括但不限于:
- 添加数据源数据表元数据信息
- 数据源库、表、Schema、字段、字段类型等信息
- 添加数据同步过程的处理元数据信息
- 采集日志位点
- 任务激活时间、名称等信息
- DML标识
- 写入时间标识
- 对数据值进行逻辑转换
- 加减乘除
- 数值绝对值、进制、取整处理
- 字段值筛选处理
- 字符串处理
- 时间类型处理
- 空值处理
- 根据条件取值(case when)
- 取随机值
- 正则匹配
功能说明
在数据映射-字段映射配置中,可以对目的地字段进行值转换配置。

在编辑表达式过程追踪,可以引用源表字段、采集元数据、DataPipeline 系统处理元数据,并通过操作符与功能函数对数据进行处理。
在完成表达式编辑后,系统会识别表达式中引用的数据信息,并在样例数据中展示;样例数据提供手动编辑样例数据与从数据源获取样例的功能。
试运行可以帮助我们调试表达式,运行结果与反馈将会呈现至页面中。
在表达式编辑过程中,可以参考文档说明,查看元数据信息含义、操作符与功能的具体效用。
在我们完成表达式编辑之后,开启表达式使用并保存配置即可使表达式生效,与此同时,我们可以保存常用表达式脚本进入脚本库,方便在不同场景进行复用。
新增功能:数据任务支持分映射设置同步进度
功能背景
在数据任务执行配置上,我们支持了针对全量同步、日志监听模式增量同步、增量识别字段模式增量同步、全量增量衔接等场景的同步方式配置。为了使任务选择映射的方式不受同步方式影响,在新版本中我们推出了映射设置同步起点的功能。
使用场景
在任务中已有多张数据表在进行增量同步,其中有一张表需要重新拉历史数据。
在任务中已有多张数据表在进行增量同步,现在上游新增了一张表,需要全量铺底后增量同步,这些数据表因业务要求需要组织在一个任务里。
在任务中已有多张数据表在进行增量同步,其中一张表需要忽略一段时间的增量数据,以当前时间点为起点同步数据。
功能说明
我们可以在数据任务-执行配置中选择分映射指定同步起点,在映射配置中,给每条映射分别设置同步起点或批量指定起点。根据数据源与目的地的特性不同,支持的同步起点设置不同,包括:全量初始化、使用暂停时进度(任务暂停时出现)、激活任务时间为起点。
新增功能:支持调整系统默认设置
功能背景
在实际数据同步场景中,我们可能需要对接数十个数据源,每个数据源数百数千张数据表,映射量级10w+,任务量级1000+。面对如此规模的配置操作,DataPipeline 秉持用户至上的设计理念,想法设法的帮助用户简化操作流程,减少重复操作步骤。
在之前的版本中,我们针对数据映射配置场景、节点链路任务管理场景提供了批量操作、配置默认值设置、智能映射匹配设置等多种广受一线用户好评的功能。现在DataPipeline 将枪口对准了配置繁复的另一大阻碍:各项配置默认值。
使用场景
在拥有全局统一的数据标准、数据同步任务资源占用标准的前提下,对数据任务并发占用、语义映射转换逻辑进行全局规则配置。
功能说明
通过对语义映射转换逻辑的全局规则配置,可以调整系统默认语义映射规则,应用至不同节点类型,如不针对特定数据节点、链路做语义映射策略调整,语义转换将会按照系统语义映射规则执行。
在配置数据映射过程中,语义转换将会依照链路层语义映射策略>节点层语义映射策略>系统默认语义映射的规则完成数据语义转换。
通过对数据任务限制配置默认值调整,可以限制数据任务并发数量与任务选择映射数量相同,或为固定值。并对所有数据任务添加统一的限制配置默认值,方便应用。
新增功能:Oracle 采集代理图形化监控
功能背景
在之前的版本中,DataPipeline 提供了对 Oracle 采集代理日志、预警的统一配置与查看。
在3.7版本中,Oracle 采集代理的状态、速率、延迟等监控信息被统一整合到了数据节点采集代理监控页面,为Oracle 采集代理的运维管理提供便利。
功能说明
监控指标列表
| 指标 | 指标说明 |
|---|---|
| 已解析日志量 | 累计值,指采集代理自上次启动以来解析的日志量,单位kb |
| 日志解析速率 | 速率值,指随时间变化的采集代理解析日志的速率,单位kb/s 因日志中不是所有数据都会同步,不代表同步速率/传输速率 |
| 解析进程积压时间 | 时间值,指采集代理当前处理到的日志时点与最新日志时间的时间差值,单位ms |
| 采集代理重启 | 状态值,指采集代理自动重启事件在时间轴上的呈现,不会统计手动重启 |
| 系统处理延时-P95 | 时间值,指采集代理自身的处理延迟,在采样时间段内P95置信区间内的延时表现,可以理解为统计意义平均值,单位ms |
| 系统处理延时-MAX | 时间值,指采集代理自身的处理延迟,在采样时间段内的最大值,单位ms |
| 系统处理延时-MIN | 时间值,指采集代理自身的处理延迟,在采样时间段内的最小值,单位ms |
| 采集代理延迟(数据库事务提交时间-数据写入缓存时间) | 时间值,指采集代理数据处理的整体延迟,计算方式为数据库事务提交时间-数据写入缓存时间的差值,单位ms |
| 缓存写入速率 | 速率值,指采集代理写入缓存的写入速率,单位kb/s |
| 采集代理事务处理数量 | 累计值,指采集代理自上次启动以来处理的事务数量,单位个 |
新增功能:支持数据内容一致性校验
功能背景
DataPipeline作为企业级的数据融合平台产品,数据质量管理尤为重要。在用户使用DataPipeline过程中,有时会出现数据丢失情况。由于产品前期未提供同步数据质量管理功能,导致用户无法直接得知数据同步情况,丢失数据往往是由下游数据使用方反馈,用户无法主动对数据质量情况进行把控,丢失数据处理也变得被动且滞后。
V3.7版本基于数据任务提供数据内容校验功能,帮助用户及时发现差异数据,针对差异数据进行处理。
使用场景
在对数据一致性高要求的场景下,您可以为对应的数据任务配置数据内容校验,验证数据任务同步的可靠性。
V3.7版本支持全量数据校验,在数据源持续有增量数据写入的情况下,直接校验全量数据得到的校验结果通常都存在差异(由于同步速率导致在同一时刻数据源与数据目的地数据不一致)。
所以,当前版本数据校验适用于以下场景:
- 数据源与数据目的地数据均无变动,这种场景下可以进行全量数据内容校验,且能够获得准确的校验结果。
- 数据源与数据目的地均有校验条件限制字段,如数据变更时间字段。以时间为条件限制校验范围,如校验五分钟前的数据。
功能说明
- 支持的数据节点
| 支持数据量校验的节点类型 | 支持数据内容校验的节点类型 | 其他要求 |
|---|---|---|
| Oracle、MySQL、Postgresql、DB2、SQLServer、DM、Inceptor、OushuDB、Hive、Elasticsearch | Oracle、Mysql、OushuDB、DB2、DM、SQLServer | 1. 数据内容校验要求数据源表与数据目的地表都存在主键,且主键字段需要对应 2. 数据内容校验不支持含有联合主键或联合唯一索引的表。 |
- 支持用户输入校验条件(where条件语句)来限定校验范围。
- 支持用户指定校验字段,如仅校验主键字段数据。
- 支持配置预警策略,获取校验结果通知,以及校验异常通知。
- 支持查看校验历史结果。
新增功能:支持ClickHouse数据目的地节点
功能背景
ClickHouse 是 Yandex(俄罗斯最大的搜索引擎)开源的一个用于实时数据分析的基于列存储的数据库,其处理数据的速度比传统方法快 100-1000 倍。ClickHouse 节点适配是DataPipeline多源异构能力增强的重要组成部分。
使用场景
- ClickHouse 目前支持20.x与22.x版本,在DataPipeline 3.7版本中可作为数据目的地使用。
- 作为目的地使用,可以使用JDBC写入方式,将源端的增量和全量数据写入到 ClickHouse 目的地。
功能说明
- 支持通过JDBC连接到 ClickHouse 节点进行数据的写入
- 支持 ClickHouse 节点相关语义映射、结构变化策略、数据加载策略
- 支持数据写入 ClickHouse 目的地时清空目的地
- 支持 ClickHouse的多种表引擎
- DataPipeline单机部署(8核32G),写入ClickHouse的写入性能可达11.52M/s
新增功能:支持Datahub做目的地
功能背景
阿里云流式数据服务DataHub是流式数据(Streaming Data)的处理平台,提供对流式数据的发布 (Publish),订阅 (Subscribe)和分发功能,让您可以轻松构建基于流式数据的分析和应用。
使用场景
- DataPipeline 3.7版本支持阿里云 Datahub 最新版本,可作为数据目的地使用。
功能说明
- 支持向Tuple类型、BLOB类型Topic写入数据。
- 支持创建新Topic、选择已有Topic。
- 支持向BLOB类型Topic写入JSON格式数据,支持定义数据结构。
新增功能:支持阿里云DRDS(PolarDB)做数据源
功能背景
PolarDB-X 是阿里巴巴自主设计研发的高性能云原生分布式数据库产品,为用户提供高吞吐、大存储、低延时、易扩展和超高可用的云时代数据库服务。
PolarDB-X 节点适配是DataPipeline多源异构能力增强的重要组成部分。
使用场景
- DataPipeline 3.7版本支持 PolarDB-X 1.0,可作为数据源使用。
- BINLOG读取方式支持读取实时增量数据,JDBC读取方式支持定时读取存量数据。
功能说明
- 支持通过BINLOG读取方式读取 PolarDB-X 增量数据。
- 支持 PolarDB-X 节点相关语义映射、结构变化策略、数据加载策略。
- DataPipeline单机部署(8核32G),读取PolarDB-X的速率为 3.8 M/s
新增功能:支持GaussDB(OpenGauss内核) 数据源的实时采集
功能背景
GaussDB(for openGauss)是华为公司倾力打造的自研企业级分布式关系型数据库,具备PB级数据负载能力,同时支持优异的分布式事务,通过内存分析技术满足海量数据边入库边查询要求,适用于安全、电信、金融、物联网等行业的详单查询业务。
GaussDB(for openGauss) 节点适配是DataPipeline多源异构能力增强的重要组成部分。
使用场景
- GaussDB(for openGauss) 目前支持1.4、2.0、2.3版本,在DataPipeline 3.7版本中可作为数据源使用。
- 逻辑复制读取方式支持读取实时增量数据,JDBC读取方式支持定时读取存量数据。
功能说明
- 支持 GaussDB(for openGauss) 集中部署模式,分布式部署模式。
- 支持通过逻辑复制方式读取 GaussDB(for openGauss) 增量数据。
- 支持 GaussDB(for openGauss) 节点相关语义映射、结构变化策略、数据加载策略。
- DataPipeline单机部署(8核32G),读取GaussDB(for openGauss)的速率可达18.52M/s
新增功能:产品首页-任务概览监控信息优化
功能背景
为了方便用户观察 DataPipeline 产品中任务的整体运行情况,让管理人员实时了解到现有业务的发展情况和异常问题,缩短发现特征信息的时间,DataPipeline 3.7版本提供了任务状态、实时任务延时情况、同步数据处理情况的集中展示功能。
使用场景
业务方需要了解 DataPipeline 同步任务的任务状态、实时任务延时情况、同步数据处理情况。
功能说明
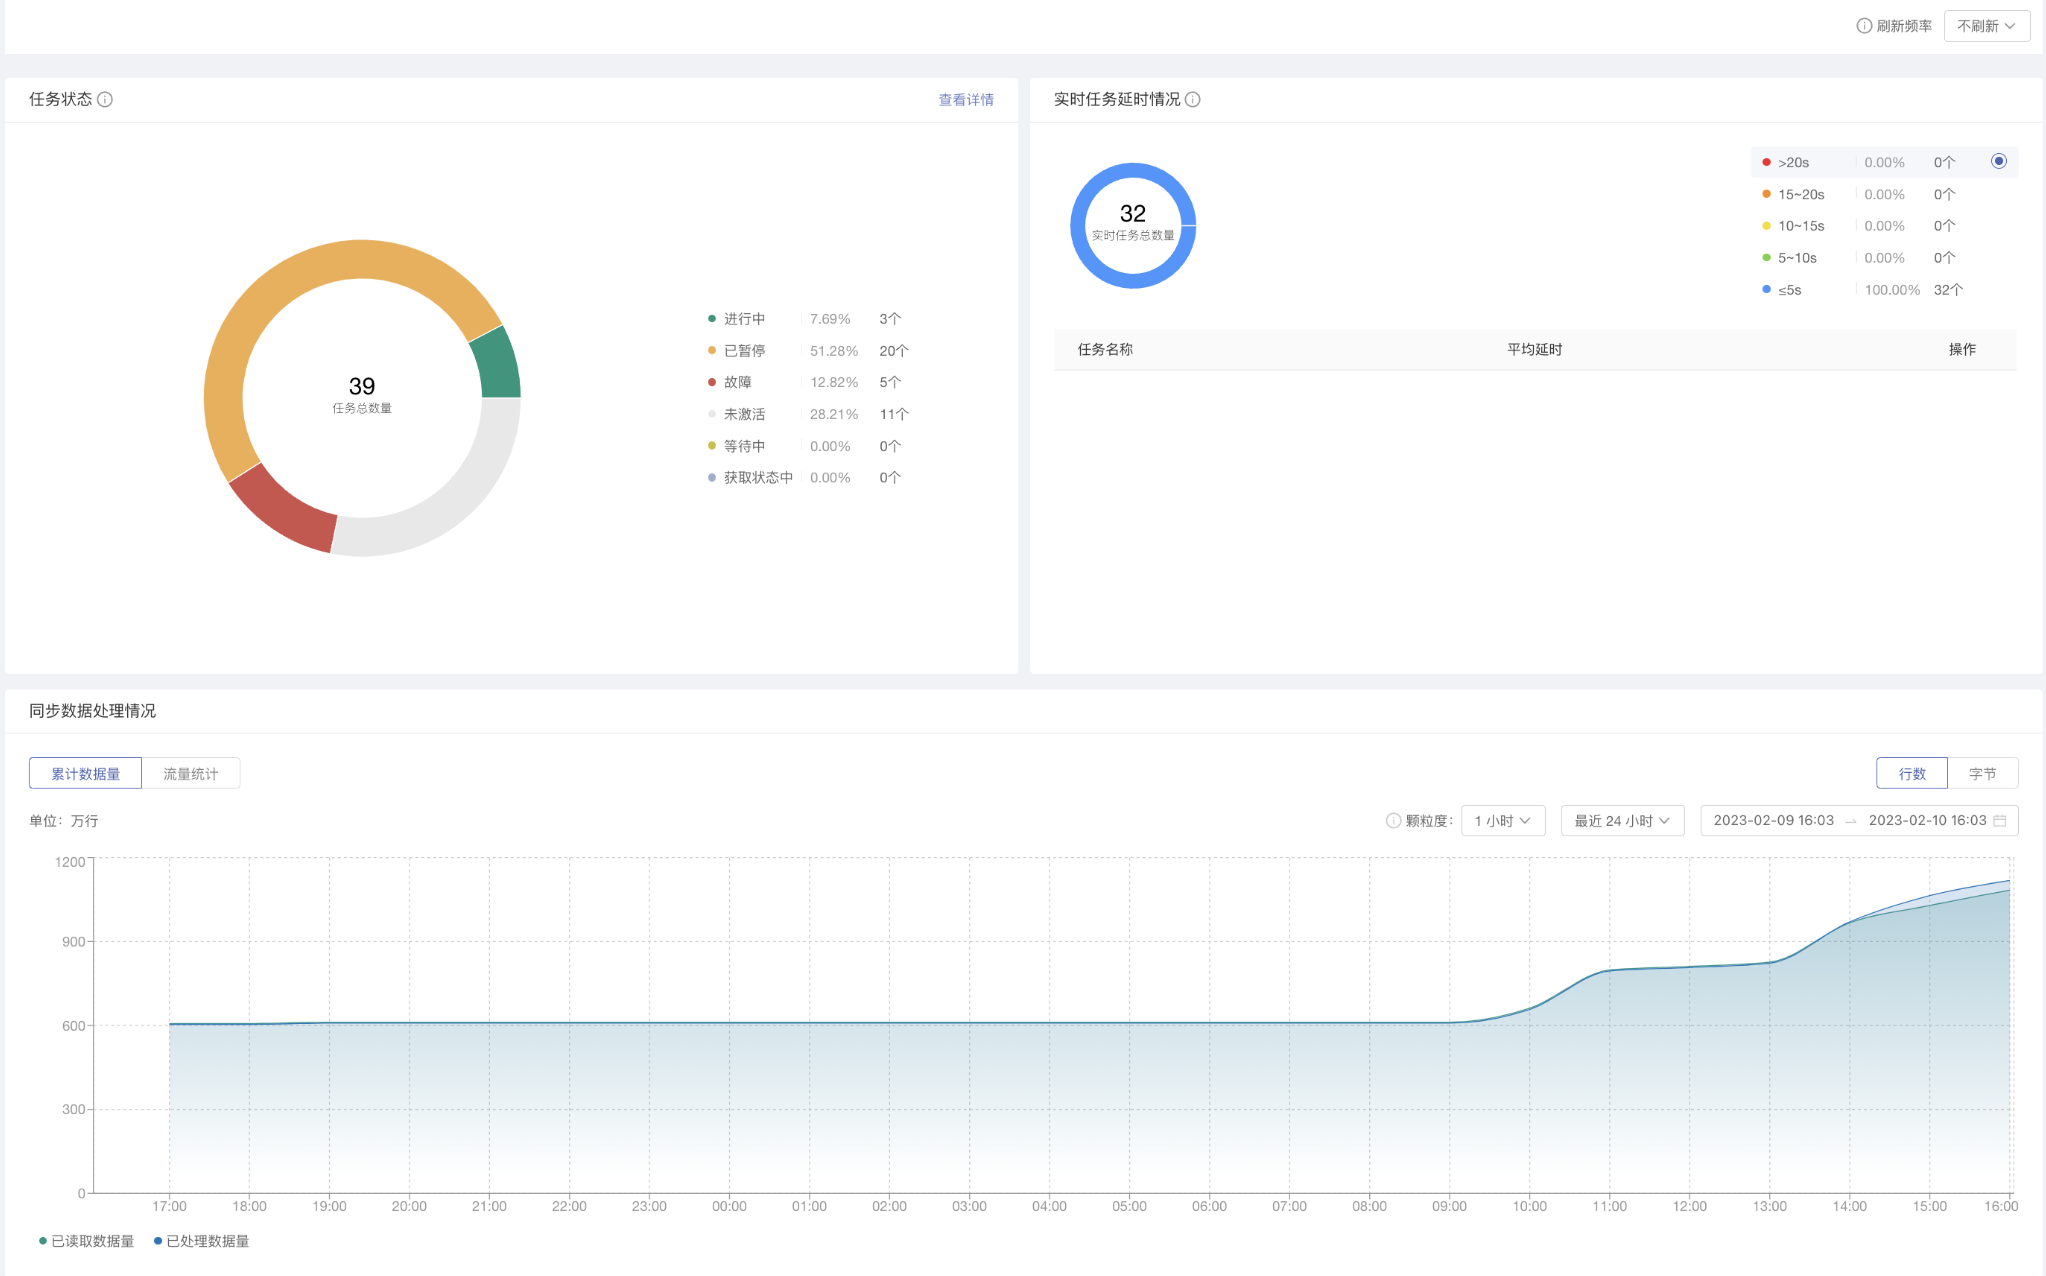
任务状态:支持查看系统内所有任务的运行状态,并跳转至任务列表页,分类查看任务列表
实时任务延时情况:支持查看系统内所有实时任务的延时情况,并分类查看任务列表
同步数据处理情况:支持查看系统内所有任务的同步数据量之和,支持查看的质保是累计数据量和流量。
新增功能:数据任务监控图表优化-DML数量、DDL数量及趋势展示
功能背景
在以往的版本中,DataPipeline提供了任务维度的累计数据量、同步速率、批次数据量的监控与图标展示。客户的实际使用场景中,每个任务会配置成百上千条映射,每天会同步千万级的数据。
为了在庞大的数据中,更快速直观的获取到客户关心的特征信息,DataPipeline 3.7版本中,我们提供了任务维度和映射维度的流量统计、DML事件统计等与业务紧密相关的统计指标。
使用场景
- 业务上需要获取不通过维度、不同粒度、不同时间段内的流量、DML事件、DDL事件及变化趋势信息
| 维度 | 指标 | 指标释义 |
|---|---|---|
| 任务 | 累计数据量 | 累计数据量指截至到某个时间点,当前任务的同步数据的总和。 |
| 流量统计 | 流量统计指在一定的统计粒度下,当前任务同步的数据量。 计算方法:结束时间的累计数据量与开始时间的累计数据量的差值。 | |
| 同步速率 | 同步速率指单位时间内当前任务同步的数据量。 | |
| 批次处理 | 批次数据量监控了一个批次同步的数据量。 | |
| 结构变化数据 | 用于监控在任务同步过程中处理的结构变化数量。 | |
| 事务数据 | 事务处理监控主要对当前任务同步的事务数量的统计。 | |
| 运行状态 | 任务监控中的任务运行状态体现任务运行过程中的真实状态,其中,暂停中、激活中等中间状态会被抽象为等待中状态。 | |
| 映射 | 累计数据量 | 累计数据量指截至到某个时间点,当前映射的同步数据的总和。 |
| 流量统计 | 流量统计指在一定的统计粒度下,当前映射同步的数据量。 计算方法:结束时间的累计数据量与开始时间的累计数据量的差值。 | |
| 同步速率 | 同步速率指单位时间内当前映射同步的数据量。 | |
| 事务数据 | 事务处理监控主要对当前任务同步的事务数量的统计。 | |
| 增量延时统计 | 增量延时统计指当前映射数据目的地写入增量数据的延迟统计,将以图表形式展示单位时间内的延迟情况。 | |
| 源表 | 单条数据预估大小 | 单条数据预估大小指获取系统表中获取单条数据的平均大小。 |
| 单条数据平均大小 | 单条数据平均大小指已读取数据的平均大小。 | |
| 最新数据产生时间 | 最新数据产生时间指最后一条写入目的地的数据,在源表中的产生时间或数据采集时间。 - 日志解析模式:取数据产生时间的最大值 - 文件系统:取文件更新时间 - 其他:取数据采集时间的最大值 |
功能说明
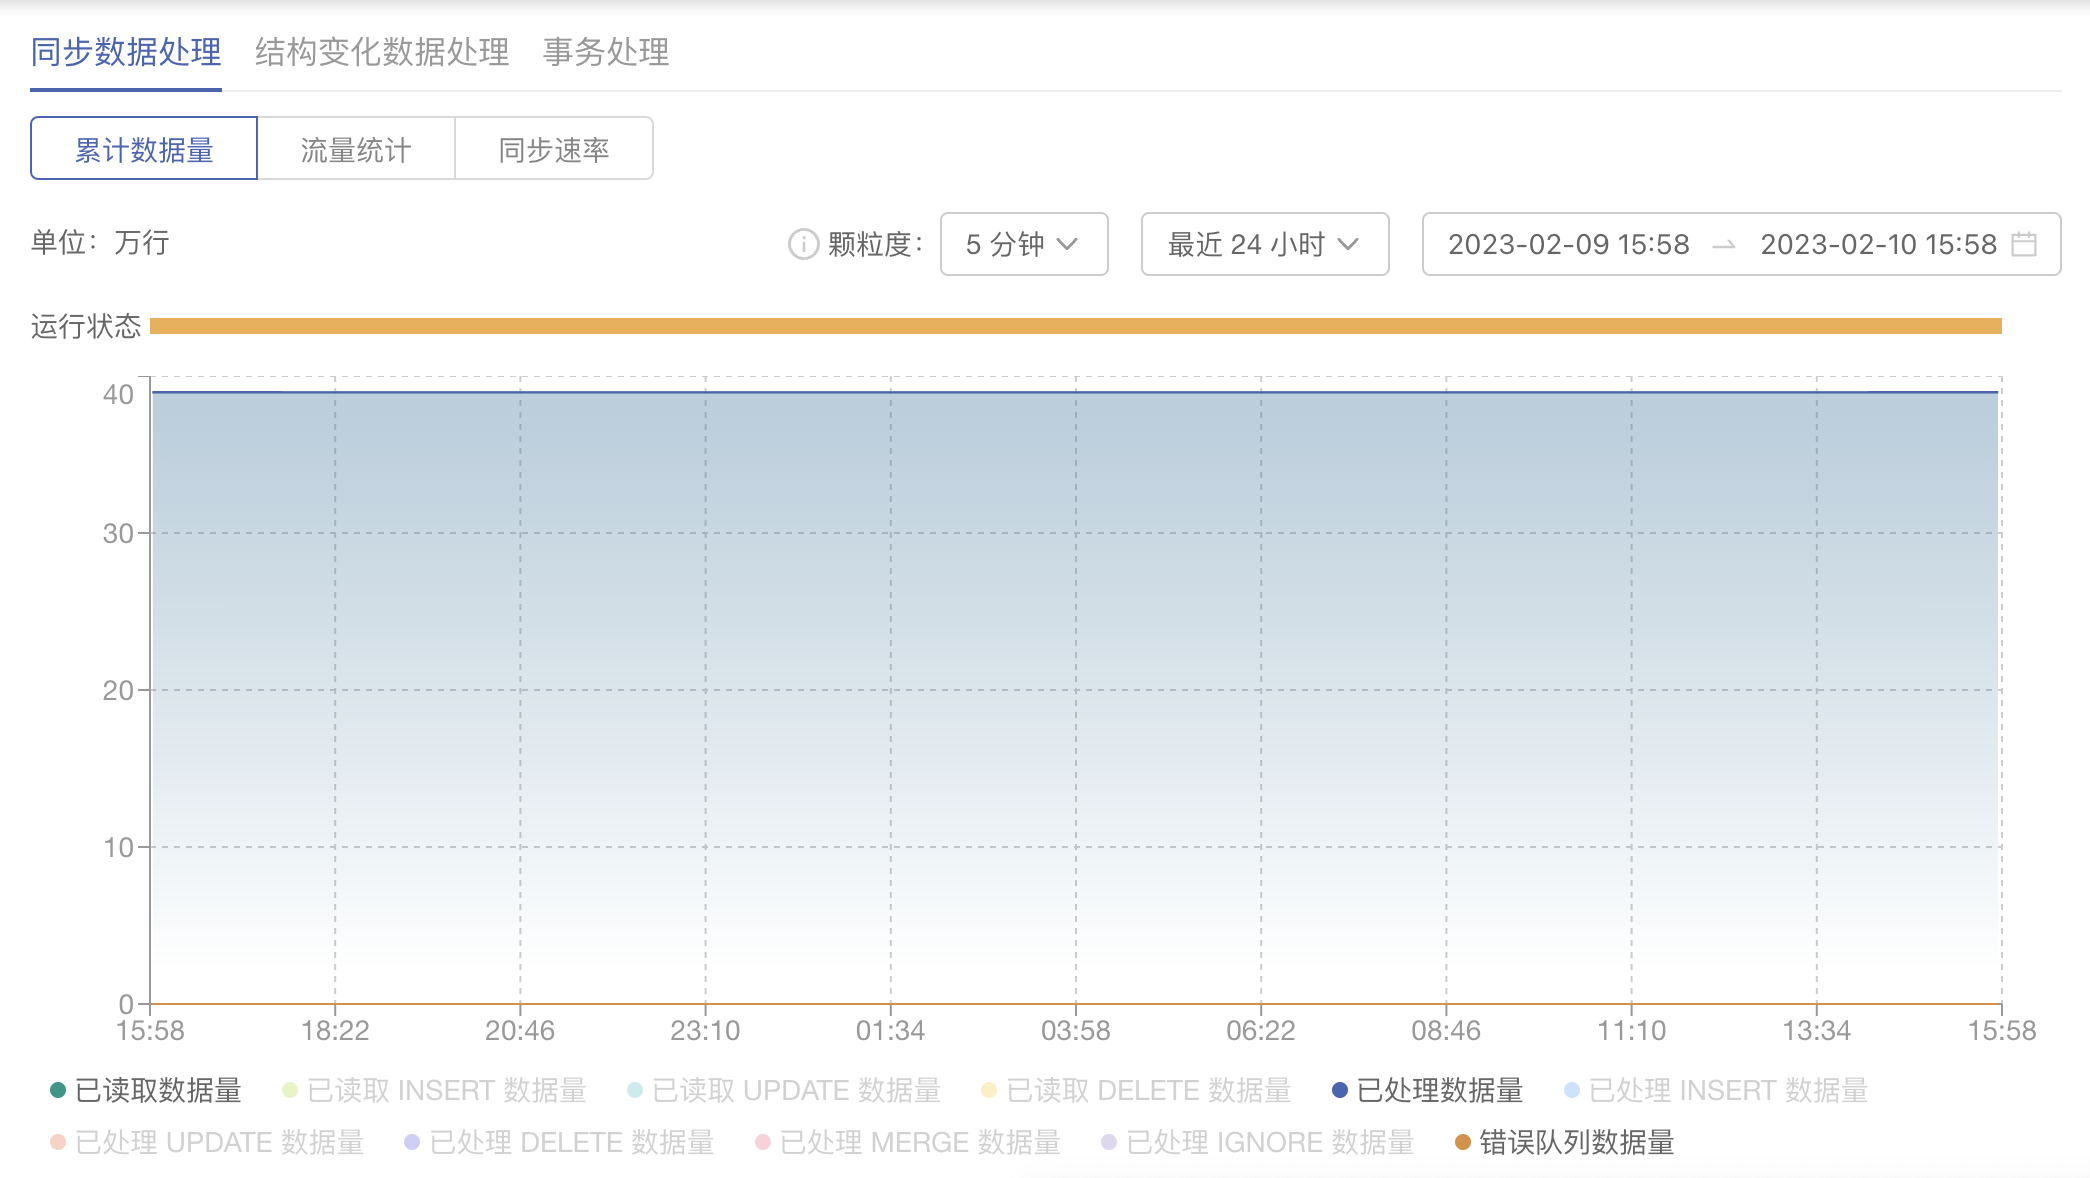
您可以切换颗粒度和时间范围,查看不同数据汇总粒度和时间范围内的图像和指标变化趋势
您也可以通过开关图例来查看指定指标对应的图像数据及变化趋势。
新增功能:支持差异数据查询
功能背景
当前客户的数据应用体系日益完善,DataPipeline作为数据融合系统参与到客户的整个数据处理链条中。在不同数据处理系统分工协作的场景下,当数据使用方发现数据异常时,用户想要在多个系统间迅速定位问题出现环节往往需要付出很多时间成本。
使用场景
- 数据下游反馈数据丢失或错误情况后,通过差异数据查询功能,验证数据在DataPipeline每一环节处理情况。
功能说明
- 错误数据查询功能支持用户指定数据查询条件,反映数据在DataPipeline内部处理情况,从而便于定位错误数据产生环节,针对性的对问题进行处理。
- 当前支持数据源为Oracle、Mysql、DB2,数据目的地为Kafka 时进行数据查询。
功能优化
功能优化:Kafka功能增强:支持创建Topic、优化写入设置、支持删除重建/清空Topic
功能背景
在数据实时处理需求日益旺盛的情况下,Kafka作为高吞吐量、低延迟,持久性好的消息中间件被广泛使用,在我们的客户群里中,有大量客户使用DataPipeline将Kafka节点作为数据目的地同步数据,所以Kafka目的地数据写入的灵活性配置尤为重要。在往期版本中,DataPipeline不支持新建Kafka Topic ,不支持将数据写入指定分区,导致此类问题需要手动解决或者修改代码解决。
功能说明
- 支持在数据链路配置新增Topic
- 支持数据写入指定分区
- 支持配置数据写入Kafka时转换大小写
- 支持启动数据任务时清空Topic数据或删除重建Topic。
功能优化:支持全局配置kafka目的地节点数据映射参数
功能背景
在实际数据同步场景中,我们可能需要对接数十个数据目的地,每个数据目的地成百上千张数据表,映射量级10w+,任务量级1000+。面对如此规模的配置操作,DataPipeline 秉持用户至上的设计理念,想法设法的帮助用户简化操作流程,减少重复操作步骤。
而在数据实时处理需求日益旺盛的情况下,Kafka作为高吞吐量、低延迟,持久性好的消息中间件被广泛使用,在我们的客户群里中,有大量客户使用DataPipeline将Kafka节点作为数据目的地同步数据,所以Kafka目的地数据映射参数的灵活性配置尤为重要,DataPipeline 3.7版本中,我们优先针对Kafka目的地提供了数据映射参数默认值的配置。
使用场景
在拥有全局统一的数据标准前提下,对Kafka目的地数据映射各项参数进行全局默认值配置。
功能说明
为方便用户灵活配置,DataPipeline数据目的地数据映射的参数有两套生成规则。通过”映射设置“规则生成的数据映射,其参数将自动应用”映射设置“的参数。通过手动点击”创建新表“、”匹配已有表“生成的数据映射,其参数为系统提供的默认参数。
当前提供全局配置kafka目的地节点数据映射参数后:
- 新建kafka目的地数据链路,”映射设置“参数会应用系统配置默认值。
- 在数据链路手动点击”创建新Topic”、“选择已有Topic”生成的映射,“写入设置”的参数以及新建Topic的参数会应用系统配置默认值。
功能优化:日志优化-展示与排查任务报错相关的所有日志
功能背景
数据同步任务在运行过程中发生异常时,需要去查看与任务相关的程序运行日志,在以往版本中,只能去服务器查看,对用户来讲并不友好。为了缩短用户排查问题的操作路径,DataPipeline在3.7版本中提供了核心组件运行日志查询功能。
使用场景
任务运行过程中发生异常,需要查看connector和manager的运行日志排查问题。
功能说明
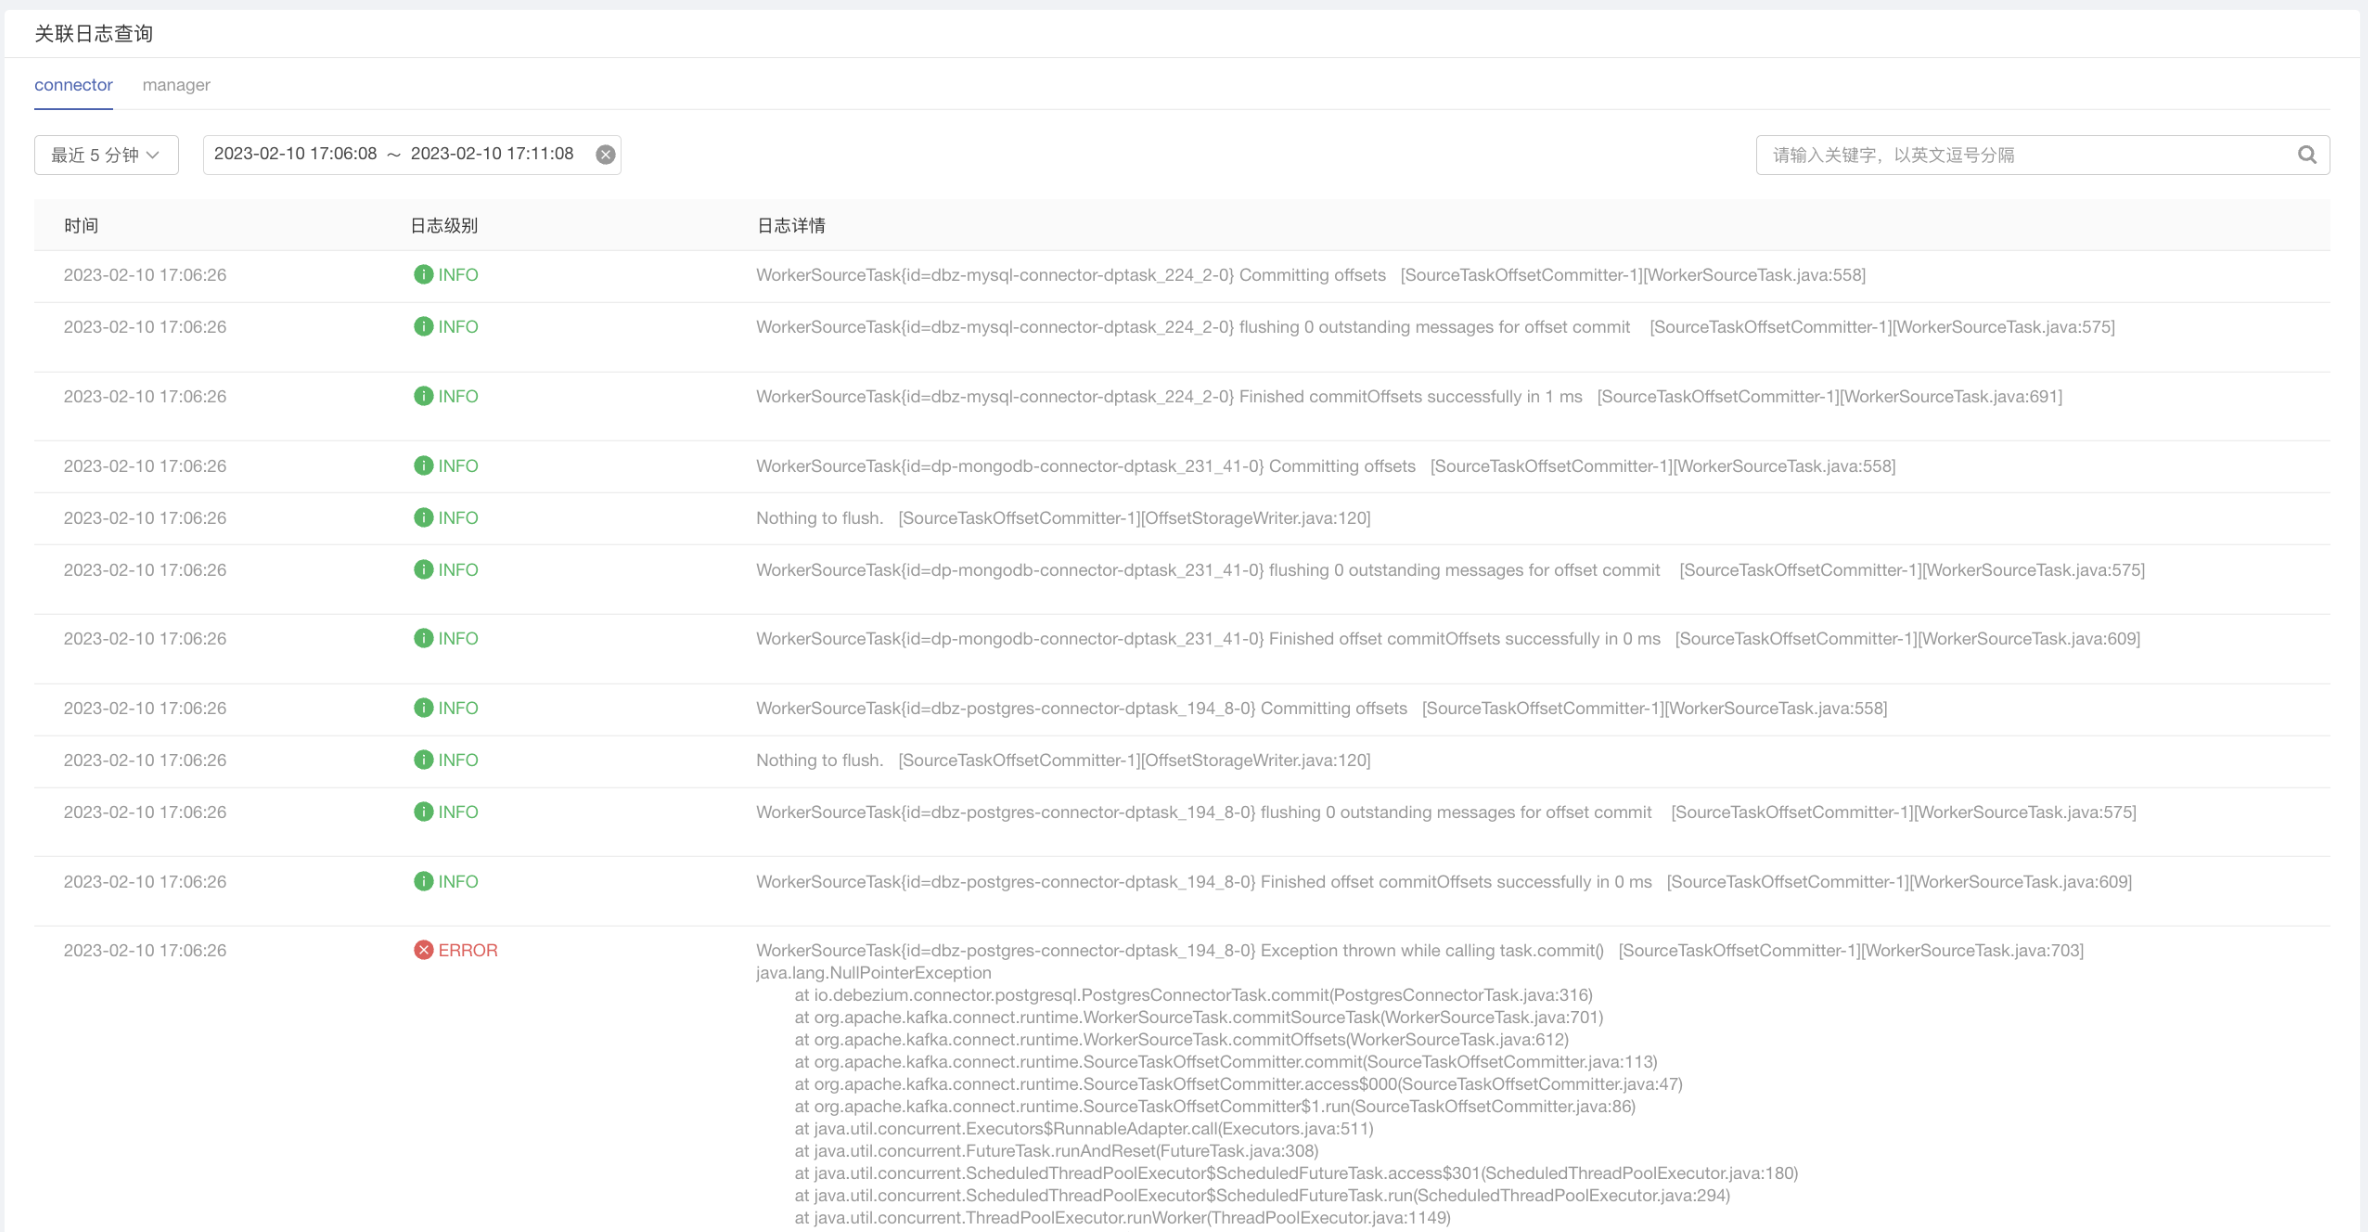
您可以通过调整时间范围、输入关键字查询特定日志。
功能优化:数据一致性校验-并发与资源组设计
功能背景
当用户使用DataPipeline校验成百数千张数据量超大的表时,如何才能提高校验的速度,使用户更快得知校验结论。而当提升校验性能的同时,如何避免数据校验任务占用过多DataPipeline内部资源,从而影响数据同步任务的稳定性。这是当前版本解决的问题。
使用场景
当频繁进行大数据量表的数据内容校验时,可以通过添加校验专用资源组来避免校验任务影响同步任务运行的情况。
功能说明
- 数据校验的读取并发限制作用于校验过程并发校验表的数量。当读取并发限制为”与映射数量相同“时,并发数量的最大值为校验映射的数量。
- 并行校验表的数量受限于系统资源组设置。
- 当前版本对资源组类型进行了划分:
- 源端资源:仅支持数据任务读取数据源数据时使用。
- 目的地资源:仅支持数据任务向目的地写入/处理数据时使用。
- 通用资源:同时支持数据同步任务读取与写入数据、数据校验任务读取与校验数据使用。DataPipeline V3.5及V3.5前期的版本区分”源端资源“、”目的地资源“,DataPipeline V3.6及V3.6后期版本在读取数据及写入数据时将统一使用”通用资源“。
- 校验资源:仅支持数据校验任务读取与校验数据使用。
其他功能优化:
- 优化数据任务选择映射交互
- 优化预警webhook内容
- 支持通过数据表名搜索链路、任务
- 支持修改/删除用户,并记录审计日志
- 适配Hive 1.1.0+cdh5.12.2+1218
- 适配华为HDFS
- 优化采集代理预警逻辑,添加状态变化预警指标、日志补全检查预警指标