V3.4 新版本说明
正文
东风洒雨露,会人天地春。DataPipeline 在 4 月迎来了 V3.4 版本更新。
在 3.4 版本中,我们对数据结构变化场景、数据一致性场景等数据同步过程中的核心技术进行了增强;同时对索引、字符集、注释等数据语义特性
版本目标
- 增强 DDL 处理能力
- 增强数据语义处理全面性
新增功能
新增 Create table、Truncate table、Rename Column DDL 对应的结构变化策略
功能背景
DDL 的处理能力是产品的一大核心竞争力。也是业界在异构数据库的同步场景中,最难处理和解决的一部分。同时我们也看到在信创的大背景下,能否处理 DDL,也逐渐成为了数据同步中间件产品的入门门槛。而不断提升多元异构的处理能力,也一直在 DataPipeline 的长期发展的路线图中,因此在多方面需求的背景下,我们在 3.4 版本,迎来了 DDL 结构变化处理的里程碑式的增强。
使用场景
当上游发生了各种 DDL 变化时,下游需要根据 DDL 的类型,甚至具体的 DDL 变化,来做相应的处理。因此 DataPipeline 针对 DDL 从源端解析获取,再到目的地端执行,提供一整套完备的处理机制和流程。来满足用户对于上游发生 DDL 变化的各种处理。
1 如何获取 DDL?
在 V3.4 版本中,对于 create table ,rename column,truncate table,采用了日志解析的方式感知。而对于 add column ,drop column,alter table(字段类型,精度,标度变化),则仍然沿用之前的 schema diff 的方式感知,drop table 则采用定时请求的方式获取。从这里可以看出 DP 已经提供了多样的方式感知源端的 DDL 变化。未来也会更多的从日志中解析 DDL 变化,从而更早的感知到来自于源库的所有 DDL 变化。
2 目的地针对 DDL 变化的执行策略有哪些?
当上游的 DDL 变化被 DP 的采集系统感知到后,会发送到下游进行 DDL 变化的处理。DP 根据数据库的特性以及企业管理应用,提供了 3 种处理模式。 第一种当发生该 ddl 变化后,暂停任务,由业务人员确认,是否要应用。这主要面对管理要求严格的业务线。对于数据库的元数据管理有着严格管控要求的业务线。 第二种当发生该 DDL 变化后,忽略。此时任务将忽略该 DDL 变化,继续同步。这主要是下游系统有很严格的管理要求,同时,下游明确知道此阶段或者此任务上游可能处于会增加与我业务系统不相关的冗余字段或者冗余变化。那就可以采用忽略的策略。 第三种当发生该 DDL 变化后,在下游执行该 DDL 变化。这主要是上下游系统要求做备份,或者要完全 copy 一份 ods 层的数据,因此希望提供一份与上游有相同变化的数据。此时可以采用执行该 DDL 变化。
3 如果 DDL 执行失败如何处理?
当通过系统在目的地执行该 DDL 变化,可能由于权限原因,或者数据库目的地锁的原因,发现无法执行成功时,该执行失败的 DDL 会记录在任务的 DDL history 里,您可以手动在下游数据库执行后,在这里忽略掉该 DDL 变化,然后继续执行任务。避免失败的 DDL 阻断同步任务进行。
功能说明
本版本中,将增强 Mysql 和 oracle 的 DDL 解析能力,可以通过日志解析获取到 Create table,Truncate table,rename column 三种 DDL 的变化。而在目的地则在原有基础上,加强了文件系统,以及 NoSQL 类型数据库的 DDL 处理能力。详情可以参见 DDL 结构变化说明。
Exactly Once 一致性支持(Beta)
功能背景
在数据同步过程中,数据一致性通常包括两种形式:
- 完整一致性(Exactly once)
- 最终一致性(At least once)
通常情况下,数据同步工具提供最终一致性支持,即可满足大部分业务场景要求,即至少向目的地写入一次增量数据,重复写入由目的地数据库的主键/唯一键保证结果幂等;在数据同步领域内,各厂商默认提供最终一致性功能。
DataPipeline 在之前的版本中,在功能逻辑层面提供了最终一致性的数据保障;但深挖本源、技术驱动的企业灵魂告诉我们,在技术上不断突破、提升,提供更好的技术方案保障客户数据任何情况下完整一致是我们不懈的追求。
因此,端到端一致性策略跟大家见面了。
使用场景
在数据源与目的地都有主键/唯一键的情况下,如发生部分增量数据重复执行,如一条 update 被执行两次,数据源与目的地数据是幂等的,即最终一致性(At least once)是可以被保障的;在您将数据写入数仓、数据平台以供数据分析使用的场景中,可以不开启端到端一致性选项,产品默认保证数据的最终一致性。
在数据源数据与目的地数据都要求严格时序一致,不能出现重复执行数据更新等场景时,完整一致性(Exactly once)功能是必须的,您可以开启端到端一致性选项,保障数据一致性。
功能说明
在数据任务增量数据同步执行过程中,实时数据处理将被转换为一个一个连续的小 batch,每个 batch 的读取写入都以应用事务机制保障。
当读取写入任一环节出现失败情况,事务被回滚,任务会从之前的记录进度位点开始下一次事务读取写入。
在一个 batch 中,事务机制需要持久化读取进度与写入进度,对于关系型数据库目的地,进度将被持久化至目的地数据表;对于文件系统目的地,进度将被持久化至系统关系型数据库组件。
对于文件系统目的地,每个 batch 的数据会先被写入至临时数据目录,当完成全部读取与写入后,临时数据目录文件将会被挪移至正式目录,并在系统中持久化写入进度。
因此,对于不同类型的数据目的地,配置项会有所不同。
详情参见 huan-cun-ce-lve-1.md
数据映射支持配置目的地表索引
功能背景
持续提高对多元异构的节点支持是产品持续的发展路线,对于表特性来说,索引作为重要的语义特性,可以提高数据检索速度、保证数据的唯一性、并可以实现表仪表之间的参照完整性。在很多客户的实际场景中的表都建有索引。在之前的版本中,只支持部分节点的主键、唯一索引的同步,新版本对不同的数据节点的特性进行了支持,不仅支持了不同节点的多种索引类型,也支持了多种索引存储方式如 hash 索引、B-tree 索引等。
使用场景
当数据源的表有索引时,能够完整的同步相关索引到目的地,并可以对目的地新建表创建索引,保证表同步前后的一致性和完整性。
功能说明
DataPipeline 支持部分类型节点的表索引的同步,并支持新建表索引。同时提供了索引同步策略,以提高一些全量同步场景下的同步效率。
数据源索引:
支持节点类型:MySQL、Oracle、PostgreSQL、MS SQL Server、Db2、TiDB、Teledb、HashData、AWS RDS for PostgreSQL
当上述节点作为数据源时,支持读取相关数据源的索引信息及索引变化。
数据目的地索引:
支持节点类型:MySQL、Oracle、PostgreSQL、MS SQL Server、Db2、Greenplum、TiDB、openGauss、Gauss 200、Telepg、AWS RDS for PostgreSQL、Amazon RedShift
新建表:当上述节点作为数据目的地时,支持根据源端索引信息自动映射目的地索引信息,并支持新建和编辑索引信息。
选择已有表:当上述节点作为数据目的地时,支持读取相关目的地索引信息及索引变化。
数据映射支持字符集映射
功能背景
在过去的版本中,DataPipeline 处理写入目的地数据字符集的方式是将数据编码为目的地节点字符集,这样的处理方式能够保证写入目的地数据不乱码。但部分节点如 MySQL、Tidb、Teledb,支持灵活配置表级别、字段级别字符集,这种情况下如果表或字段的字符集与节点字符集不一致,可能发生数据写入失败的情况。
使用场景
为全面支持语义特性,DataPipeline3.4 版本支持配置 MySQL、Tidb、Teledb 节点表级别,以及字段级别的字符集。
功能说明
3.4 版本支持对 MySQL、Tidb、Teledb 目的地进行表级别、字段级别的字符集配置。DataPipeline 提供对字符集映射的默认规则 。
对于无表级别字符集的数据节点,如 ORACLE、MYSQL、PostgreSQL 等节点,DataPipeline 写入数据时会根据目的地节点字符集自动编码数据,无需人为操作。
对于文件类型数据节点,DataPipeline 支持配置文件写入的编码方式。
新增支持达梦 8 数据节点
功能背景
DM8 是达梦公司在总结 DM 系列产品研发与应用经验的基础上推出的新一代自研关系型数据库。DM8 融合了分布式、弹性计算与云计算的优势,在灵活性、易用性、可靠性、高安全性等方面进行了大规模改进。另外,多样化架构可以充分满足不同场景的需求,支持超大规模并发事务处理和事务-分析混合型业务处理、支持动态分配计算资源,具有资源利用更加精细化、成本投入更低的优点。
使用场景
Datapipeline 支持读取 DM8 数据库的全量与增量数据。支持通过 JDBC 方式连接到 DM8 数据库中进行批量数据读取,同时支持以 JDBC 方式将数据写入到 DM8 数据库中。
功能说明
DataPipeline 3.4 版本支持 DM8 版本的达梦数据库,通过 JDBC 方式进行数据的读取与写入。在产品配置中,您只需配置数据库连接信息,并将系统所需权限赋予 DataPipeline 访问数据库的用户,即可通过配置节点、链路、任务获取到需要同步的数据信息。
新增支持 Hudi 数据目的地
功能背景
Hudi 是一种数据湖的存储格式,在 Hadoop 文件系统之上提供了更新数据和删除数据的能力以及消费变化数据的能力。Hudi 提供表、 事务、高效的 upserts/deletes、高级索引、 流式摄取服务、数据集群/压缩优化和并发,同时将数据保持为开源文件格式。
使用场景
DataPipeline 支持将源端数据变更实时写入 Hudi 目的地,在增量数据同步到 Hudi 的同时,也支持将数据映射至 Hive,以供 Hive 方便的进行实时视图查询。
功能说明
DataPipeline 3.4 版本支持 0.9.0 版本以上的 Hudi,通过 Hudi JAVA Client 将源端增量数据写入 Hudi 目的地,您无需额外部署 Spark、Flink 等计算引擎。在产品配置中,您只需配置 Hive 连接信息,开启数据映射至 Hive 功能后,在 Hive 端就能够实时获取到增量数据。
新增支持易鲸捷 xTP 数据源
功能背景
易鲸捷 QianBase xTP 是分布式数据库 2.0 时代的产品,采用云原生分布式架构,可支撑未来银行基本所有交易型业务和少量分析业务。其最大优势在于完全去中心化的架构设计,通过分布式数据库的高安全性,解决国产 IT 底座不够稳定的问题,是目前我国重要行业关键业务系统实现全栈技术安全替换的最佳解决方案。
使用场景
DataPipeline 支持读取易鲸捷 QianBase xTP 数据库的全量与增量数据。在易鲸捷 xTP 数据库作为交易系统数据库时,DataPipeline 可以通过 QianBase xTP CDC 功能,将增量数据抽取出来并同步至任何 DataPipeline 支持的数据目的地,以供下游业务方使用。
功能说明
DataPipeline 通过与易鲸捷公司的深度技术合作,通过调用 QianBase xTP CDC 功能获取增量数据并写入缓存,DataPipeline 的融合引擎将缓存的增量数据写入下游。在产品配置中,您只需将 CDC 功能需要的权限赋予 DataPipeline 访问数据库的用户,通过配置节点、链路、任务即可获取增量数据。
新增支持阿里云 OSS 数据节点
功能背景
阿里云 OSS 是文件系统类型的数据库。被广泛用在阿里系的生态产品中,在构建数仓,数据湖,OLAP,AI 分析,实时计算等诸多场景中,都成为解决方案中,存储部分最关键的一环。同时 OSS 还具备了海量存储,持久性,安全性高,成本低,智能存储等优点。
使用场景
DataPipeline 支持通过 SDK 读取阿里云 OSS 数据库的对象存储的文件。其中全量读取,将从指定路径定时读取全量数据。增量读取,则可以通过配置表达式的方式,从表达式所映射的路径下,增量读取文件。通常情况下, 会以日期(天)或者序列号为增量判断条件。 同时也支持通过 SDK 写入到阿里云 OSS 数据库中,写入时支持 CSV,Parquet,Avro 的文件类型,并且支持写入动态目录 业务调度,支持配置读取标识文件来控制读取逻辑。同时作为目的地时,当映射完成后,也支持配置路径,写入标识文件,方便业务系统调度。
支持通过 FTP 客户端进行文件读取,支持读取 CSV、Json 类型文件的定时全量读取,并支持定义带参数的源表,且支持定时读取该源表中的增量文件; 支持通过 FTP 客户端进行文件写入,支持将源端数据写入 FTP 目的地端的 CSV、Json 类型文件,并且支持写入动态文件目录; 支持配置读取标志文件来控制读取逻辑。
功能说明
DataPipeline 通过对文件类型系统的深刻认识以及对于业务场景应用的深刻理解,除了同其他已经支持的文件类型的节点(HDFS,FTP 等)一样,读取时提供全量读取,增量读取;写入时,则可以指定文件类型,并且指定文件的写入路径。您可以通过访问控制列表(ACL)给存储空间和对象授予访问权限,包括公共读写,公共读,私有三种权限。
新增支持逻辑主键场景映射配置
功能背景
部分用户现场源端数据表和目的地已有表由于历史原因无主键字段,这种情况下 DataPipeline 无法基于主键进行同步。在过去的版本中,用户通过人为在数据目的地将多个字段聚合配置主键来解决这个问题,但在实际的同步场景中,这种方法配置过程繁琐,且无法保证数据目的地不出现重复数据。
使用场景
逻辑主键的使用场景通常是数据源没有主键,但需要按照数据源主键进行增量同步的情况。
功能说明
DataPipeline 支持您在数据源与数据目的地标记字段为逻辑主键,但不会修改数据源与数据目的地的表结构,逻辑主键仅在 DataPipeline 数据同步内部使用。目前支持为 ORACLE 节点配置逻辑主键。
- 当数据源为 ORACLE 节点类型时,在数据源表没有主键的情况下,DataPipeline 支持您标记字段为逻辑主键,按照逻辑主键同步增量数据。
- 当数据目的地为 ORACLE 节点类型时,在新建表的情况下,DataPipeline 支持您标记字段为主键或逻辑主键。在选择目的地已有表的情况下,如果已有表没有主键,DataPipeline 支持您标记已有表字段为逻辑主键。
DP 内部数据追踪功能
功能背景
DataPipeline 系统可使用 Kafka 作为缓存组件 ,但如果发现数据同步出现延迟、数据丢失情况时往往难以判断数据是在哪个环节丢失,工程师需要手动连接 kafka 集群查看数据消费情况,定位问题的步骤往往繁杂而冗长。
功能说明
DataPipeline 内部数据追踪功能提供页面化的 Topic 消费信息查询,可查询的 Topic 包括 ORACLE 采集代理 Topic、数据任务 Topic、DataPipeline 系统内部 Topic。您可通过在页面指定数据消费起点、查询条件,查询数据消费情况
任务延迟监控
功能背景
以往版本用户无法直观的看到增量数据写入数据目的地的延迟情况。
使用场景
增量数据任务查看数据写入延迟。
功能说明
增量任务延迟监控功能将统计该增量任务中每条映射数据写入目的地的延迟时间,您可通过每条映射的延迟统计图表直观看到数据写入时间波动,用以观测性能、稳定性指标。
数据任务及系统提供导出报表功能
功能背景
客户无法通过一个报表知道系统的全面信息和状况,不便于统计分析与汇报
使用场景
每天或每月可以对系统进行巡检,通过导出报表分析系统、节点、链路、任务的各种信息指标来了解该系统的全面状态
功能说明
系统设置新增导出报表的功能,可以选择导出一段时间(最近 24 小时、最近一周、最近一个月)的系统信息、用户信息、节点信息、链路信息、任务信息,直接页面下载相关 Excel 文件到客户端进行分析和汇报
功能优化
优化数据映射多对一(分库分表合表)场景配置
功能背景
在老版本的数据映射中,支持配置多对一的表映射,但是目的地需要一张一张的单独选表,无法批量选择同一张表,且多对一关系的字段映射也是相互独立的,无法批量配置,而大多数用户多对一场景下,字段映射的关系大多一致,导致在用户多对一场景中需要做很多重复的操作,降低了用户体验和配置效率。
使用场景
当用户想将多张源表中的数据同步到目的地同一张表时,可以通过数据映射处多对一聚合的功能,快速完成配置。在分库分表同步到目的地同一张表时,由于源表结构一致,可以配置一张源表到目的地表的字段映射复用至其他所有表,大大减少了配置任务的时间。
功能说明
3.4 版本支持在数据映射表映射页面选择多张源表进行“多对一聚合”操作,对多张源表选择同一张目的地表,一次性完成多对一配置,并且在该页面更直观地展示了多对一关系。
同时支持在数据映射页面配置一条映射的字段映射关系并根据源表字段匹配将该映射规则应用于其他表映射,大大减少了用户的操作步骤。
优化 TiDB TiCDC 读取方式节点配置
功能背景
在过去的版本中,DataPipeline 支持了通过读取 TiDB TiCDC 程序向消息队列缓存的增量数据的方式获取 TiDB 增量数据。但在实际配置与管理过程中,DataPipeline 并未提供页面化的 TiCDC 程序配置,导致配置过程割裂,用户操作与体验十分不友好。
使用场景
在 TiDB 作为上游数据源的场景中,有大量的数据表需要同步,通过 DataPipeline 可视化的同步配置即可将 TiCDC 配置、DP 任务配置结合在一个平台中管理,方便用户使用。
优化任务执行配置
功能背景
当前 DP 的任务执行已经支持对于同步方式,执行方式,同步起点进行设置。,可以通过 where 条件或者配置数据映射实现行过滤和列过滤。但是对于增量场景中,无法实现范围同步。这对于类似电信行业,金融行业,有月结,年结诉求的,且全量数据巨大的场景,将无法实现准确的数据分析。因此在 3.4 版本中,结合实际业务场景,增加同步终点的设置从而满足电信和金融行业的实际应用场景。
使用场景
当任务配置为,增量监听模式时,支持通过日志解析,配置同步终点,从而实现日志读取的范围同步。
| 同步方式 | 执行方式 | 行过滤 | 列过滤 | 复杂条件 | 同步范围 |
|---|---|---|---|---|---|
| 全量同步 | 定时 | where 条件过滤 | 数据映射配置 | 高级清洗 | -- |
| 增量同步 | 定时 | where 条件过滤 | 数据映射配置 | 高级清洗 | -- |
| 监听 | 目前不支持,只能在高级清洗设置 | 数据映射配置 | 高级清洗 | 起点+终点 |
功能说明
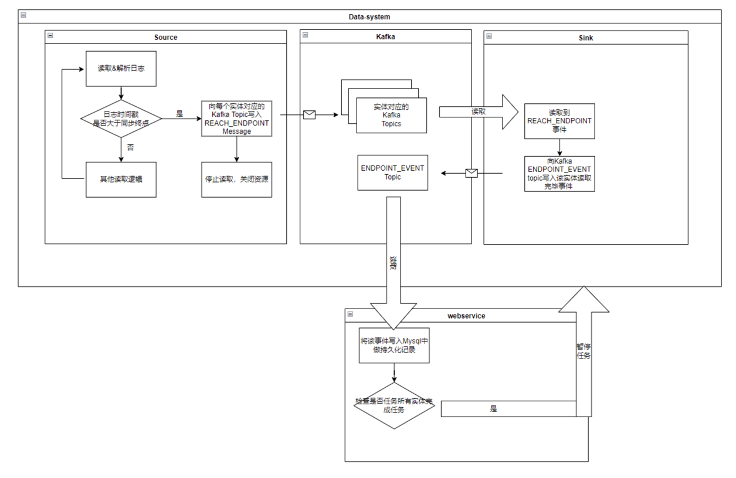
当读取到达同步终点时,暂停读取,将所有缓存数据写入后,任务暂停,从而保障写入到下游的数据,不会丢数据也不会出现重复数据。
细化节点、链路、任务的操作权限(编辑/查看)
功能背景
在之前的版本中,DataPipeline 支持了基于用户组的使用权限区分,对于数据链路、数据节点、数据任务均可分别添加参与人控制谁能使用
使用场景
在多团队使用 DataPipeline 产品的场景中,不同团队使用的负责的业务方向不同,但组织内数据流转信息也需要一定透明。
因此区分链路、节点、任务等逻辑概念的编辑与查看/使用权限应运而生。
功能说明
在链路、节点、任务基本信息中,您可添加编辑参与人或查看参与人,以控制各实体的细分权限。
Kafka 数据目的地写入数据格式优化
功能背景
3.4.5 版本针对往期版本 Kafka 数据格式定义进行了优化,系统支持通过页面配置写入 Kafka 目的地的信息。当数据源节点类型为 ORACLE、Mysql 时,支持采集数据源更丰富的元数据信息,且支持采集数据 before 信息。数据格式适配 ORACLE GoldenGate 写入 Kafka 数据格式,降低了替换 ORACLE GoldenGate 技术成本。
使用场景
用户需要将更丰富的元数据信息以及数据变更前的内容写入 Kafka 目的地,或替换 OGG 的场景。
功能说明
当 ORACLE 节点的读取方式为:DataPipeline Oracle 采集代理,LogMiner,IBM InfoSphere Data Replication 时,支持采集 ORACLE rowid、before 信息。当 Mysql 节点的读取方式为 BINLOG 时,支持采集 gtid、position、before 信息。\
其他优化与问题修复
- 优化错误队列数据清除策略
- 新增支持读取 gz 格式压缩文本文件
- 新增支持注释映射与注释配置
- 优化文件读取分隔符配置
- 优化数据映射元数据刷新逻辑
- 新增支持 Hive SQL 引擎配置
- 优化日志查看、筛选组件,提供日志下载功能
- 修复部分已知问题