V3.3 新版本说明
正文
燕山雪花大如席,片片吹落轩辕台。DataPipeline 在 12 月迎来了 V3.3 版本更新。
版本目标
- 多元异构与国产信创支持
- 全面增强链路映射配置
在 3.3 版本中,我们围绕着多元异构与国产信创支持、全面增强链路映射配置两个版本目标,新增支持了 MongoDB 数据节点、OceanBase 数据节点、HBASE 数据目的地、API 数据源、SFTP 数据节点、AWS PostgreSQL RDS 数据节点,Oracle 数据库日志解析采集代理程序推出集中管理的新版本,对操作审计日志功能进行了优化;同时,对最经常使用的数据链路映射配置功能进行了全面增强。
多元异构与国产信创支持 新增功能:MongoDB 数据节点
功能背景
MongoDB 是一个基于分布式文件存储的数据库,旨在为 WEB 应用提供可扩展的高性能数据存储解决方案。在 2021 年 4 月数据库流行度排行中,MongoDB 位列第五,在 NoSQL 中位列第一。近几年内在国内发展迅速,在金融领域,中国银行、招商银行以及太平洋保险、泰康等这些头部金融行业,都开始使用 MongoDB,在很多公有云平台,MongoDB 也成为除了 MySQL 之外使用最广泛的一个数据库之一。
使用场景
- 支持通过 MongoDB Java Drivers 定时增量读取和定时全量读取源端数据。
- 支持通过 Change Streams 订阅集合上所有数据的更改来实时读取增量数据。
- 支持通过 MongoDB Java Drivers driver 将数据写入目的地端。
功能说明
- 支持通过 MongoDB Java Drivers 连接到 MongoDB 节点进行数据的采集/写入并进行可用性校验;
- 支持 MongoDB 节点相关语义映射:
- 支持 MongoDB 节点相关的默认 mapping;
- 支持配置 MongoDB 节点相关的字段类型、索引、特性映射;
- 支持新建 MongoDB 节点作为数据源/目的地的链路:
- 支持通过 Change Stream 的方式实时读取 MongoDB 数据源的增量数据;
- 支持通过固定结构、无结构的两种方式解析 MongoDB 数据源的集合;
- 支持 MongoDB 目的地通过新建表和选择已有表的方式完成表映射;
- 支持配置 MongoDB 节点作为源/目的地相关表映射以及字段映射;
- 支持 MongoDB 节点作为数据源/目的地的结构变化策略;
- 支持 MongoDB 节点作为数据源/目的地的数据加载策略;
- 支持新建 MongoDB 节点作为数据源/目的地的任务:
- 支持 MongoDB 节点作为源的全量同步/增量同步;
- 支持 MongoDB 节点全量初始化、清空目的地功能;
- 支持 MongoDB 节点作为源/目的地的重新同步并情况目的地功能。
多元异构与国产信创支持 新增功能:OceanBase 数据节点
功能背景
- OceanBase 数据库是阿里巴巴和蚂蚁集团不基于任何开源产品,完全自研的原生分布式关系数据库软件,在普通硬件上实现金融级高可用,兼容 MySQL 模式与 Oracle 模式,具有高可用可扩展的业务连续性、应用易用性、低成本、低风险的特点。在客户的各类系统中应用广泛。
使用场景
- OceanBase 目前支持 2.2.x 与 3.x 版本,在 DataPipeline 3.3 版本中可作为数据源和数据目的地使用。
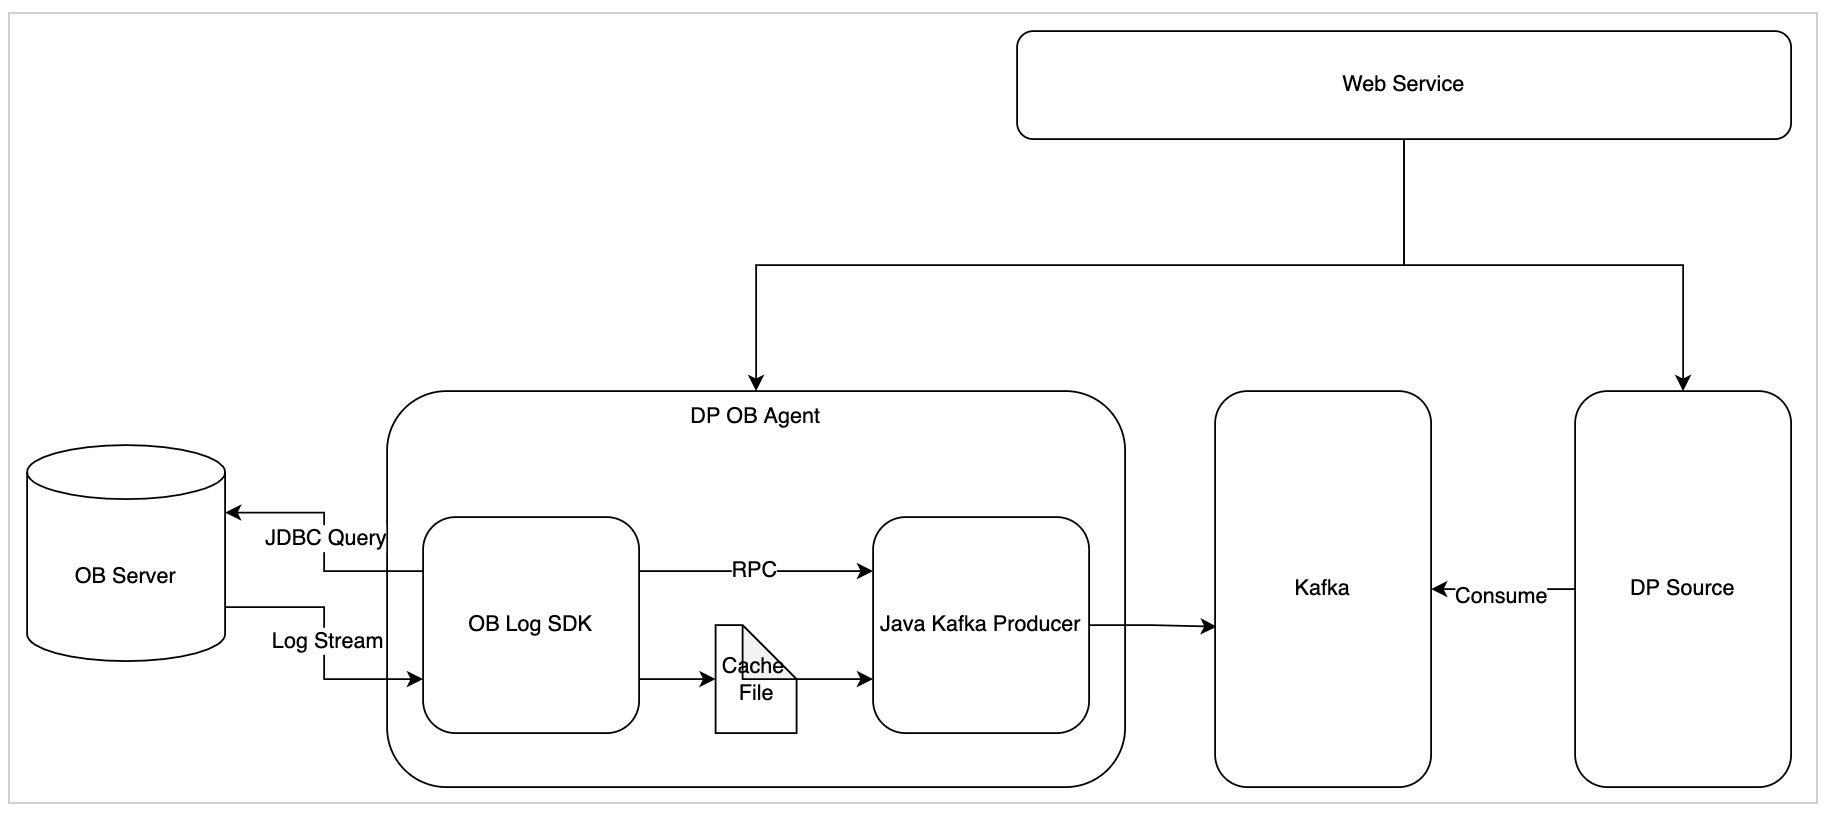
- 作为源使用,可以使用 ObLog Reader,JDBC 的读取方式,将增量和全量数据写入到 MySQL、MS SQL Server、Oracle、PostgreSQL、Apache Kafka、IBM Db2、Open Gauss、Gauss 200、FTP、HDFS、Hive、Inceptor、MaxCompute、TiDB、SequoiaDB、Redis、TelePG 等。
- 作为目的地使用,可以使用 JDBC 写入方式,将源端的增量和全量数据写入到 OceanBase 目的地。
功能说明
- 支持通过 ObLog Reader,JDBC 连接到 OceanBase 节点进行数据的写入并进行可用性校验;
- 支持 OceanBase 节点相关语义映射
- 支持 OceanBase 节点相关的默认 mapping;
- 支持配置 OceanBase 节点相关的字段类型、索引、特性映射;
- 支持新建 OceanBase 节点作目的地的链路:
- 支持配置 OceanBase 节点作为目的地相关表映射以及字段映射;
- 支持 OceanBase 节点作为数据目的地的结构变化策略;
- 支持 OceanBase 节点作为数据目的地的数据加载策略;
- 支持新建 OceanBase 节点作为目的地的任务:
- 支持 OceanBase 节点作为目的地的重新同步并清空目的地功能。
使用 ObLog Reader 采集 OceanBase 实时数据,系统架构如下:
多元异构与国产信创支持 新增功能:HBASE 数据目的地
功能背景
- hbase 是分布式可扩展、面向列的开源数据库,支持海量数据存储和计算,在需要实时读写、随机访问超大规模数据集时,可以使用 HBase。利用 HBase 可以在廉价 PC server 上搭建起大规模结构化存储集群。HBase 被广泛应用于大数据存储解决方案中。
- Hadoop HDFS 为 HBase 提供了高可靠性的底层存储支持,Hadoop MapReduce 为 HBase 提供了高性能的计算能力,Zookeeper 为 HBase 提供了稳定服务和 failover 机制。
使用场景
- hbase 目前发布了 1.x 和 2.x 版本,datapipeline3.3 版本支持将 hbase1.x 和 2.x 版本作为目的地使用。
- 作为目的地使用,datapipeline3.3 版本支持 Hbase 客户端写入方式,将源端的增量和全量数据写入到 Hbase 目的地。
功能详情
- 支持通过 JDBC 连接到 HBase 节点进行可用性校验;
- 支持通过 Hbase 客户端方式连接到 Hbase 节点进行数据写入。
- 支持新建 HBase 节点作目的地的链路:
- 支持配置 HBase 节点作为目的地相关表映射以及字段映射;
- 支持通过高级清洗对 Hbase RowKey 进行写入;
- 支持 HBase 节点作为数据目的地的结构变化策略;
- 支持 HBase 节点作为数据目的地的数据加载策略。
- 支持新建 Hbase 节点作为目的地的任务:\
- 支持 Hbase 节点作为目的地的重新同步并清空目的地功能。
多元异构与国产信创支持 新增功能:SFTP 数据节点
功能背景
sftp 是 Secure FileTransferProtocol 的缩写,安全文件传送协议。可以为传输文件提供一种安全的加密方法。SFTP 是使用加密传输认证信息和传输的数据,所以,使用 SFTP 是非常安全的。在很多对网络安全性要求更高客户场景中,需要使用到 SFTP 代替 FTP。
使用场景
- 支持通过 FTP 客户端进行文件读取,支持读取 CSV、Json 类型文件的定时全量读取,并支持定义带参数的源表,且支持定时读取该源表中的增量文件;
- 支持通过 FTP 客户端进行文件写入,支持将源端数据写入 FTP 目的地端的 CSV、Json 类型文件,并且支持写入动态文件目录;
- 支持配置读取标志文件来控制读取逻辑。
功能说明
- 支持通过 JDBC 连接到 SFTP 节点进行数据的采集/写入并进行可用性校验;
- 支持 SFTP 节点相关语义映射
- 支持 SFTP 节点相关的默认 mapping;
- 支持配置 SFTP 节点相关的字段类型、索引、特性映射;
- 支持新建 SFTP 节点作为数据源/目的地的链路:
- 支持配置 SFTP 节点作为源/目的地相关表映射以及字段映射;
- 支持 SFTP 节点作为数据源/目的地的结构变化策略;
- 支持 SFTP 节点作为数据源/目的地的数据加载策略;
- 支持新建 SFTP 节点作为数据源/目的地的任务:
- 支持 SFTP 节点作为源的全量同步/增量同步;
- 支持配置读取标志文件来控制读取逻辑;
- 支持 SFTP 节点全量初始化、情况目的地功能;
- 支持 SFTP 节点作为源/目的地的重新同步并情况目的地功能。
多元异构与国产信创支持 新增功能:API 数据源
功能背景
- 全球有 2000 万以上的开发者、超过百亿的 API。所有的应用程序,均需要通过 API 进行数据通讯,因此 API 是所有数据交互的关口。同时 API 也企业核心的数字资产,是企业数据和服务输出和获取的唯一渠道。API 节点的实现将增强产品多元异构的特性,满足更多用户复杂场景;
使用场景
- 支持请求返回格式为 XML、TEXT、JSON 的 API,并按照样例文件解析出字段来进行字段映射,并且支持用参数的形式定义 URL、Params、Headers、Body。
功能说明
- 支持连接到 API 节点进行数据的采集并进行可用性校验
- 支持请求方式:GET、POST、PUT、DELETE、PATCH
- 支持分页 API 读取
- 支持认证方式:Basic auth
- 支持返回格式:XML、TEXT、JSON
- 支持新建 API 节点作为数据源的链路
多元异构与国产信创支持 功能优化:操作审计日志功能增强
功能背景
- 在之前的版本中,DataPipeline 支持了数据节点、链路、任务的配置变更、状态变更、高风险操作等种类的日志页面查看,但这些审计日志是分布在每个逻辑概念详情页-日志查看中的,在进行行为审计过程中很不方便。
使用场景
- 在行为审计过程中,通过系统审计日志页面,查看数据节点、链路、任务的配置变更、状态变更、高风险操作等审计日志。
功能说明
- 在系统日志页面,通过筛选操作审计日志,查看所有节点、链路、任务、系统配置的审计日志。
- 已被删除的数据节点、链路、任务的也可以通过系统日志页面查看。\
多元异构与国产信创支持 新增功能:AWS PostgreSQL RDS 数据节点
功能背景
- AWS RDS for PostgreSql 是亚马逊提供的云化 PostgreSql 数据库节点,支持 PostgreSQL 核心引擎功能。
使用场景
- Amazon RDS 目前支持 PostgreSQL 9.6、10、11 和 13 版本,在 3.3 版本中可作为数据源和数据目的地使用。
- 作为源使用,可以使用 Wal2json,JDBC 的读取方式,将增量和全量数据写入到 MySQL、MS SQL Server、Oracle、PostgreSQL、Apache Kafka、IBM Db2、Open Gauss、Gauss 200、FTP、HDFS、Hive、Inceptor、MaxCompute、TiDB、SequoiaDB、Redis、TelePG 等。
- 作为目的地使用,可以使用 JDBC 写入方式,将源端的增量和全量数据写入到 AWS RDS for PostgreSql 目的地。
功能说明
- 支持通过 JDBC 连接到 AWS RDS for PostgreSql 节点进行可用性校验;
- 支持通过 JDBC、Wal2json 连接到 AWS RDS for PostgreSql 节点进行数据读取,支持通过 JDBC 连接到 AWS RDS for PostgreSql 节点进行数据写入。
- 支持 AWS RDS for PostgreSql 节点相关语义映射
- 支持 AWS RDS for PostgreSql 节点相关的默认 mapping;
- 支持配置 AWS RDS for PostgreSql 节点相关的字段类型、索引、特性映射;
- 支持新建 AWS RDS for PostgreSql 节点作目的地的链路:
- 支持配置 AWS RDS for PostgreSql 节点作为目的地相关表映射以及字段映射;
- 支持 AWS RDS for PostgreSql 节点作为数据目的地的结构变化策略;
- 支持 AWS RDS for PostgreSql 节点作为数据目的地的数据加载策略;
- 支持新建 AWS RDS for PostgreSql 节点作为目的地的任务:\
- 支持 AWS RDS for PostgreSql 节点作为目的地的重新同步并清空目的地功能。
全面增强链路映射配置 数据映射功能全面增强
功能背景
在经历了 V3.1 版本的批量设置后,我们收到了一些反馈。该功能最直接的目的是为了提升产品的易用性,因此我们继续以提升易用性为目标,对易用性做了进一步的提升和改进。
本版本是 V3.3 版本中易用性优化的一个里程碑版本,在 DataPipeline 的产品中,数据链路是最为复杂的一部分。因此提升其易用性,也会极大的优化产品的体验。并且本版本制定了批量的模板,后续新的节点都可以套用该模板,针对规则进行设置,执行规则即可将原来繁复的建立数据映射的工作一键完成。同时增加了检查,将一些链路上的错误和警告,前置反馈给用户,提升了交互性,避免用户在无法获取到链路异常状态的情况下,继续做数据任务的同步。导致整个异常问题以执行任务报错为代价反馈。
使用场景
- 基于某个规则向目的地批量创建新表,或者匹配已有表,一键完成映射初始配置
- 批量修改数据映射
- 检查数据映射中的一些配置错误并提前反馈,进行修复
功能说明
- 将原有的批量拆解成了规则+操作两个部分。
- 拆分出规则后,您就可以在在配置好一个规则后,直接选表即可完成表的创建或者匹配工作。避免了大量的重复选表和建表工作
- 扩大了支持的范围,上一个版本批量还不支持文件,以及一些新增节点的设置,诸如 maxcompute,hdfs,ftp 等节点都无法支持批量设计,这里通过提炼出规则,可以对于所有的节点进行操作。
- 增强了匹配已有表的场景,上一个版本批量的场景支持有限,比如对于已有表的匹配规则,只能支持名称全匹配,不支持前缀,后缀,或者字符替换等模式。本版本对于已有表以及字段的匹配功能进行了加强
- 增加了链路的配置检查,过往使用中,软件产品由于提升了灵活度,这导致设置的时候,缺乏足够的限制。也会给一些不熟悉产品的用户带来困扰。这次特别对数据链路中一些问题做了提前的预警。采用警告和错误两个级别提示用户对映射进行核查及修复,帮助用户可以尽早知道链路设置的问题,避免问题后置,任务启动中才暴露问题。
- 对于映射的操作粒度,在 V3.3 版本之前,删除只能整条映射删除。但是用户有时候有保留源表,删除目的地表重新匹配的需求,因此本版本增加了该功能,并且可以提供批量删除,提升易用性
- 优化了保存按钮,并将检查的提示一同悬浮在界面固定位置,方便用户实时查看到链路状态。
- 优化交互,对于一些常见的操作比如增加前缀,后缀的操作,可以通过界面直接配置,使用户更加轻易的对所选映射进行编辑和修改。
- 高级清洗的优化,原有的高级清洗批量操作里只能选择已有的高级清洗脚本,本次更新内容除了可以选择已有高级清洗脚本,还可以选择创建一个新的高级清洗脚本,减少用户的操作路径。
\
\